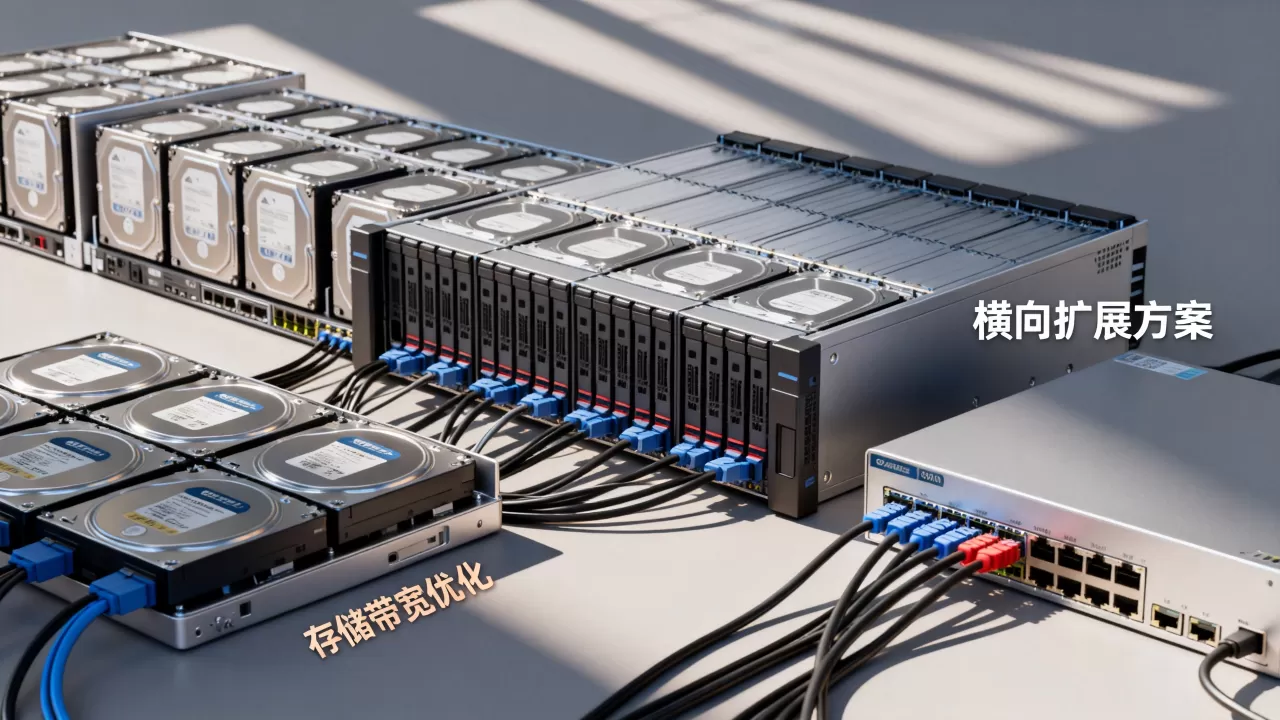
当存储带宽成为瓶颈时,横向扩展是更优解:通过增加独立节点分摊I/O压力,比单纯升级单机硬件更治本、更具性价比。
怎么判断存储带宽瓶颈真的存在,而非其它环节拖后腿
很多团队一遇到存储变慢,就把责任推给带宽,结果横向扩展后发现毫无改善,先做诊断比急着扩容更重要。

三个“案发现场”观察法
- 在业务低峰期,用
iostat -x 1观察await和%util,若%util长期接近100%,但svctm很低,多数时候是队列堆积,指向带宽或控制器能力不足。 - 用
dstat -n和iftop对比网络流量与磁盘吞吐,若网卡跑满但磁盘利用率不到60%,说明瓶颈在传输链路,也就是带宽。 - 直接测读写混合场景,运行
fio --rw=rw --bs=128k --numjobs=4,对比单线程与多线程的吞吐差异,多线程吞吐线性增长但单线程卡死,通常不是带宽问题,而是锁竞争或文件系统元数据瓶颈。
别混淆“带宽不足”和“延迟高”
带宽是泳池的宽度,延迟是泳道里游泳的速度,横向扩展解决的是“同时很多人挤在一个入口”,不是“每个人游得慢”,若延迟高但带宽余量充足,优先优化存储网络协议或更换SSD介质,而不是加节点。
横向扩展和纵向扩展哪个好:关键看瓶颈的性质
行业共识认为,纵向扩展适合延迟敏感、数据强一致性要求极高的事务型数据库;横向扩展适合吞吐密集、海量小文件、视频或备份等场景。
纵向扩展的“天花板”与成本失衡
- 单机存储控制器的PCIe通道数量有限,内存通道和网卡插槽也有上限,当带宽需求超过单机上限制时,即便换最强的硬件,成本也会指数级上升。
- 换上更高带宽网卡或NVMe磁盘,往往还要配合新的驱动、固件和操作系统调优,实际收益远低于纸面参数。
- 更现实的问题是,单机升级需要停机维护窗口,对在线业务不友好。
横向扩展的本质:把“单车道”变成“多车道”
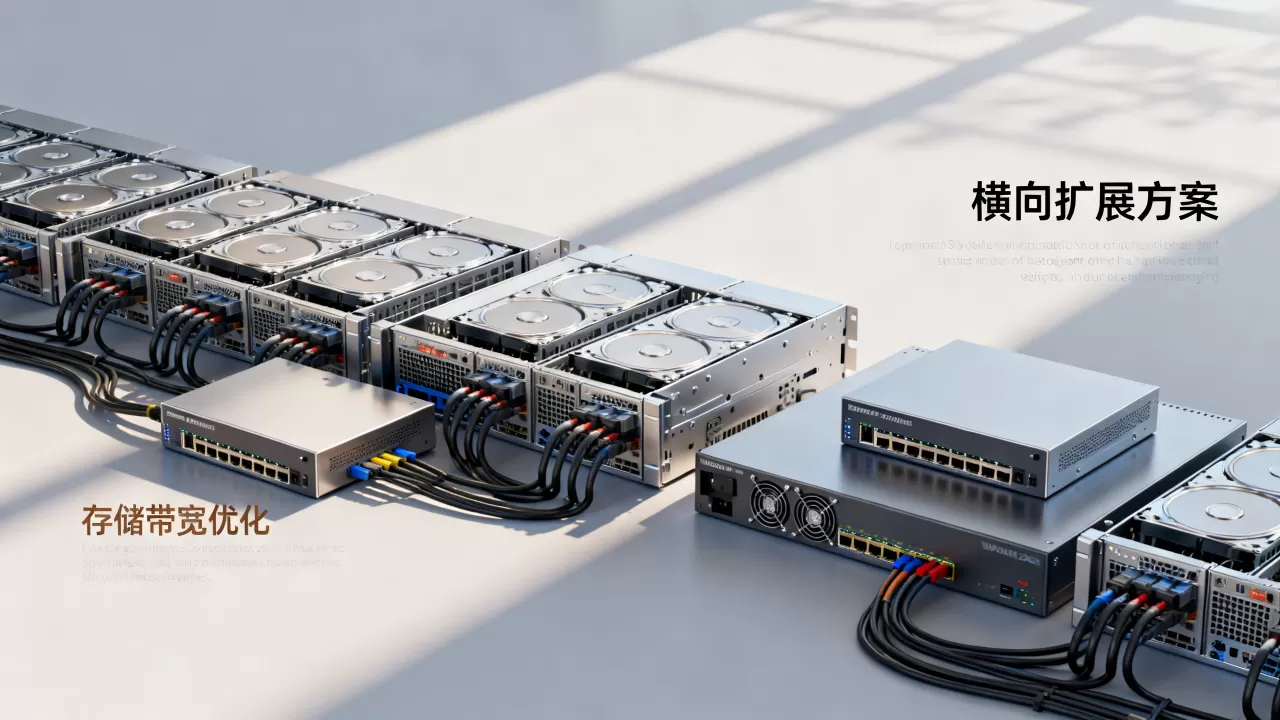
横向扩展的每一台节点都独立拥有CPU、内存、网卡和磁盘,数据分片后,每个节点只负责一部分数据的读写,总带宽等于所有节点带宽之和,以分布式存储系统Ceph为例,增加OSD节点后,客户端通过CRUSH算法将请求分散到不同OSD上,聚合吞吐线性提升。
- 扩展过程中无需停止业务,节点可在线加入,数据自动重新平衡。
- 单个节点故障,其它节点接管数据,反脆弱性更强。
- 成本随业务增长按需增加,不像纵向扩展一次性大额投入。
存储带宽瓶颈怎么解决:三种主流横向扩展架构实操
根据存储类型选择不同的扩展方式,不要拿着块存储的方案去套文件存储。
块存储:用分布式块设备把带宽“接”出来
以云平台常见的Ceph RBD为例,当单个RBD镜像的带宽达到约1GB/s的瓶颈时,按以下步骤扩展:
- 在新机器上安装Ceph客户端,配置
ceph.conf的服务端IP。 - 将新节点加入集群,执行
ceph orch apply osd --placement=my-new-node-1。 - 针对具体RBD设备,利用
rbd feature disable关闭不支持的特性,然后通过rbd resize扩大容量。 - 在客户端使用
multipath挂载多个活跃路径,使I/O交替走多个OSD组。
注意:块存储的横向扩展要避免“跨节点读遥”现象,让数据分布与物理节点对齐,否则带宽会被内部复制流量吃掉。
文件存储:共享命名空间下的带宽池化
NAS场景中,横向扩展通常采用集群文件系统,如GlusterFS或Lustre,以GlusterFS为例,增加带宽最直接的方式是增加Brick,并重新配置分布式卷。
- 原有卷类型为Distribute时,直接执行

gluster volume add-brick gv1 new-server:/data
- 如果原卷是Replica,需要同时增加一个副本Brick,否则元数据不一致。
- 扩展后,客户端需要重新挂载或刷新DNS缓存,以拿到新的拓扑。
关键点:文件存储的带宽瓶颈经常出现在元数据服务上,若只有数据节点扩展而元数据节点不变,性能依然会被锁死,建议将元数据服务单独部署到低延迟NVMe节点,并确保其网络带宽不低于数据节点的聚合带宽。
对象存储:最简单的横向扩展逻辑
对象存储天生适合横向扩展,因为其扁平化命名空间和无目录结构消解了元数据冲突,以MinIO为例,带宽不足时,增加新的存储节点并执行mc admin add,然后将多个节点组成一个纠删码集合。
- MinIO会按照擦除码分布数据,读请求自动路由到负载较轻的节点。
- 客户端侧建议使用multi-threaded transfer工具,如
s5cmd,并行上传下载以充分利用所有节点带宽。 - 对于视频监控或备份场景,将对象大小拆分到1-4MB分片,每个分片分散到不同节点,聚合带宽可提升数倍。
横向扩展的代价与避坑指南
横向扩展并非免费午餐,很多部署在半年后反而变慢,原因是以下三个暗坑。
复制流量挤占有效带宽
分布式存储为了保证冗余,数据会写多份或使用纠删码,每增加一个节点,内部复制流量也会增加,当节点数超过10个时,跨机架复制可能占用30%以上的网络带宽,解决方法是使用专用后端网络,或将副本策略改为纠删码(如8+2),减少冗余开销。
小文件场景的“元数据风暴”
如果业务平均文件大小不足64KB,带宽瓶颈会迅速从数据流转移到元数据操作,横向扩展时,每个节点都要处理大量list和stat请求,反而比单机更慢,此时优先优化目录结构,将小文件合并为大的容器文件,或引入独立的元数据缓存层。
客户端负载均衡策略没跟上
节点增加了,但客户端依然将请求发送到旧节点,导致新节点闲置,需要检查存储系统自带的客户端均衡策略。
- Ceph的librbd默认会动态调整,但老版本可能需要手动更新
scheduler tick。 - NFS over RDMA集群,确保mount选项中的
nconnect参数大于1。 - 使用自定义SDK时,务必重新获取集群拓扑并实现加权轮询。
常见问题快答
存储带宽瓶颈怎么解决能让现有投资不浪费?
先确认瓶颈在数据路径还是控制路径,若数据路径带宽不足,可以在原有存储阵列上增加扩展柜或新增存储节点,利用多路径I/O聚合带宽,若控制路径(如元数据服务)受限,则单独扩展元数据服务器,无需更换所有数据盘。
横向扩展和纵向扩展哪个好,具体到数据库场景?
对于MySQL这类强一致数据库,纵向扩展(升级CPU、内存、购买更高配置独享型服务器)更稳妥,因为横向扩展需要分库分表,应用层改造成本高,对于HBase或ClickHouse这类分布式数据库,横向扩展是标配,因为数据天然分片,判断标准是:应用能否接受数据跨节点查询,若能,则横向扩展;若不能,则纵向扩展。
分布式存储带宽不足时,增加节点后为何没有明显提升?
先检查新节点是否真正加入了数据分布映射,Ceph中执行ceph osd tree,确认新OSD的权重不为0,观察客户端是否与所有OSD建立了TCP连接,ss -s可查看连接数,确认网络交换机没有启用风暴控制或QoS限速,多数情况下,节点加了但未触发数据重平衡,带宽自然没变化,需手动执行ceph osd reweight或gluster volume rebalance,等待数据迁移完成后才能看到效果。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/621296.html