显存装不下大模型,先别急着换卡,切分部署才是性价比之王
当单卡显存装不下模型权重时,最直接的解法不是买更贵的卡,而是把模型按层或按张量切到多张卡上,通过流水线并行或张量并行来跑推理和训练。 这套思路业内已经跑通多年,从百亿到千亿参数都能落地,关键是你得搞清楚自己的瓶颈在哪,再选对切分方式。
模型切分部署到底是什么,为什么能绕开显存墙
显存容量约束是本地部署大模型绕不过去的坎,一张消费级显卡普遍只有16G到24G显存,而一个7B参数的模型,光权重就要占14G左右,加上激活值和KV Cache,单卡根本塞不下,遇到“大模型显存不够怎么办”这类问题,很多人第一反应是上云或者买专业卡,但成本太吓人。
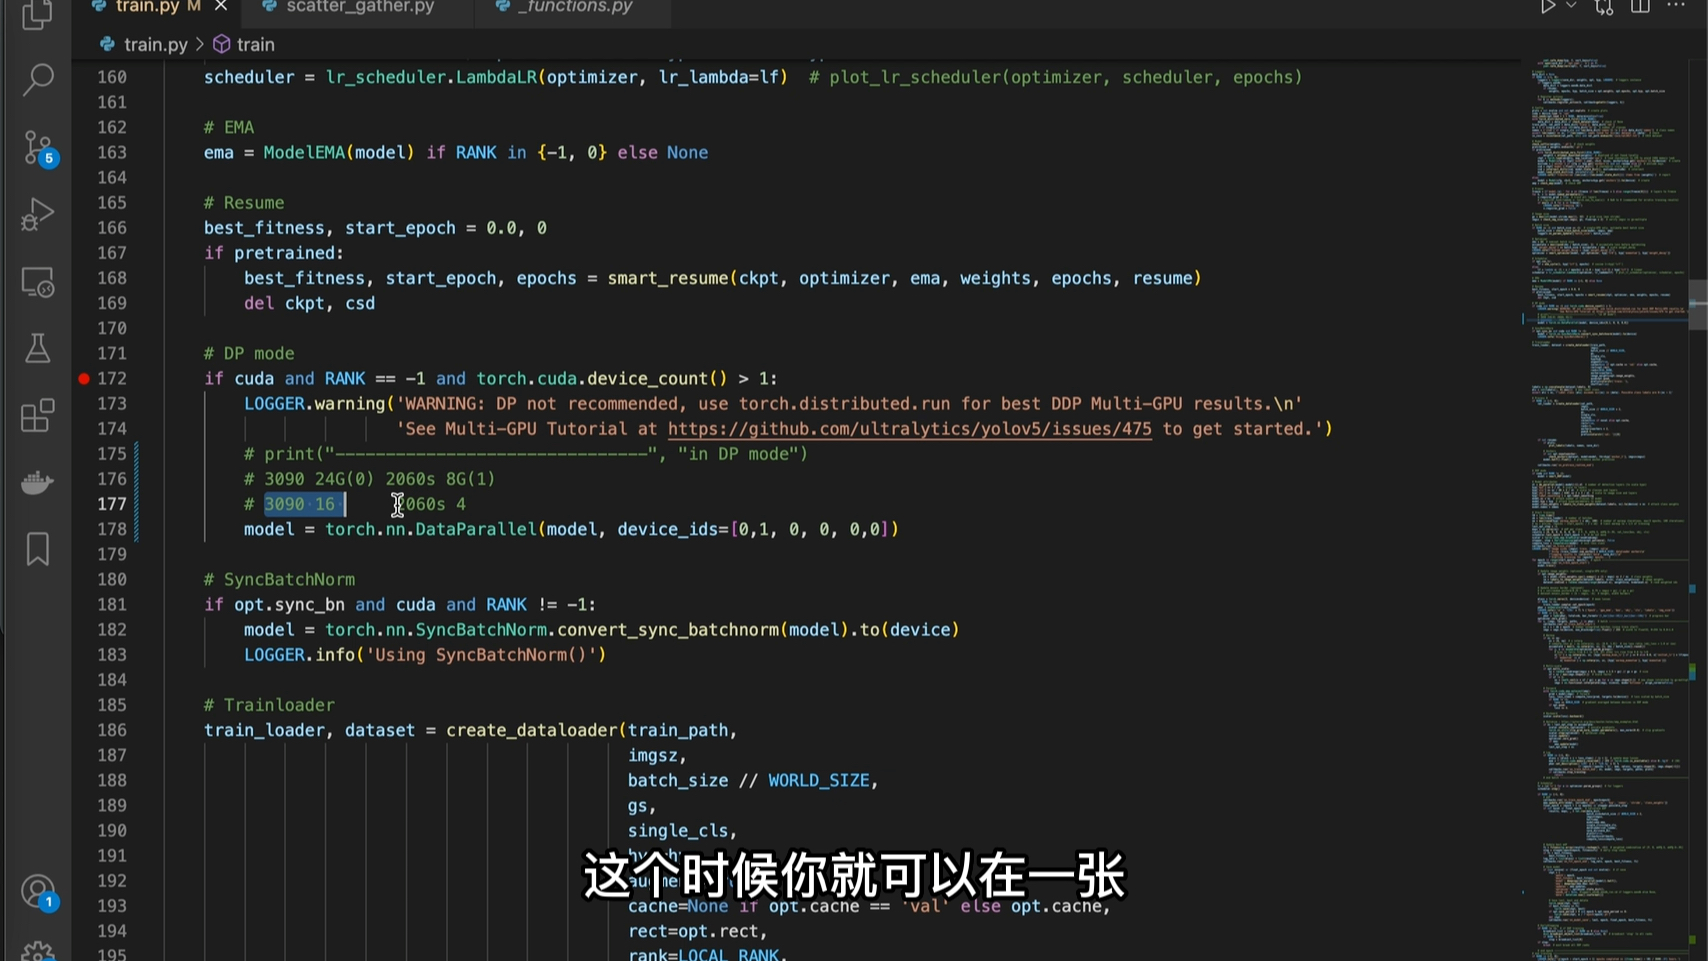
其实模型本身就是一堆矩阵运算,拆开放在多张卡上并行计算完全可行,业内把这种做法叫模型并行,最常见的两种拆法:
- 张量并行:把一层的权重矩阵横着切,多张卡各算一部分,最后拼起来,适合卡间通信快的情况,比如同一台服务器里的多卡。
- 流水线并行:按层切,第一层到第十层放卡A,第十一层到第二十层放卡B,数据像流水线一样流过各卡,适合跨机器部署,通信压力小。
实际操作中,大多数框架都会把两者混着用,比如一张卡放几层,每层内部再横向切开,这样能在通信成本和显存利用率之间找到平衡点,行业共识认为,切分部署的核心价值不是提升算力,而是把显存容量池化,让多张卡的显存加起来等于一张大卡。
模型切分部署方案对比:哪种适合你的场景
选方案前必须摸清自己的家底,下面这张表是我总结的常见切分思路,照着对号入座就行。
| 方案类型 | 切分粒度 | 显存要求 | 通信需求 | 适合场景 |
|---|---|---|---|---|
| 流水线并行 | 按层切 | 每卡能装下若干层 | 低,只需传激活值 | 跨机器、千兆网 |
| 张量并行 | 按权重行/列切 | 每卡装下部分权重 | 极高,需要NVLink | 单机多卡、高端显卡 |
| 数据并行 | 不切模型,复制权重 | 每卡装下完整模型 | 低,只同步梯度 | 微调、多卡训练 |
如果你的显卡比较老,比如两张2080Ti,只有22G显存,想跑7B模型,用流水线并行最稳妥,层切之后每张卡只放一半权重,激活值也分摊了,基本能跑起来,就是速度慢点。
如果手里是两张4090,那就大胆上张量并行,4090之间的PCIe带宽虽然不及NVLink,但7B模型规模不大,通信延迟可以接受,业界测试表明,张量并行在小规模模型上比流水线快不少,因为不用等上一层算完再动。
本地部署模型显存要求怎么算
很多人问“本地部署模型显存要求”到底怎么估,我给出一个保守公式:
模型权重显存 = 参数量 × 2字节(FP16)
7B模型就是14G,13B就是26G,在此基础上还要预留激活值和计算缓存的空间,推理时大约再加20%到50%,如果是训练或微调,还得额外算优化器状态和梯度,那就要3到4倍的权重显存了。
这也是为什么有些量化模型能在8G显存上跑7B权重用INT4量化后只要3.5G,代价是精度掉一点,切分部署和量化并不冲突,量化压缩单卡占用,切分解决总量不够,两个叠着用能榨干所有显存。
手把手实操:用Transformers + Accelerate做流水线切分
这里给出一个能直接跑的路径,硬件是两张16G显卡,目标跑7B模型,用HuggingFace生态的工具链。
第一步,安装依赖
pip install transformers accelerate torch
第二步,写一个简单的设备映射脚本
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
model_name = "meta-llama/Llama-2-7b-chat-hf"
device_map = {
    "model.embed_tokens": 0,
    "model.layers.0": 0,
    "model.layers.1": 0,
    "model.layers.2": 0,
    "model.layers.3": 1,
    # 这里按你的显卡数把层均分
    "model.layers.31": 1,
    "model.norm": 1,
    "lm_head": 1
}
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map=device_map,
    torch_dtype=torch.float16
)
tokenizer = AutoTokenizer.from_pretrained(model_name)
Accelerate库会自动识别device_map里的显卡编号,把对应层放到对应显存上,对于超过两层以上的模型,你可以用循环自动生成映射,不用手写每一层,实际操作中,我用infer_auto_device_map函数自动切分,省事很多:
from accelerate import infer_auto_device_map
device_map = infer_auto_device_map(model)
注意,自动映射不一定最优,有时候它会把某些大层塞进显存不够的卡里导致OOM,这时就得手动把那一层挪到别的卡上。
第三步,运行一个短测试
input_text = "写一首关于秋天的诗"
inputs = tokenizer(input_text, return_tensors="pt").to(0)
outputs = model.generate(inputs, max_new_tokens=100)
print(tokenizer.decode(outputs[0]))
跑通这条路,你就已经完成了基本的切分部署,多卡显存分配这一块,Accelerate的日志会显示每张卡的使用率,你可以根据日志微调设备映射。
多卡推理显存分配的正确思路
切分部署不是把模型扔上去就完事,显存分配直接决定你能跑多长上下文,推理时显存占用分三块:
- 权重:固定不变,按切分方式分摊到各卡。
- KV Cache:随着生成长度线性增长,每多一个token,每层都要存一组Key和Value向量。
- 激活值:前向计算产生的中间状态,对显存要求较高,张量并行下会切分得比较碎。
不少人在7B模型上把max_new_tokens设到4096,结果显存爆了,这不是模型切分的锅,是没算好KV Cache的增量,一个简单的估算:每层KV Cache占用 = 2 × 序列长度 × 隐藏维度 × 2字节,对于7B模型,隐藏维度4096,40层,那么单token的KV Cache总量大约是40 × 4096 × 2 × 2 = 1.3MB,生成4096个token,就需要约5G额外显存。
多卡推理显存分配要预留这部分空间,如果你的目标是长文本生成,建议用下面这个分配公式:
每卡显存需求 = 模型权重切分后大小 + 激活值预留(约2G) + KV Cache按序列长度均摊
实际操作时,先在每卡留下20%的冗余空间,然后测试不同max_new_tokens下的显存变化,找到不OOM的边界值。
张量并行对比流水线的实际选择
如果你有NVLink连接的多卡,比如两张3090组NVLINK,那张量并行的速度优势非常大,因为每层计算时卡间要同步多次梯度或中间结果,普通PCIe带宽会成为瓶颈,业内专家指出,在PCIe 4.0 x16的环境下,张量并行的扩展效率会掉到70%左右,而NVLink能把损失压到10%以内。
反过来,如果你只是两台机器各有一张卡,中间走万兆网络,那流水线并行几乎是唯一选择,层切后每张卡只需要把最后一层的输出传给下一台机器,通信频率低,延迟影响不大。
有一个实操经验:两张卡跑7B以下模型,无脑选张量并行;两张卡跑13B以上模型,优先流水线并行,或者混合切,因为大模型的单层权重很大,张量并行需要频繁同步,网络开销会盖过算力收益。
显存不足时从切分到量化的完整路径
切分是手段,不是目的,如果切完还是跑不动,那就再加一道量化,具体的优化路径分四步走:
- 先做模型量化,把FP16权重转成INT8或INT4,这一步能让权重显存直接砍半或砍到1/4,很多原本切不开的模型一下就塞得下了。
- 再决定切分方式,量化后单卡能装下就优先考虑张量并行,装不下就用流水线并行。
- 调整上下文长度,把max_new_tokens限制在合理范围,别让KV Cache吃掉所有冗余。
- 使用offload,如果还有个别层放不下,可以把它们放到内存里,需要计算时再临时搬到显存,慢但能跑。
这条路径在AMD显卡上也能走通,只要用ROCm版的PyTorch配合HuggingFace生态,切分逻辑和NVIDIA卡完全一样,唯一的坑是部分算子和库对ROCm支持不完善,遇到兼容性报错时,把torch和transformers版本升到最新基本能解决。
用DeepSpeed做零冗余优化的高阶玩法
前面提到的切分是静态的,DeepSpeed ZeRO则是动态的,它的思路是:权重、梯度、优化器状态这三样东西,不需要每张卡都存一份,谁用到谁去拿,这在训练场景下特别有用,因为微调模型时,优化器状态占的显存比权重本身还多。
ZeRO的三个阶段:
- ZeRO-1:优化器状态切分,训练时每卡只存一部分优化器状态。
- ZeRO-2:加上梯度切分,进一步减少显存占用。
- ZeRO-3:权重也切分,推理时每卡只持有模型的一部分权重,按需读取。
ZeRO-3本质上是极端的张量并行,因为权重被切到所有卡上,通信开销比普通张量并行更大,但显存利用率极高,你可以在单机两张卡上通过DeepSpeed跑30B模型的微调,这在静态切分下根本不可能,启动命令很简单:
deepspeed --num_gpus=2 train.py --deepspeed ds_config.json
ds_config.json里把zero_optimization.stage设为3,显存就自动池化了,需要注意,ZeRO-3的推理速度会比静态切分慢一些,因为它要从多卡里聚合权重,做实时推理用静态切分,做离线微调用ZeRO,这是最合理的分工。
Q&A:关于显存切分部署的常见疑问
模型切分部署会影响生成质量吗?
不影响,切分只是把矩阵运算拆开做,数学上完全等价于单卡计算,输出结果和没切分时一模一样,除非你混入了量化,量化会带来一定精度损失,但那是量化的问题,不是切分的问题。
两张不同品牌的显卡能混用吗?
能,但条件苛刻,只要显存容量和驱动兼容,就能用CUDA把两张卡同时调度起来,比如一张RTX 3090加一张RTX 2080Ti,显存一个24G一个11G,就可以用流水线并行把大层放在3090上,小层放在2080Ti上,速度以慢卡为上限,不过比一张卡跑不了强得多。
切分部署后显存还有剩余,怎么继续优化?
把剩余显存用来增大batch size或上下文长度,上下文长度对生成质量影响很大,尤其是在长文档摘要和对话记忆场景中,你可以调高max_new_tokens,或开一个更大的KV Cache池,不过显存加得越多,每生成一个token的延迟也会相应变高,需要自己权衡。
显存容量约束这件事,本质上是个资源编排问题,切分部署把“一块卡放不下”变成了“几块卡刚好装下,还能剩点空间”,配合量化、offload、ZeRO这些工具,很多看似跑不动的模型都能在平民卡上转起来,下次再遇到大模型,先算好显存账,再选切分策略,别急着掏钱。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/622969.html