GPU服务器多卡训练故障隔离方案:炸卡前划好边界
多卡训练被迫中断,绝大多数情况不是算力不够,而是单卡故障没有在本地被关住,让整组训练陪葬,用故障域隔离把一张卡的故障限制在它自己身上,训练就不至于从头再来。
大模型训练任务动辄几百卡协同,单卡显存报错、掉卡、通信超时这类硬故障,几乎每个大规模训练团队都会遇到,没有故障域隔离的训练集群像一根长串的鞭炮,一个火星从尾巴烧到头,把故障边界划清楚,让每一张卡都只对自己的工作负责,训练可靠性才有保障。

什么是多卡训练里的故障域
故障域是故障影响的最大范围,单卡故障域是一张卡的显存和计算单元,节点故障域是一台服务器,机架故障域是整个机柜,故障域隔离要做的是把故障影响砍到最小,不让局部问题演变成集群级别的事故,比如4卡DDP训练,其中一张卡掉卡,理想状态下其余3张继续算,训练进程自动降级,而不是整个AllReduce卡死,等人工干预。
这个思路的核心逻辑是:把故障的边界从”整组卡”缩小到”单卡”,从”训练任务”缩小到”具体进程”,基于这种设计,训练中断概率不会归零,但恢复成本会指数级下降。
行业共识认为,大部分GPU服务器训练中断事故,发生在显存ECC错误、驱动探活失败、NCCL网络通信超时这三类问题上,而这三类问题都能通过故障域隔离的方式做局部处置。
大模型训练卡故障怎么排查:三个特征与五条命令
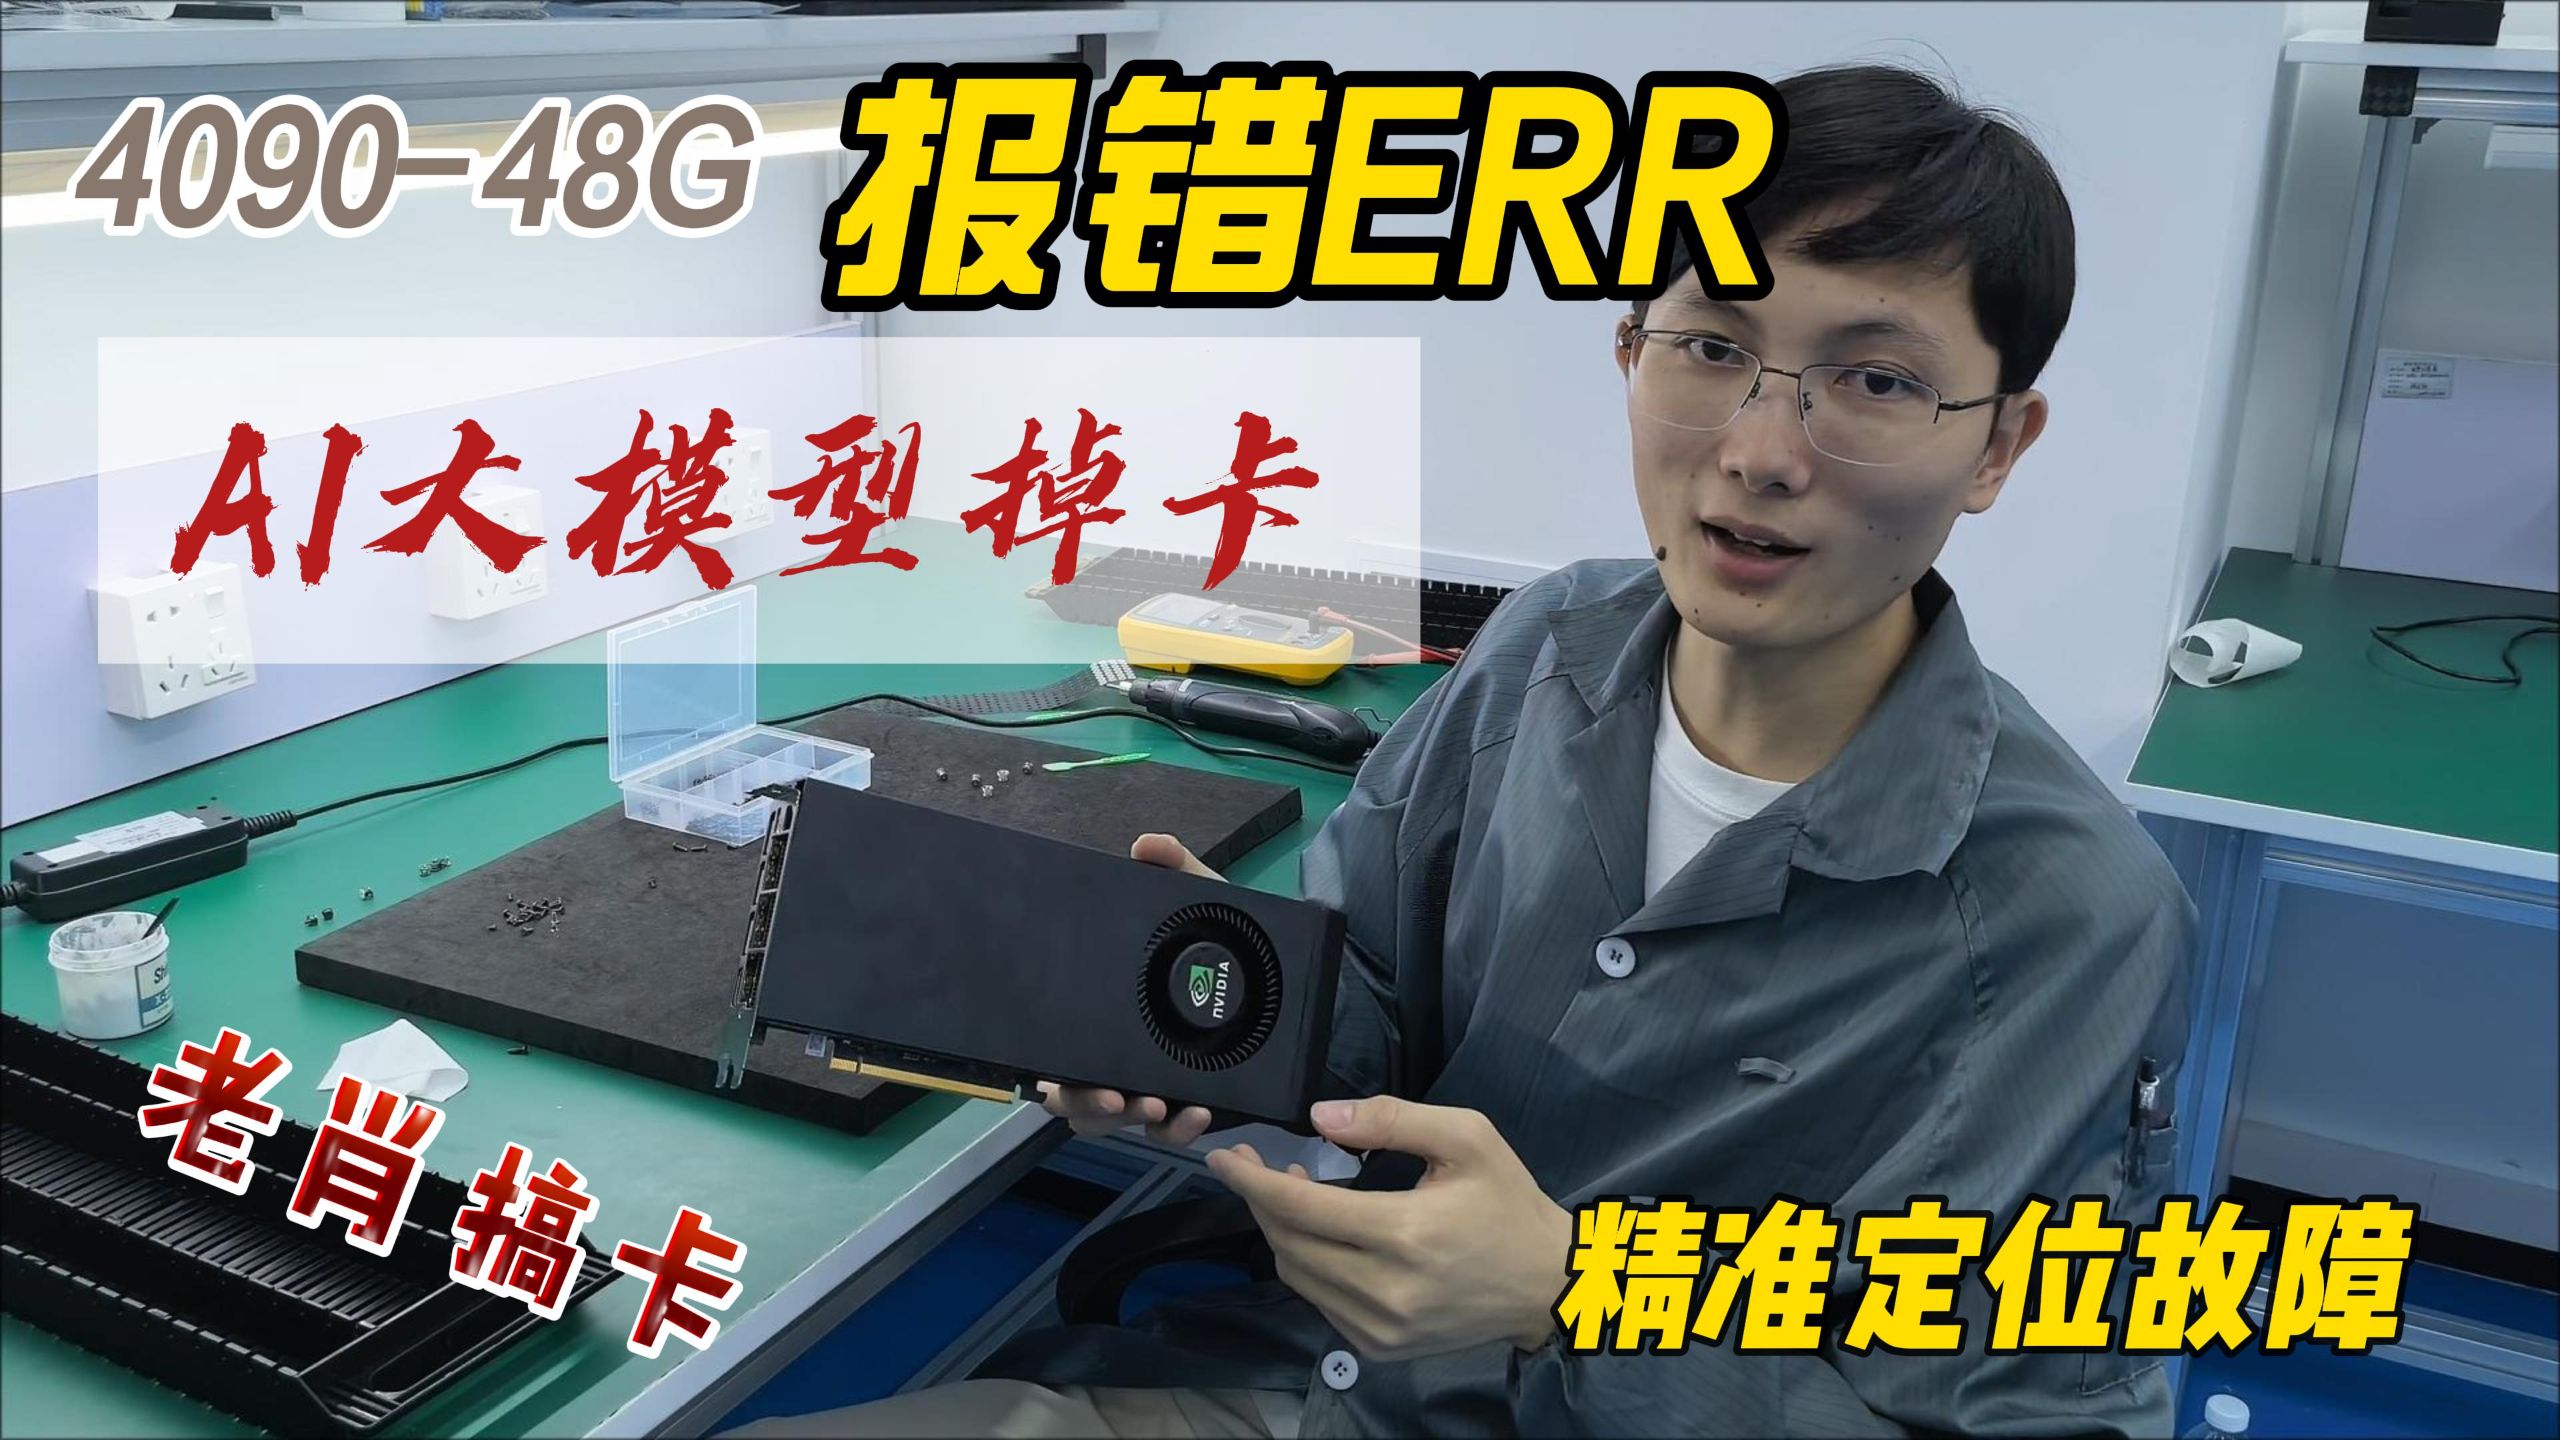
排查单卡故障,先看三个硬特征:显存ECC记录、温度持续高位、NVML探活失败,这三个特征都能用系统命令直接在节点上验证,不需要上探针就能定位问题。
排查时建议按顺序执行,节省时间:
nvidia-smi --query-gpu=timestamp,name,temperature.gpu,ecc.errors.uncorrectable.volatile.total --format=csv -l 5,每5秒刷新一次,观察显存ECC错误是否持续累积dmesg | grep NVRM,查看最近时间内NVRM模块报出的Xid错误码,Xid 79代表GPU掉卡,Xid 48代表诊断到硬件异常,Xid 56/57代表PCIe总线问题nvidia-smi -q -d ECC,查看显存ECC错误是volatile还是aggregate,区分瞬时故障和物理损伤- 检查NCCL日志,
/var/log/nccl.log中如果出现timeout waiting for all ranks,说明通信超时切断了对端心跳,需要确认对端GPU是否处于不健康状态 - 用
nvidia-smi --query-gpu=index,clocks_throttle_reasons.active --format=csv,确认GPU是否因温度或功耗被降频限速
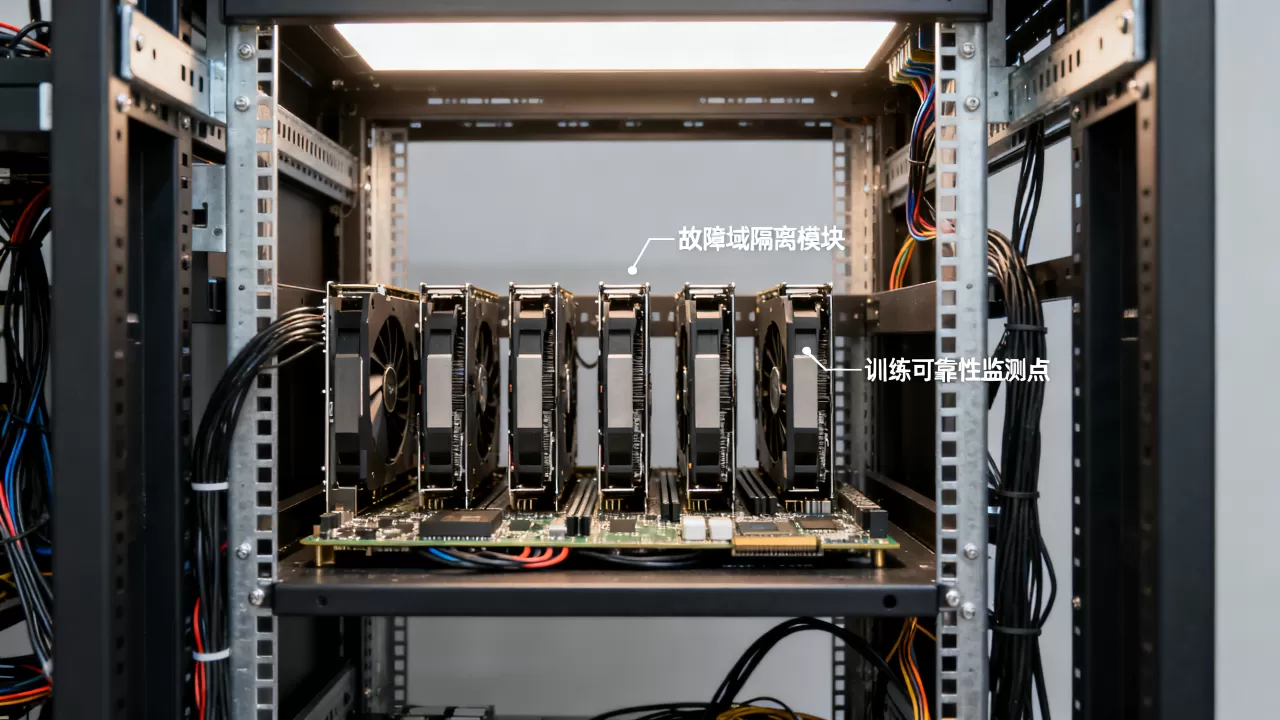
这三特征五命令覆盖了大模型训练卡故障怎么排查的日常路径,多数情况下,显存ECC错误是可纠正错误,有自愈能力,但错误量如果持续增长,就需要在训练计划的间隙将卡下线排查。
排查过程中的故障域切割
排查出故障卡之后,下一步是把这张卡从当前通信域中摘除,如果你用的是MPI风格的静态通信组,摘除一块卡意味着重建整个通信域,所以团队需要将训练框架切换到弹性调度模式,让单卡下线不触发全任务重启。
Pytorch官方torchrun弹性模式是这个场景的推荐路径,启动命令加上弹性参数即可:
torchrun --nnodes=2:4 --nproc_per_node=8 --rdzv_backend=c10d
  --rdzv_endpoint=master-node:29500 --rdzv_id=job_2026_001
  --max_restarts=5 train_script.py
配置了弹性节点范围之后,任务在节点故障时不需要重新排队,会自动等剩余节点聚集到最小可用配额,然后继续执行,重启后从最近的checkpoint加载,训练进度损失被控制在几个step以内。
框架层容错:多卡故障域隔离的软件支撑
硬件层的隔离是物理边界,软件层的容错是恢复路径,训练框架如果只依赖外部调度器重启,恢复时间会拉到分钟级,在代码和参数层面做设计,故障恢复才够快。
checkpoint的保存节奏与恢复路径
在DeepSpeed或Megatron-LM上,模型权重按--save-interval间隔保存,对千亿参数模型来说,每3-5分钟保存一次分布式checkpoint,单次保存占用存储约几十GB,叠加模型并行的分片策略后,保存开销并不可怕。
实际操作层面,推荐组合使用:
- 设置DeepSpeed的
"checkpoint": {"load_universal": true},保证分片方式改变后权重仍可加载 - 启动时加
--auto-checkpoint,让训练脚本依据前一次状态自动寻找最近保存点 - 配置
--resume参数,配合调度器的自动重启策略,实现故障后最快90秒回到训练状态
NCCL通信超时的边界设置
NCCL是Multi-GPU通信的核心库,超时时间的设定直接影响故障域的大小,超时太短容易误报,超时过长则故障卡会拖住整个集群等待,推荐设置 NCCL_IB_TIMEOUT=22 作为默认值,在IB网络不可达时22秒内报错,同时设置
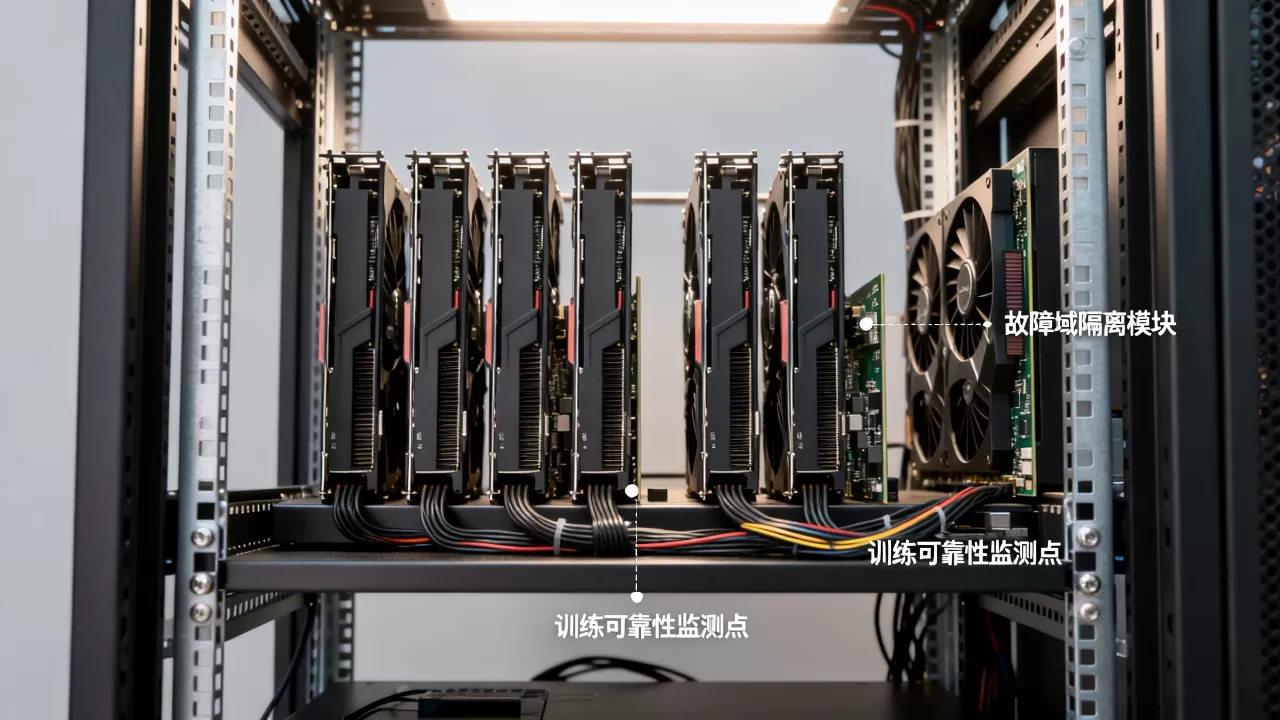
NCCL_SOCKET_TIMEOUT=60,防止局部网络抖动造成全局同步死等。
通信超时检测是故障域隔离的第一道放行杆,一张私有网络的卡与外界失联,NCCL会在设定时间内杀掉对应rank,随后由弹性调度器重新补齐节点。
硬件层面的物理隔离:MIG与vGPU的应用边界
硬件层面的故障域隔离,通常使用NVIDIA MIG功能和GPU虚拟化技术,MIG可以将A100/H100物理GPU切分为最多7个独立实例,每个实例有独立显存和计算单元,硬件资源物理隔离,故障发生时,单个MIG实例的显存报错不会影响同一物理卡上的其他实例。
vGPU方案更偏重虚拟化场景,每个虚拟机绑定独立GPU切片,故障边界被锁在虚拟机内部。
但MIG也有适用边界,大模型训练通常需要整套GPU显存,MIG切分后单实例显存不够用,此时物理隔离的粒度要回调到”整卡”级别,即用调度系统将故障卡标记为不可用,剩余健康卡重新组成通信域,这也是多卡故障域隔离在现代大模型集群中的主要做法不做GPU内部切片,而是做卡的精细调度。
对于单卡故障率较高的小规模训练集群,在节点层面做隔离比在卡层面做隔离更省精力,一台4卡机器如果是孤岛训练,任何单卡故障都会中断任务,此时最好的方案是训练前把checkpoint保存到分布式文件系统,靠重跑恢复,而不是在单机内做复杂的隔离逻辑。
从设计到落地:五步搭建多卡故障隔离体系
有了理论认知,落地时的路径可以总结为可复制的五步:
- 收集健康指标:部署DCGM(NVIDIA Data Center GPU Manager)监控每一块GPU的利用率、温度、显存ECC计数、功率,这部分数据是故障识别的事实依据。
- 定义异常阈值:显存ECC不可纠正错误数大于100触发告警;GPU温度超过85℃持续10分钟触发告警;NVML会话断开立即触发告警,阈值设好后,在Prometheus中配置alert rule,并接入告警通道。
- 打通自动摘卡流程:告警触发后,用脚本自动调用K8s API,将异常GPU节点标记为不可调度,并触发torchrun弹性任务重新分配节点。
- 落实checkpoint保存制度:训练任务启动时,强制要求配置自动checkpoint路径,保存间隔不超过5分钟,这一条写进代码检查清单里,不满足不让训练。
- 周期性故障演练:每月手动kill一个训练进程或拔掉一张物理卡,观察系统是否自动恢复,演练记录作为团队指标,纳入训练稳定性考核。
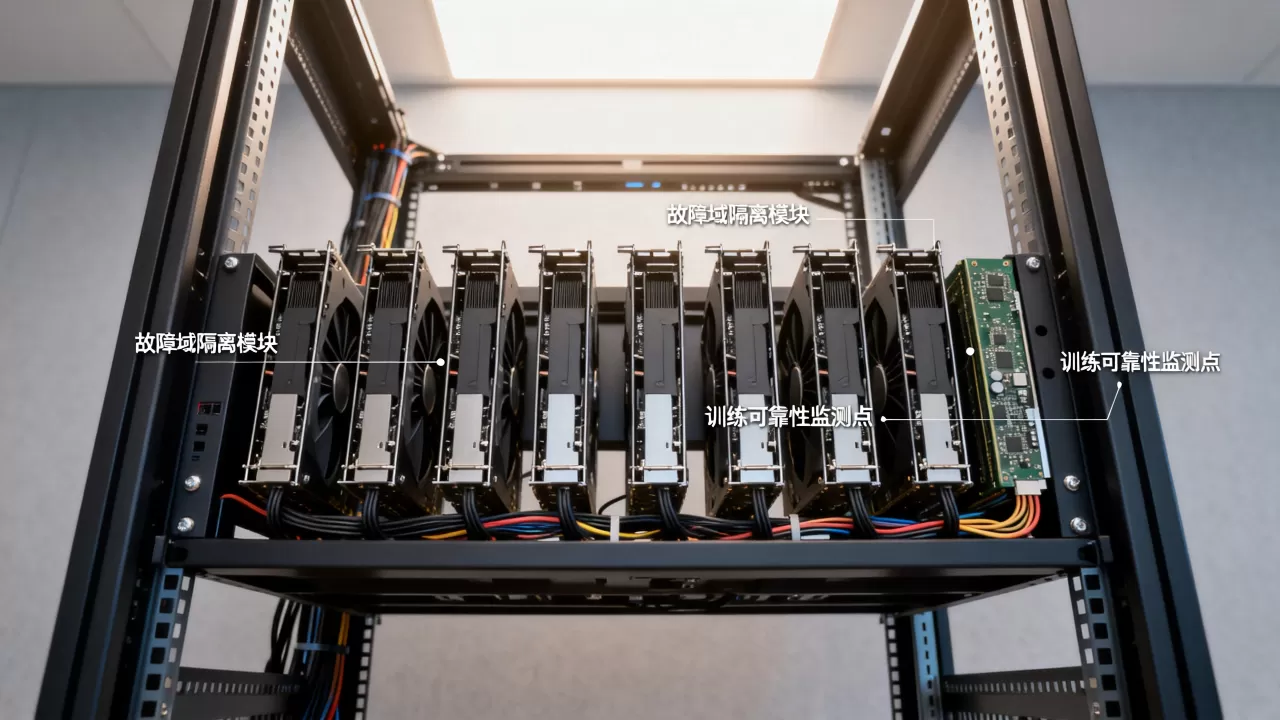
这里有一条实操经验供参考:一位智算中心的算力运维组长分享过,他们的80卡集群从”无隔离、纯人工”模式切换到”告警+自动摘卡+弹性重启”模式后,训练可用的GPU时长提升了约三成,且不需要增加运维人手,成本变化极小。
单卡故障的训练可靠性代价
谈GPU服务器多卡训练故障隔离方案,需要客观看待代价,故障域隔离除了软件和框架的改造外,还会引入一定的算力冗余,比如一个训练任务需要128卡,隔离设计可能会要求集群最少预留136卡,多出的8卡用于故障替补,多数情况下,冗余成本小于中断成本一次大模型的重新排队加权重加载,消耗的时间往往值回冗余卡的费用。
在异构计算需求较多的场景中,可以考虑按优先级分配隔离资源,大模型训练任务分配独立GPU池,小规模推理任务共享动态空间,故障时不同优先级任务的恢复策略不同,这样的弹性策略比一刀切的隔离更符合实际业务节奏。
常见问题解答
大模型训练卡故障怎么排查效率最高?
综合最优先做三件事:查看NVRM的Xid日志、查显存ECC不可纠正错误计数、看NCCL通信日志中的超时rank,这三个数据同时指向同一张卡,故障定位基本就准了,要是三者指向不一致,先用nvidia-smi -q -d ECC确认硬件健康状态,再检查通信链路配置,链路配置的排查重点看IB交换机侧的光模块日志和丢包计数。
训练任务已经在跑了,现在做故障域隔离来得及吗?
来得及,但改动量取决于当前训练方式,如果任务是单机多卡,最快捷的办法是给启动命令加上自动重启参数,并确保每5分钟保存一次checkpoint,如果任务是多机多卡,还需要统一各节点的分布式存储路径,保证重启后所有节点能读取同一份checkpoint,框架层面的改动单次不超过20分钟,建议安排在下一次训练任务开始前完成。
多卡故障域隔离对训练速度有影响吗?
有影响,但幅度很小,弹性调度和实时监控的额外开销小于千分之一,NCCL超时参数本身不改变通信带宽,主要影响来自重启恢复时重新加载权重,对百亿参数模型来说这个时间在1-3分钟量级,相比一张故障卡拖垮整个任务后重新排队几小时的代价,这个影响完全可控。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/623935.html