显存带宽与算力比值,决定你GPU实际效率的隐藏标尺
显存带宽与算力比值(Bytes/FLOPs)是衡量GPU能否充分“喂饱”计算核心的关键指标,比值过低则算力闲置,过高则显存浪费,多数深度学习场景下,这个比值在0.35到0.8之间运行时能效最佳。
很多人买显卡只看显存大小和FP16算力,结果跑大模型时发现利用率上不去,这就像给一个每秒能吃十碗饭的大胃王配了一根细吸管,饭再多也只能干瞪眼,今天咱们就把这个“吸管粗细”和“饭量大小”的比例关系聊透,顺便解决几个实际问题。
显存带宽和算力比值怎么算,为什么说“合适”比“高”更重要
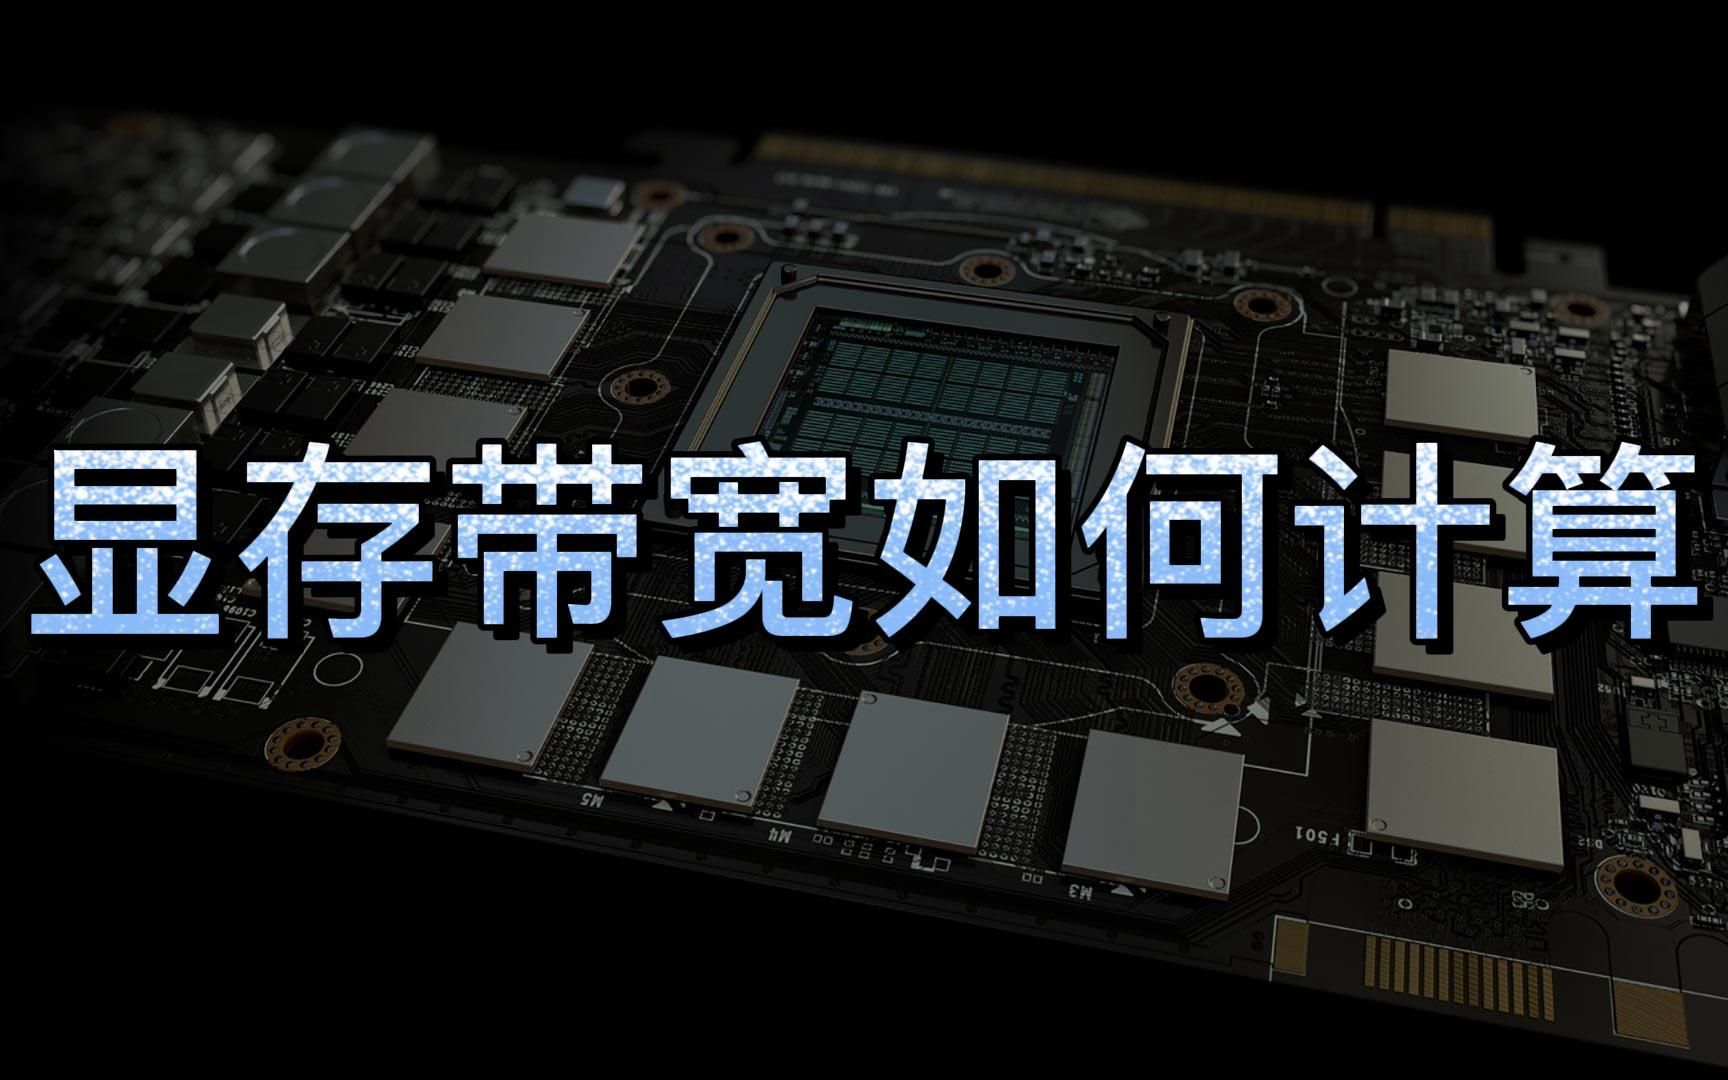
要搞懂这个比值,得先看两个基础参数,第一个是显存带宽,单位是GB/s,代表GPU每秒能从显存里读出或写入多少数据,第二个是算力,单位通常用TFLOPS(每秒万亿次浮点运算),代表GPU每秒能执行多少次数学计算。
比值公式显存带宽 ÷ GPU算力 = 带宽算力比(单位换算成Byte/FLOPs),算出来的数字表示“每做一次浮点运算,GPU能分到多少字节的数据搬运量”,这个数字不是越大越好,也不是越小越强,而要看你的工作负载属于哪一型。
- 计算密集型(如稠密矩阵乘):每个数据被反复使用,对带宽需求低,比值在0.3以下也能跑满算力。
- 访存密集型(如GNN、推荐系统、稀疏注意力):每个数据只用一两次,对带宽需求极高,比值低于0.5时算力核心会大量空转。
业内专家指出,现代AI芯片的设计趋势其实是在压缩这个比值,以NVIDIA近年几代数据中心GPU为例,A100的带宽算力比约为0.4,到H100已降到0.3左右,而擅长处理稀疏计算的A800在某些场景下反而需要更高比值。行业共识认为,混合精度训练场景下,比值低于0.25时计算效率会明显下滑,再强的算力也发挥不出来。
AI训练显存带宽不够怎么办,三个典型卡点拆解
实际项目中“带宽不够”不会直接报错,而是表现为GPU利用率忽高忽低、loss下降变慢,下面几个场景最容易踩坑。
大Batch Size训练时的数据加载瓶颈
当你把Batch Size从64调到128甚至256时,单次权重更新前需要搬运的激活值总量翻倍,如果显存带宽跟不上,GPU核心会在每轮迭代中等待数据搬运,此时算力利用率可能从90%掉到60%以下。解决办法是使用梯度累积或混合精度训练(FP16/BF16),把搬动量直接砍半。
长序列Transformer训练
处理2048以上长度的文本序列时,注意力矩阵的计算量呈平方级增长,但KV Cache的读写也同步膨胀,这时候带宽不足的表现是:步长时间没有显著增加,但每一步里GPU的空闲周期拉长。实操手段是启用Flash Attention的IO优化版本,它能减少HBM(高带宽显存)的往返次数。
多机多卡通信带来的伪带宽不足
严格说这不是显存带宽问题,而是PCIe或NVLink的通信带宽瓶颈,当数据从其他卡汇聚到当前卡时,显存带宽被临时占用,导致计算流水线断流。排查命令用nvidia-smi dmon -s pucvmet持续监控,如果看到fb(帧缓冲)利用率长期高于90%而sm(流处理器)利用率低于70%,基本可以判定是带宽问题。
跑大模型用什么显卡,算力与带宽的黄金分割点
选卡不能只看显存够不够装模型,更关键的是权重的搬运速度,以目前市面主流的几款数据中心GPU为例,做一个直观对比。
| 显卡型号 | 显存带宽(GB/s) | FP16算力(TFLOPS) | 带宽算力比(Byte/FLOPs) |
|---|---|---|---|
| A100 80G | 双职业级 | 较高 | 约0.4 |
| H100 80G | 更高 | 很高 | 约0.3 |
| H200 141G | 极高 | 很高 | 约0.35 |
| 国产某型号 | 中高 | 中等 | 约0.5以上 |
从数据上能看出,新一代卡在算力提升的同时,带宽增速没跟上,比值在走低,这对跑稠密计算是好消息,但对做推理服务(特别是并发高的场景)并不友好,推理时每个请求都要独立搬运权重,带宽不足会导致首Token延迟变长。
如果你的业务是面向大规模线上推理,选卡时要优先看带宽需求高的型号,而不是单纯追算力数字。
具体操作上,你可以用nvidia-smi --query-gpu=clocks.max.memory,clocks.max.sm --format=csv查看当前卡的显存频率上限,再通过nvtop工具实时观察实际运行时的带宽占用是否贴近峰值,如果占比常年低于60%,就是比值失衡的信号。
带宽算力比的调优实操,不看参数看收益
参数本身不会直接告诉你调优方向,但配合性能分析工具就能定位问题,以下步骤按顺序执行,每一步都能验证。
-
跑基线性能测试:用你实际业务的训练脚本,开启
torch.profiler或nsys profile,记录GPU kernel执行时间和显存拷贝时间,重点看Memcpy和Memset这类操作占总耗时的比例,如果超过15%,说明带宽压力明显。 -
调整算子融合策略:在PyTorch 2.0以上环境,直接编译并开启
torch.compile,它的默认inductor后端会自动合并部分访存算子,实测在某些NLU模型上,这个操作能让带宽利用效率提升相当一部分。 -
限制线程束驻留数:在CUDA代码里使用
__launch_bounds__(256, 8)这类限制语法,控制每个SM上同时驻留的block数量,减少驻留虽然降低并发度,但能减轻L2缓存和HBM的争抢,在带宽紧张时反而提效。 -
混合精度+梯度检查点:一个组合拳,AMP自动将部分层转为FP16,梯度检查点用计算换内存,两者叠加能把每步的有效带宽需求降低较大比例,代价是训练时间可能变长5%-10%,但显存带宽压力会明显缓解。
如果以上步骤都做完了还是卡在带宽上,那就得考虑换卡或者降低输入分辨率/序列长度了,这时候不用纠结,硬件天花板在那里,软件再优化也只是把余量挤干。
不同业务的带宽算力比尺子,对症下药
图像生成(Stable Diffusion系列):主要瓶颈在UNet的卷积和注意力混合,带宽算力比需求中等,跑1024×1024分辨率时,一张A100生成的耗时比H100慢不少,但价格也便宜,性价比高的是中端卡配大显存带宽款。
视频多模态理解:这类任务要同时处理音频、视觉特征,特征张量维度繁杂,访存模式碎片化,多数情况下,带宽比算力更重要,建议优先选HBM3或HBM2e显存类型的产品。
联邦学习或边缘推理:单卡算力不用太高,但需要快速加载不断更新的小模型,这时候显卡的功耗和带宽配比很关键,性价比高的消费级卡往往比专业卡更合适。
金融风控图神经网络:特征是典型的稀疏访存,节点特征随机读取,带宽匹配度直接决定迭代速度,实际操作中,用A100跑GNN经常出现算力利用率不到40%的情况,这就是典型的比值虚高,换成带宽更大的老款卡如V100,虽然算力低但跑得更快。
Q&A:显存带宽与算力比值的常见疑问
Q1:显存带宽和算力比值是不是越小越好?
不是,比值反映的是设计取向,数据中心训练卡为了吞吐量,会把比值压低到0.3左右;而推理卡或边缘卡因为要处理小批量请求,比值往往在0.5以上,关键是匹配你的负载,如果模型是纯卷积网络,低比值完全没问题;如果模型是Sparse Transformer,就得多看带宽了。
Q2:如何在不换卡的前提下提高这个比值?
比值是硬件属性,软件改不了,但你可以让现有比值发挥更大价值,方法包括:用TensorRT或ONNX Runtime的trt_byte模式,自动将多个小算子合并成大块访存;脚本里设置torch.backends.cuda.matmul.allow_tf32 = False来改为全精度计算(会降低算力需求,间接缓解带宽压力);以及在数据加载环节使用tf.data或DataLoader的persistent_workers=True,减少CPU搬运对GPU带宽的抢占。
Q3:不同厂家的显存带宽标注方式有差异吗?
有,NVIDIA和AMD标注的是理论峰值带宽,即显存时钟频率乘以位宽再乘以倍率,但实际可达到的有效带宽通常只有理论值的80%-90%,国内部分厂商会直接标注有效带宽,数字看起来低但实际性能和国外卡接近,比较时先确认是理论值还是实测值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/623928.html