数据倾斜就是集群里少数几个节点扛着绝大多数活,其他节点早早干完干等着,整个查询的耗时被这几个“累死”的节点死死卡住。
这就像十个人搬砖,八个人一人搬一块,剩下两个人一人搬十块,搬得快的不是先下班,而是等那群搬得慢的,放到分布式计算里,一个Spark或者Hive任务跑得慢,十有八九不是集群不够大,而是某几个key的数据量大到离谱,把对应节点压垮了。
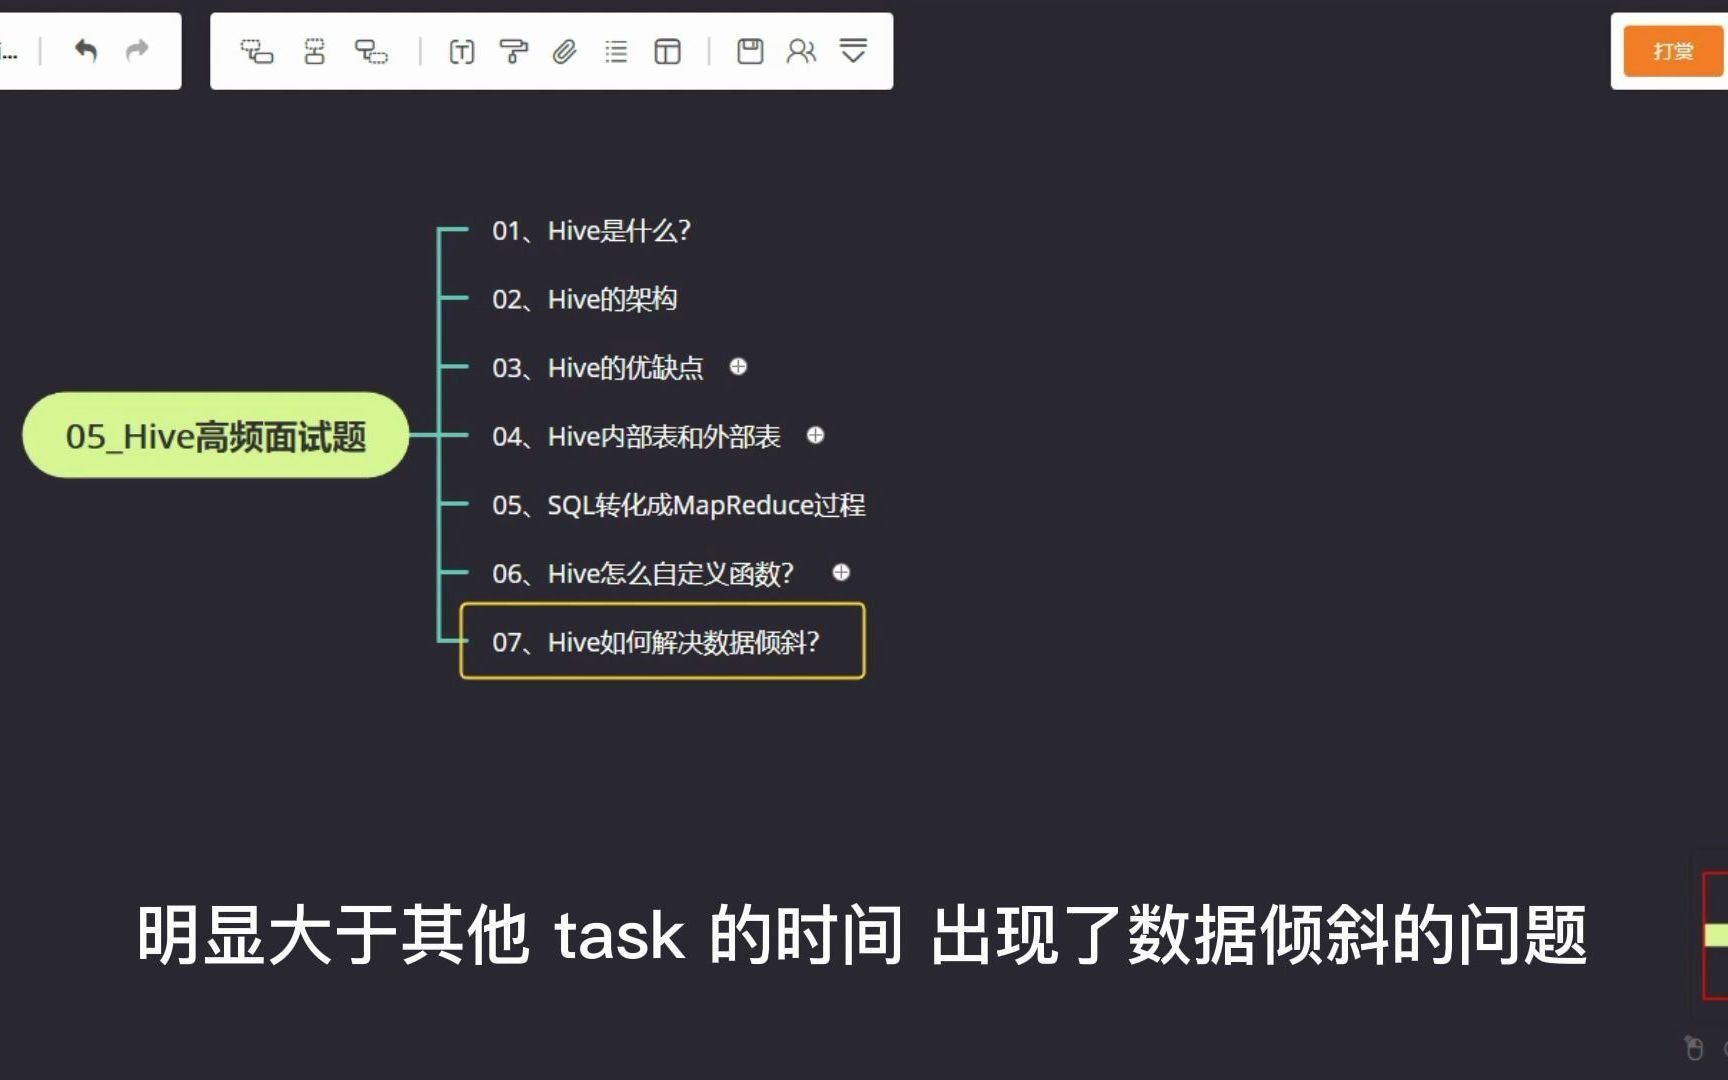

数据倾斜怎么解决:先定位再下手
要让查询快起来,第一步不是调参数,而是确认问题到底是不是数据倾斜。
怎么判断查询慢是倾斜造成的
一个很直观的观察点:看任务进度,如果任务卡在99%好一会儿不动,或者某个Stage里的任务运行时间远超其他任务,那基本就是倾斜没跑了。
具体可以从三个地方确认:
- Spark UI:打开Stage详情页,看每个Task的Shuffle Read和Duration,如果少数几个Task处理的数据量是平均值的几倍甚至几十倍,而运行时间也对应拉长,这就是典型的倾斜。
- Hive日志:关注最后一个Job是否长时间停留在Reduce阶段,且Redcue进度条几乎不动,Reduce端分配不均往往是倾斜的直接信号。
- 任务速度差异:同一个Stage里,大部分Task几十秒跑完,有那么一两个跑了几分钟还没结束,差异越大,倾斜越严重。
先查有没有“脏”key
很多人遇到倾斜就急着调参加盐,其实第一步应该看看是不是数据本身出了问题。
- 查空值,比如用户ID字段为
null或者空字符串,这些值会被一股脑分到同一个Reduce节点 - 查异常值,比如默认值、特殊占位符,有些业务在埋点时把“-1”或“unknown”当成默认用户ID,量一大就出事
- 查分组字段的取值分布,SQL跑个
group by统计一下每个key的记录数,能直接看出有没有key的数量异常突出
先把这三件事做了,再谈后面的优化方案。
数据倾斜和热点数据区别在哪:别把两件事混为一谈
很多刚接触大数据的同学会把数据倾斜和热点数据当成一回事,其实它们的处理思路完全不一样。
热点数据是一个业务现象,指的是某些数据对象天然流量就大,比如一件爆款商品在同一时间被大量用户点击,这些点击日志在物理上就集中在某个商品的key上,它通常是静态的、业务层面的特征。
数据倾斜则是一个计算问题,描述的是数据在分布式节点间分配不均的状态,热点数据是产生倾斜的诱因之一,但倾斜也可能是由代码写法导致的,比如关联键为空的记录被统一分配,本质上不是数据“热”,而是写法有坑。
| 维度 | 数据倾斜 | 热点数据 |
|---|---|---|
| 本质 | 计算资源分配不均 | 业务访问量集中 |
| 产生原因 | Key分布不均衡、关联键含大量空值、Reduce分区策略问题 | 商品、用户、内容天然有流量差异 |
| 解决方法 | 加盐、广播、过滤空值、调整并行度 | 缓存、限流、多级降级 |
| 影响范围 | 任务运行时间变长、资源浪费 | 系统响应变慢、可用性下降 |
处理逻辑也比想象中简单:如果是一个跑批任务变慢,大概率是数据倾斜;如果是一个接口在秒级响应不了,大概率是热点数据压垮了后端服务。
最常见的三类倾斜场景和对应解法
懂得看现象还不够,需要针对不同场景用不同的手段,这里拆三个最常见的业务场景,都是可以直接上手的操作。
大表关联小表时,小表key被放大
举个例子,订单表关联商品维度表,商品表里有几个爆款商品ID,被几十万条订单引用,这几十万条订单在shuffle阶段全部涌向同一个Reduce任务,其他任务干完活在那儿干等。
解法:优先走广播机制。
把商品表通过map join广播到每个Executor内存里,直接从源头消除shuffle,Spark里可以手动设置广播阈值,或者在SQL里加一句/+ BROADCAST(小表) /提示,Hive则用set hive.auto.convert.join=true开启自动map join,普通关联键分布比较均匀的大表关联场景,这条路通不了。
大表关联大表,空key造成倾斜
两个上亿行的表做关联,业务逻辑要求保留所有记录,结果发现部分用户的ID在另一张表里根本不存在,这些匹配不上null值会汇集到同一个Reduce,时间全耗在无意义的匹配上。
解法:给空key喂随机数。
思路很简单,把null或者空字符串替换成随机值+用户ID的组合,让这些原本扎堆的记录分散到不同Reduce,关键一步是两边关联字段都要做同样处理,否则左边加了后缀,右边没加,关联不上反而丢数据。
实操做法:
- 过滤掉空值后再关联,适用于空值本身没有业务含义的情况
- 对空值字段填充随机前缀,比如
concat('rand_', rand(), user_id) - 把空值可能对应的业务含义保留在另一份数据里单独处理,最后用
union合回结果
Group By聚合时单个key数据量异常大
做用户行为统计时,某个头部用户的行为日志比其他用户多出几个数量级,按用户ID分组聚合时,光这个用户的数据就能把一个Reduce节点跑爆。
解法:两阶段聚合加盐。
先在每个key后面拼上随机数(比如0到9),做第一轮局部聚合,把同key的数据按照随机数拆成十份,分散到十个节点先各自算一遍,然后再去掉随机后缀,做第二轮聚合,合并结果。
核心注意事项是:如果要做的是count distinct这类去重统计,两阶段聚合可能会影响精度,需要谨慎使用。sum、max、min、avg这类操作可以直接套用。
Spark和Hive侧边参数优化
上面说的都是SQL改写层面的解决办法,实际操作中,配合参数调整效果更好。
提升Shuffle并行度
- Spark里调整
spark.sql.shuffle.partitions,默认值是200,如果数据量巨大,把值调大到400或更高,能让数据分得更散 - Hive调整
set mapred.reduce.tasks,但前提是先确认倾斜的key数量不大,如果就是单个key畸形,单纯调大并行度没有意义,因为那个倒霉key还是会落到同一个节点
开启倾斜自动优化
- Spark 3.0以上版本,可以把
spark.sql.adaptive.enabled设为true,再开spark.sql.adaptive.coalescePartitions.enabled,自适应查询执行能在运行时自动检测倾斜分区,并把倾斜分区拆成多个小任务并行处理,这个机制叫动态分区裁剪
,多多数场景下比手工加盐省事
- Hive里把
hive.groupby.skewindata设为true,对于group by产生的倾斜有缓解作用,做法是启动两轮MapReduce,第一轮预聚合打散数据,第二轮合并结果 - 也可以直接建表的时候用
skewed by声明倾斜字段,Hive会为这些特殊值单独建立文件
业务侧的数据预防策略
倾斜只靠查数的人临时救火,永远救不完,更稳妥的方式是在数据上生产阶段就做合理的预处理。
把高势能key提前拆分,在ETL层识别出大key,单独存储,或者给key打上标记,计算时直接走特殊逻辑分流,业务上常见做法是给高潜用户ID单独建一张表,和普通用户分开统计,最后再合并结果。
数据分区做好物理隔离,比如按天分区的基础上,把超大分区再按小时拆,这样即使某个时间段数据量飙升,也不会拖垮整天的查询。
业务侧优化入口埋点,弹窗点击、页面曝光这类高频事件,在埋点时就随机打散写入多个分区字段,避免日志表里单一key的量级失控。
Q&A
数据倾斜一定是因为数据量太大吗
不完全是,有些场景下总数据量不大,但关联字段为空的比例过高,比如两个一万行的表关联,其中一张表有九千行记录的关联ID是空的,这九千行全分到一个节点上,照样会倾斜,数据量只是表象,分布问题才是核心。
Spark调大executor内存能解决数据倾斜吗
不能根治,加大内存只是让那一个扛压节点有更多资源可用,稍微缓解崩溃的风险,但倾斜本质是负载不均衡,光靠扩充单个节点容量,既浪费成本,也无法应对数据量继续增长,正确做法是让数据分得散,而不是让每个节点变得更能扛。
用了加盐方案后结果数据变多了是怎么回事
加盐本质上把一个大key拆成多个子key进行预聚合,第二轮聚合会合并结果,最终数据量和正确结果应该一致,但如果加盐过程中随机数拼错了位置,或者两阶段聚合的字段没有对齐,会出现中间结果膨胀,最常见的原因是第一轮聚合后,去掉了随机前缀时误把原始key的一部分截掉了,检查一下加盐的字段格式和两阶段SQL的group by字段,确保完全一致即可。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/638952.html