大规格节点和小规格节点哪个好没有固定答案,核心看业务负载对资源碎片化和调度弹性的敏感程度。 先把这个结论放在这,下面会从资源分配逻辑、调度粒度、成本、地域价格和混合部署几个角度把这件事拆开说透。
大规格节点和小规格节点哪个好:先看两种节点的资源分配逻辑
在Kubernetes集群或云服务器集群里,节点规格决定了单台机器能承载多少Pod或容器,大规格节点通常指CPU和内存总量较高的机器,比如16核64G、32核128G或更高,小规格节点可能是4核8G、8核16G这类,两者的差异不只是数字大小,还会直接影响调度器怎么给Pod找位置。
大规格节点适合什么场景:三类业务画像
大规格节点不是越大越好,但有些负载天然适合它:
- 批处理与离线计算:Spark、Flink任务往往需要短时间吃掉大量CPU和内存,大节点能给单个Pod提供更大的资源上限,减少跨节点通信。
- 数据库与中间件:MySQL、Elasticsearch、Kafka等有状态服务喜欢稳定的资源配额,大节点可以避免小节点上频繁的内存压力。
- GPU训练与推理:AI训练任务对显存和算力要求集中,GPU节点通常本身就是大规格,小规格节点很难承载。
这些场景的共同特点是:单个工作负载需要较大资源块,小规格节点装不下或装下后剩余资源太碎。
小规格节点的碎片化代价:CPU与内存的错配
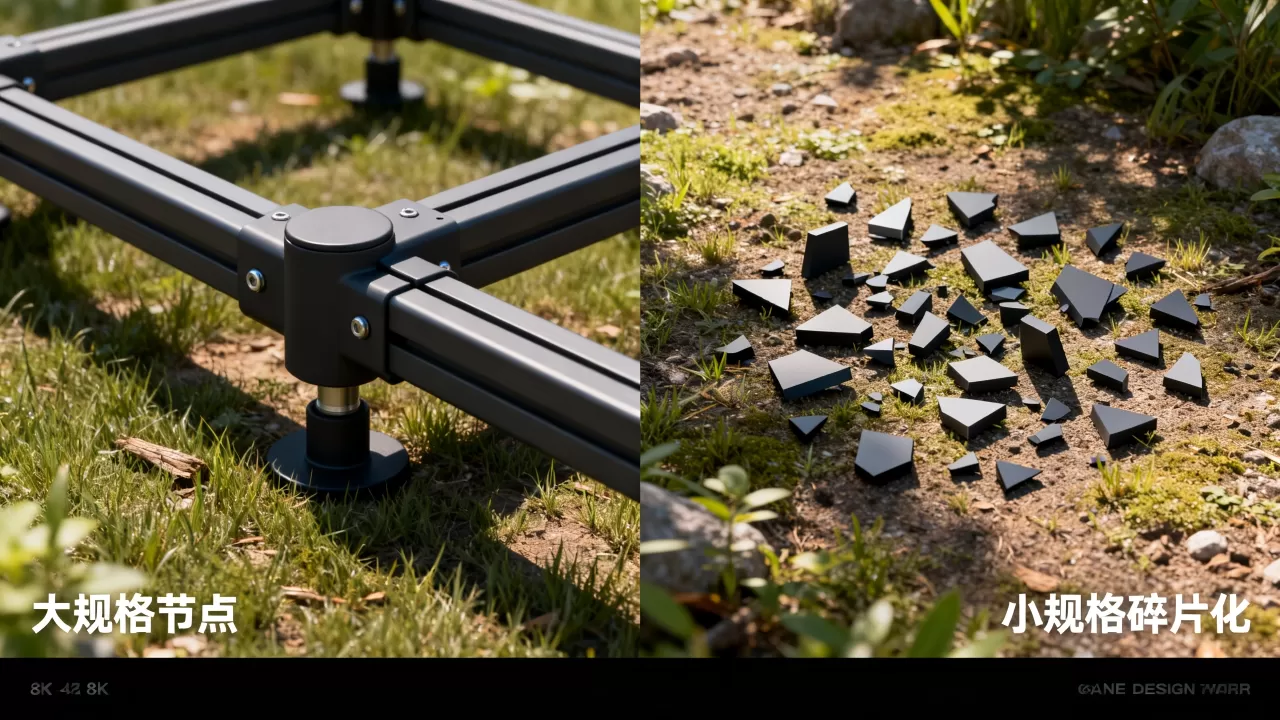
小规格节点的优势是粒度细、扩容灵活、故障域小,但代价也很明显,如果业务Pod的请求值介于节点总资源的一半到三分之二之间,小节点容易出现“CPU还有余量,内存却先打满”的情况。
比如一个8核16G节点,已经跑了3个2核4G的Pod,剩余2核4G,这时下一个Pod要求1核8G,节点上内存不够,无法调度,那2核4G的剩余资源就闲置了,形成碎片,如果换成16核32G节点,同样业务负载下剩余资源块更大,调度成功率会高一些。
集群资源碎片化怎么解决:从调度粒度入手
资源碎片化是集群资源利用率上不去的核心原因之一,它指的是节点上有足够的资源总量,但这些资源被分割成无法满足任何单个Pod需求的小块,业内专家指出,生产集群中资源碎片化常常来自请求值设置不合理,而不是节点规格本身选的不好。
先量化碎片:两个命令看真实状态
在Kubernetes集群里,可以执行这些命令来观察碎片程度:
kubectl describe node <节点名>查看节点的Allocatable(可分配资源)和Allocated resources(已分配资源),对比Requests和Limits,能看到节点是否超卖。kubectl top nodes查看实际使用率,多数情况下,实际使用率远低于请求分配率,说明存在资源预留过多或碎片化。kubectl get events --field-selector reason=FailedScheduling查看调度失败记录,分析Pod资源请求是否过大。
还有一个常用指标:节点上“最大可分配Pod数”与实际运行Pod数的差距,如果节点总资源充足但Pod数先到上限,或者单个Pod资源需求无法满足,就是碎片化典型信号。
调整规格组合:让节点资源块与Pod需求对齐
解决碎片化的第一个实操动作是重新审视Pod的资源请求值,很多团队习惯把resources.requests设得和limits一样大,或者干脆不设,这会导致调度器误判节点剩余资源,正确做法是:
- 先统计集群内Pod的真实平均CPU和内存使用,用
kubectl top pods -n <命名空间>获取。 - 把
requests设置为P95使用值,limits留出一定弹性空间,这样调度器能更准确地把Pod塞进节点,减少预留浪费。 - 对内存型业务和CPU型业务分开部署,避免同一节点上出现资源错配。
第二个动作是调整节点规格的配比,如果一个集群里大量Pod请求在1核2G到2核4G之间,那么使用8核16G或16核32G的节点,碎片率通常较低,如果Pod请求普遍在4核8G以上,小节点反而会频繁触发无法调度,这里的核心不是追求单节点大小,而是让节点资源块的大小尽量贴近业务Pod的常见资源请求组合。
服务器节点规格选择对比:成本、弹性与运维复杂度
大规格节点和小规格节点不能只比单价,要看综合成本,下面给一个对比表。
| 对比项 | 大规格节点 | 小规格节点 |
|---|---|---|
| 单台成本 | 较高,但单位资源价格往往更低 | 较低,单台投入小 |
| 调度弹性 | 单节点承载多,碎片风险取决于请求设置 | 扩容粒度细,容易补齐资源缺口 |
| 故障影响 | 故障域大,单节点宕机影响更多Pod | 故障域小,影响范围小 |
| 运维复杂度 | 节点数少,管理简单 | 节点数多,监控和补丁成本高 |
| 适合负载 | 高CPU高内存、批处理、数据库 | Web服务、微服务、小型API |
从表格能看出,大规格节点和小规格节点哪个好这个问题,如果脱离具体业务根本没有意义,团队要做的是根据Pod资源画像搭配出一个合适的比例。
北京服务器节点租用价格与规格选择的关系
地域对价格影响也很直接,以北京服务器节点租用价格为例,同样配置在不同机房和可用区会有差异,但大规格节点通常有单位资源折扣,比如一台32核128G的云主机,折算到每核每GB的价格,多数情况下比租8台4核16G要低一点,不过要注意带宽和IP成本:北京机房的大规格节点如果只跑十几个小Pod,IP和带宽复用率可能反而不如小节点集群。
所以在北京这类一线城市部署时,如果业务流量稳定且单Pod资源需求较高,选大规格节点更划算,如果业务波动大、需要频繁扩缩容,小规格节点配合弹性伸缩组反而能压住整体账单,这里没有绝对结论,只能根据实际资源需求和付费方式做测算。
大规格节点和小规格节点混合部署的权衡策略
只选一种节点规格往往会走向两个极端:全大节点容易造成资源利用率低,全小节点容易造成碎片化严重,实际生产里,混合部署是更普遍的策略。
用污点与容忍做规格分区
假设集群里有大规格节点和小规格节点,可以通过节点标签和污点把不同负载分开:
- 给大规格节点打标签:
kubectl label nodes <大节点> node-type=large - 给大规格节点加污点:
kubectl taint nodes <大节点> dedicated=large:NoSchedule - 在需要大节点的Pod上配置容忍和nodeSelector:
spec:
  nodeSelector:
    node-type: large
  tolerations:
  - key: dedicated
    operator: Equal
    value: large
    effect: NoSchedule
这样数据库、批处理等Pod只落在大节点上,Web类Pod走小节点,避免互相争抢和碎片化。
通过资源请求与限额控制碎片
混合部署不等于放任调度,还要配合ResourceQuota和LimitRange来限制命名空间内Pod的请求范围,在一个命名空间里设置LimitRange,要求每个容器的CPU请求值至少为500m,内存请求至少为512Mi,这样小节点上就不会挤进太多超小Pod,导致节点看起来满但实际业务承载能力差,再配合HPA(Horizontal Pod Autoscaler)根据实际负载扩缩容,能让节点规格与业务负载保持动态匹配。
监控碎片率可以自己算:用kubectl describe node拿到每个节点的Allocatable和Requests总量,再用实际使用量减一下,如果某个节点的Allocatable减去Requests后剩余资源块大于常见Pod需求却长期无法调度,说明碎片化已经比较严重,需要调整Pod请求值或节点规格。
收束
大规格节点承担“重活”,小规格节点承担“碎活”,把Pod资源请求调准,碎片化就不会成为利用率黑洞,选择时先看业务Pod的平均资源块,再看北京这类地域的租用价格,最后用混合部署和调度策略兜底,这个顺序比直接问“哪个好”更接近真实答案。
大规格节点和小规格节点哪个好:常见问答
集群资源碎片化怎么解决是最有效的手段?
最有效的手段是先把Pod的requests值设置到接近实际使用值,而不是让每个Pod都按峰值预占资源,配合节点规格与Pod资源块的匹配,碎片化通常能降到可控范围,没有一种节点规格能单独解决碎片化。
北京服务器节点租用价格比二三线城市贵,值得为成本选小规格吗?
北京服务器节点租用价格整体高于中西部机房,但网络延迟和可用区配套更好,如果业务用户主要在北方的金融、政企、互联网公司,多出来的机房租用成本通常比跨地域延迟带来的业务损失低,是否选小规格要看Pod资源需求,而不是单纯为了省钱把大负载塞进小节点,那样碎片化导致的浪费反而更高。
大规格节点和小规格节点哪个好,有统一的推荐比例吗?
没有统一比例,生产集群常见做法是让大规格节点承载有状态和批处理负载,小规格节点承载无状态Web和API,比例根据Pod资源画像动态调整,监测节点实际利用率比追求一个固定数值更有意义,最终以集群实际调度成功率和节点资源碎片率为准做迭代。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/641514.html