判断异常流量里的正常访问与恶意请求,核心不是看流量大小,而是看请求行为是否符合真实用户的业务路径同一IP高频请求不一定恶意,每秒几百次请求的IP如果遵循页面跳转顺序,也可能只是爬虫或代理出口。
异常流量怎么区分正常访问和恶意请求:先看五个关键字段
流量异常时最忌讳一上来就封IP,错误封禁会把正常用户赶走,放行恶意请求又会让源站继续承压,区分两者,先把日志里的请求拆成五个维度看。


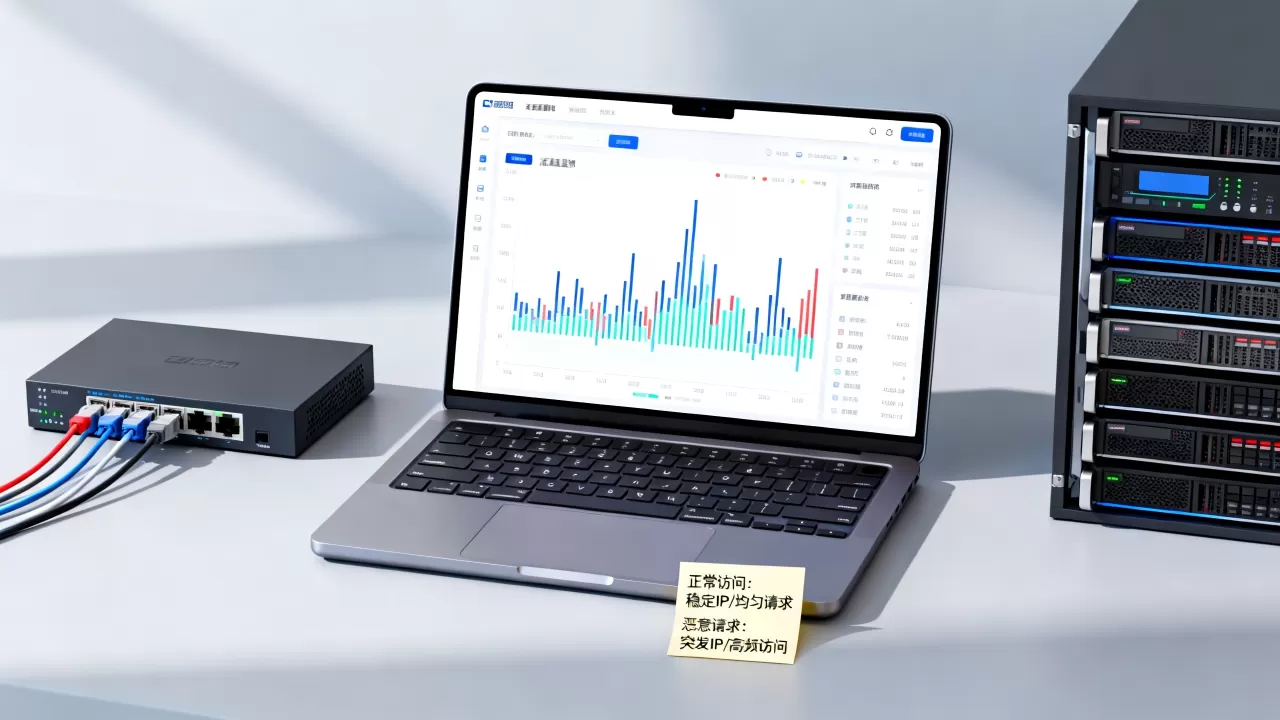
- 来源IP:正常访问的IP通常分散在不同运营商、不同地域;恶意请求往往集中在少数IP或同一C段,比如大量请求来自某个云服务商的一段地址。
- User-Agent:真实用户有不同浏览器、不同版本,UA字符串丰富;恶意脚本多数没有UA,或者长期使用同一个固定UA,甚至伪装成搜索引擎蜘蛛却频繁访问非公开页面。
- 请求路径:正常用户按业务链路走,比如从首页到列表页再到详情页;恶意请求会直接撞击登录接口、注册接口、搜索接口,或者随机生成不存在的路径。
- Referer:真实访问大多带有站内跳转或搜索引擎来源;恶意请求的Referer经常为空,或者伪造为站内地址但请求顺序对不上。
- 请求频率:正常用户单IP每分钟的请求数有限;恶意请求表现为机器节奏,间隔整齐,频率远高于人类点击速度。
这五个字段不是孤立判断,需要组合看,单独字段异常可能是误判,比如公司出口IP会集中大量员工访问,频率高但路径正常,多个字段同时异常,基本可以判定为恶意请求。
网站遭遇异常流量如何排查:从日志里抓出可疑IP
排查异常流量不能靠感觉,日志是最直接的证据,以下步骤以Nginx为例,Apache思路相同,只是日志路径略有差异。
第一步:先看总体状态码分布
awk '{print $9}' /var/log/nginx/access.log | sort | uniq -c | sort -nr | head
Apache环境把日志路径换成/var/log/httpd/access_log即可,这条命令能快速告诉你站点正在经历什么,如果突然出现大量404,大概率是扫描器在猜路径;出现大量502或504,说明后端已经被打到处理不过来;大量
499表示客户端主动断开,常见于CC攻击下用户忍受不了等待时间。
假设输出里404有数千个,而平时只有几十个,那就优先排查扫描器,状态码比例的变化往往比绝对数字更说明问题。
第二步:按IP聚合请求次数
awk '{print $1}' /var/log/nginx/access.log | sort | uniq -c | sort -nr | head -20
输出结果里,排在前面的IP要逐个确认,用下面命令反查IP归属:
whois 203.0.113.10 | grep -E "netname|descr|country"
如果查到是CDN节点、搜索引擎蜘蛛或公司出口,先别封,如果来自一个你从未见过的IDC机房,且请求数远高于其他IP,那它嫌疑就很大,某电商站在大促期间遭遇异常流量,日志聚合后发现前10个IP里有相当一部分来自同一家云厂商的临时IP段,最后确认为竞争对手的爬虫脚本,这种同一段地址集中出现的情况,正常人访问几乎不会发生。
第三步:检查UA和路径的异常组合
awk -F'"' '{print $6}' access.log | sort | uniq -c | sort -nr | head
grep -E "wp-login|xmlrpc|/api|.php" access.log | awk '{print $1}' | sort | uniq -c | sort -nr | head
第一行命令看UA分布,如果某个UA出现次数异常高,记录下来,第二行命令筛选高频撞击动态页面或登录接口的IP,正常访客不会短时间反复请求登录接口,除非忘记密码在重试,但频率也有明显上限。
服务器被攻击和正常访问区别:一张表看懂
| 维度 | 正常访问 | 恶意请求 |
|---|---|---|
| IP来源 | 分散,归属复杂 | 集中,同段地址多 |
| UA | 多样,随设备浏览器变化 | 单一或缺失,常用伪装 |
| 路径 | 符合业务跳转顺序 | 直击接口、随机路径 |
| Referer | 来自搜索引擎或站内 | 空白或伪造 |
| 频率 | 人类点击间隔 | 毫秒级规律请求 |
| 状态码 | 以200为主 | 大量404/5xx/499 |
这张表可以打印贴在工位上,排查时对着日志逐项打勾,比凭经验猜准确得多。
高防服务器上如何快速区分真实用户和CC攻击
流量进入高防机房后,判断逻辑没有本质变化,但多了几个观察维度:连接数、新建连接速率、SSL握手失败率,这三个指标在云控制台通常都有曲线图。
- 连接数:真实用户的连接会建立、传输、断开,连接数有自然波动;CC攻击常常保持大量半开连接,连接数曲线长时间高位不动。
- 新建连接速率:人类访问每秒新建几个连接,攻击工具每秒可以发起几十甚至上百个新连接。
- SSL握手失败率:真实浏览器能完成正常TLS握手,大量脚本发起的握手会失败或中断,失败率会突然升高。
在高防服务器上还可以直接通过命令查看当前连接来源:
netstat -ntu | awk '{print $5}' | cut -d: -f1 | sort | uniq -c | sort -nr | head
如果某个IP连接数占满前列,并且长时间不释放,说明它很可能就是攻击源,真实用户的连接会随着页面加载完成而逐步关闭。
如果业务部署在北京机房,评估防护方案时会被北京高防服务器价格牵动注意力,但价格不是第一判断维度,先看清洗能力、源站隐藏和线路质量。相当一部分中小站长选择基础防御套餐就能覆盖日常攻击,只有遇到大流量DDoS时才需要临时升级清洗带宽。
异常流量清洗费用一般多少:先把防护层级看清楚
异常流量清洗费用一般多少,取决于清洗带宽、防护峰值和地域,行业共识认为,基础高防服务和专业流量清洗是两套逻辑:前者按固定防御峰值收费,后者按实际清洗流量弹性计费。
- 如果只是偶尔遭遇小规模CC攻击,多数情况下在WAF或Nginx层做限速就能解决,成本只是服务器资源。
- 如果攻击峰值超过源站带宽,就需要上高防,此时费用从基础套餐到按天弹性计费都有,大流量清洗价格会显著上升。
- 地域也会影响价格,北京高防服务器价格通常比部分二三线城市机房高一些,但延迟和线路质量更适合北方用户。
核心思路是:先用前面日志排查方法确认攻击类型和量级,再决定是否购买付费清洗,盲目买高防套餐,可能花冤枉钱。
用WAF规则把判断逻辑自动化
人工排查适合应急,长期防护要把判断逻辑写进WAF或Nginx配置。
Nginx限速配置
limit_req_zone $binary_remote_addr zone=one:10m rate=10r/s;
limit_conn_zone $binary_remote_addr zone=addr:10m;
server {
    location /login {
        limit_req zone=one burst=20 nodelay;
        limit_conn addr 10;
    }
}
这段配置的意思是:每个IP对登录接口每秒最多10个请求,突发允许20个,超过直接返回503,正常用户输入账号密码不会触发,暴力破解和CC工具会立刻被限住。
WAF自定义规则示例
- 对UA为空或常见脚本UA的请求,直接拦截。
- 对单IP在1分钟内请求超过一定阈值的,弹出验证码。
- 对访问路径中包含
/wp-admin、/xmlrpc.php、/.env的请求,直接丢弃。
这些规则部署后,异常流量中的大部分会被自动隔离,留下的正常访问不受影响。
判断异常流量里的正常访问与恶意请求,永远回到一个原则:看行为是否偏离业务逻辑,日志、状态码、路径、UA、频率,这些组合起来就是攻击者的指纹,把人工判断沉淀为WAF规则,才能从救火式排查转成长效防护。
遭遇异常流量时怎样区分正常访问与恶意请求?
最直接的方法是查看Nginx或Apache访问日志,用awk按IP、状态码、路径三个维度聚合,如果某个IP请求频率极高、UA缺失、反复撞击登录或搜索接口,基本可以判定为恶意请求,正常访问即使集中,也会遵循页面跳转路径,UA多样,状态码以200为主。
网站遭遇异常流量如何排查最有效?
按“状态码分布→IP聚合→UA路径→响应时间”的顺序排查,先用awk '{print $9}' access.log | sort | uniq -c看状态码,再按IP聚合找出头部请求来源,最后检查UA和路径,这样能在几分钟内定位异常集中在哪一层,避免误封正常用户。
服务器被攻击和正常访问区别有哪些?
服务器被攻击时会出现连接数陡增、新建连接速率异常、大量半开连接、日志中404或5xx比例上升,正常访问时连接建立和释放有自然节奏,IP分散,UA多样,状态码分布相对稳定,结合控制台连接数曲线和日志状态码分布能快速判断。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/654379.html