跑爬虫的日志与监控,VPS真正要解决的是“进程挂了能第一时间知道、日志不丢、排障不翻半天”这三件事;预算有限时优先选SSD型VPS并配合轻量日志采集,比纠结CPU核心数更实际。
爬虫日志监控VPS怎么选:先看三个硬指标
很多爬虫项目在本地跑得好好的,一搬到VPS上就开始出现日志写入变慢、监控漏报、磁盘莫名写满,根本原因是把VPS当成“能联网的电脑”,忽略了日志链路对磁盘和网络的消耗。
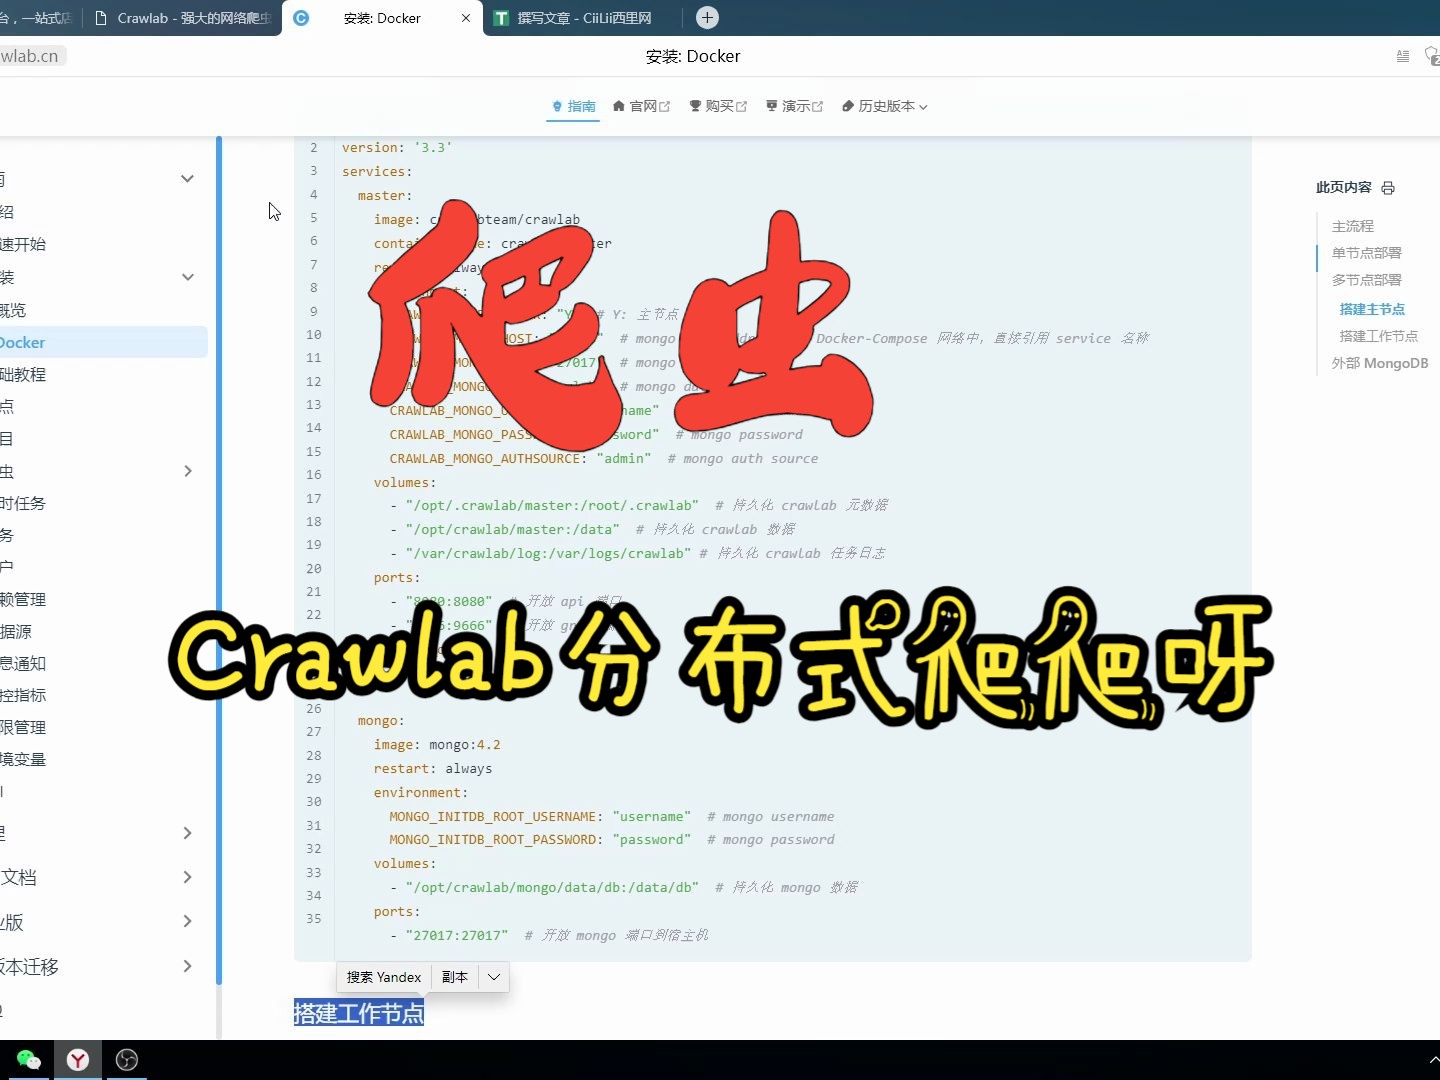

磁盘IO与SSD类型比CPU核心数更关键
爬虫每抓一个URL如果都写一行日志,高频小写入很容易把机械硬盘的IO队列打满,选购时优先看SSD或NVMe,并确认服务商是否标注“I/O不限制”,用iostat -x 1观察await和%util,如果%util长期接近100%,说明磁盘已经是瓶颈,日志目录建议单独挂载在数据盘,别和系统盘混用,否则日志写满后连SSH都可能登不上。
网络出口质量决定日志采集是否“缺帧”
日志推送到外部监控平台时,VPS的上行带宽和跨境丢包会直接影响采集完整性,国内访问多的爬虫任务,选香港或日本等地域VPS,日志回传延迟较低。海外VPS跑爬虫日志监控还要看线路,CN2 GIA或CMI线路对日志推送更友好,普通国际线路晚高峰丢包率升高后,远端监控容易漏掉关键错误日志。
系统日志落盘策略要能扛住进程崩溃
用systemd托管爬虫进程,日志默认进journald,重启后也能查到退出原因,执行journalctl -u crawler -n 200 --no-pager可快速查看最近200行,如果爬虫自己写文件日志,务必在代码里用RotatingFileHandler或TimedRotatingFileHandler,防止单个日志文件无限增长,否则一个运行三天的爬虫,日志文件可能膨胀到几十GB,最后把整个分区写满。
运行Python爬虫用VPS还是云服务器?日志与监控视角的对比
这个问题背后的真实需求,往往不是“哪个更强”,而是“哪个日志好管、告警好接、成本好控”。
日志量中等时,VPS更直观
Python爬虫日志大多在每天几百MB到几个GB之间,VPS的本地SSD足够应对,云服务器往往绑定日志服务、对象存储等组件,功能多但配置链路长;VPS用logrotate一条命令就能切割,行业共识认为,爬虫日志监控最怕的不是磁盘满,而是日志采集链路自身把业务进程拖垮,轻量方案在VPS上更容易实现。
需要长期归档或弹性扩容时,云服务器生态更顺
若日志必须保留半年以上且每天超过10GB,VPS本地盘会很快吃紧,云服务器可以挂载对象存储,把历史日志自动转存,查询时再拉回,但多数个人和小团队爬虫项目,用VPS加定时清理就够了。
| 对比项 | VPS | 云服务器 |
|---|---|---|
| 日志落盘速度 | 本地NVMe快 | 云盘有波动 |
| 日志归档 | 手动/rsync | 对象存储自动 |
| 监控告警 | 自建轻量 | 平台集成 |
| 成本 | 较低 | 按量累加 |
便宜稳定的爬虫VPS推荐场景里,日志与监控告警怎么配
便宜不是只看月付价格,而是“日志不丢、告警不误报”下的稳定,低价VPS磁盘和内存通常比较紧张,更要靠合理的日志策略兜底。
轻量日志采集方案
- 采用Promtail + Loki + Grafana,在VPS上资源占用小,日志全文可检索。
- 或使用Vector单二进制采集,把爬虫日志按标签推到本地Loki或远端。
- 在爬虫日志目录执行
tail -f /var/log/crawler/crawler.log只适合临时排障,不适合长期监控。
监控告警脚本实例
- 守护进程存活:用systemd自带的
Restart=on-failure,再配合crontab每5分钟跑一次健康检查。 - 磁盘使用率超过80%时告警:
df -h /var/log | awk 'NR==2{if($5+0>80) print "disk high"}' - 日志中出现
ERROR或Timeout时通知:tail -n 500 /var/log/crawler/crawler.log | grep -E "ERROR|Timeout",有输出则调用Webhook。 - 将脚本输出接到钉钉、Telegram或邮件,别只写在本地,否则VPS失联时连原因都看不到。
日志轮转与清理
配置/etc/logrotate.d/crawler,按天切割保留7天,压缩历史文件。
/var/log/crawler/.log {
    daily
    rotate 7
    compress
    missingok
    notifempty
}
定期删除大日志前,先确认没有未落盘的缓存,低价VPS磁盘普遍只有20GB到40GB,日志不轮转的话,一次大规模抓取就能写满。
海外VPS跑爬虫日志监控要注意时间戳与出口
海外VPS跑跨境爬虫时,日志的时间戳和网络出口会直接决定排障效率,很多人忽略时区问题,导致告警时间和实际发生时间对不上。
时区与日志时间戳
VPS默认可能是UTC,日志里出现“早上8点”实际是北京时间16点,排障时容易误判,执行timedatectl set-timezone Asia/Shanghai统一时区,或在采集端做时区转换,若爬虫目标站是海外,保留UTC时间戳更方便与对方服务器日志对齐。
跨境网络波动对日志推送的影响
把日志从海外VPS推回国内自建监控,晚高峰可能延迟数秒到数分钟,可以在VPS本地先缓冲,再异步推送;或直接用海外节点接收日志,国内只看告警结果,不要指望一条TCP长连接在跨境链路上永不中断,日志客户端要配置重试和断点续传。
合规与使用边界
只抓公开数据,控制请求频率,避免对目标站点造成压力,日志中若含个人信息,应按最小必要原则脱敏后存储,海外VPS不等同于可以绕过法律,爬虫日志同样要接受监管约束。
把日志当体检报告,VPS才不算白买
VPS不是跑起来就完事,日志和监控是爬虫项目能长期无人值守的底牌,选盘、选线路、配轮转、接告警,四个动作做到位,便宜的VPS也能比贵一倍的云服务器更省心。
爬虫日志与监控用VPS常见问题
运行爬虫的日志与监控用虚拟专用服务器需要多大内存?
轻量Python爬虫通常1GB到2GB内存足够,日志采集组件再占约200MB到500MB,若使用浏览器自动化,建议4GB起步,内存不够时,日志采集进程会被杀,监控链路先断,爬虫本身反而还在跑。
爬虫日志监控VPS怎么排查磁盘写满?
先执行df -h确认分区使用率,再用du -sh /var/log/定位大文件,若是单个日志文件过大,检查是否缺少轮转配置;若是journald日志膨胀,执行journalctl --vacuum-size=200M限制体积,删除文件后若空间未释放,可能是进程仍持有句柄,重启对应服务即可。
便宜爬虫VPS跑日志监控会不会频繁丢日志?
多数情况下不会,前提是使用本地缓冲、断点重传的采集组件,并且日志先落盘再推送,低价VPS磁盘IO和网络抖动较大,但日志文件按天切割并保留7天,配合采集端重试机制,绝大多数轻量爬虫任务不会出现明显丢日志。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/657769.html