用虚拟专用服务器(VPS)跑分布式爬虫节点,本质是把抓取任务拆给多台低配主机,再通过Redis或消息队列统一调度,比单机爬虫更稳定,适合需要高频采集或绕过IP限流的场景,成本也能控制在每月几十元到几百元区间。
单机爬虫和VPS分布式爬虫哪个更稳定?先看三个真实场景
单机爬虫跑小规模测试没问题,但进入生产环境后,稳定性短板会很快暴露,行业共识认为,爬虫的稳定性不只取决于代码,更取决于资源隔离和IP出口分散能力。

- 场景A:电商价格监控,需要每10分钟抓一轮SKU,单机连续跑几小时,目标站点就会开始返回验证码,换到3台VPS节点后,每台只承担三分之一请求,触发风控的概率大幅降低。
- 场景B:舆情关键词采集,关键词多、结果翻页深,单机内存容易爆,分布式节点可以把关键词按哈希分配给不同VPS,每台只维护自己的队列。
- 场景C:海外内容归档,国内服务器访问某些海外站点慢且不稳定,海外VPS节点延迟更低。
单机爬虫和VPS分布式爬虫哪个更稳定?答案在多数情况下是后者,稳定来自两个层面:单节点故障不影响全局,出口IP分散降低封禁概率。
什么情况下必须上VPS分布式节点
- 目标站点对单IP有严格频率限制。
- 任务量需要多账号或多Cookie隔离。
- 需要7×24小时无人值守运行。
- 需要同时抓国内和海外源。
如果只是抓几千条公开列表,单机加上代理池也能应付,但当任务规模上来后,用VPS拆分节点是成本最低的扩展方式。
国内VPS和海外VPS哪个适合爬虫节点?按目标站点选
选错地区会让爬虫节点变成摆设,判断标准只有一条:目标站点在哪里,VPS就尽量靠近哪里。
| 对比项 | 国内VPS | 海外VPS |
|---|---|---|
| 访问国内站 | 快、稳定 |
部分线路绕路、延迟高 |
| 访问海外站 | 受国际出口影响,部分站点慢 | 直连快,适合抓海外源 |
| 备案要求 | 建站需备案,纯计算节点一般不强制 | 无需备案 |
| 价格 | 入门款月付几十元,活动价更低 | 入门款月付几美元到十几美元 |
| IP纯净度 | 数据中心IP,部分站风控识别 | 海外IP池更丰富,可换住宅代理 |
国内VPS和海外VPS哪个适合爬虫节点没有绝对答案,抓国内电商、政务公开数据,选国内VPS;抓Google、跨境电商平台、海外社交媒体,直接开海外VPS。
租用便宜VPS跑爬虫节点多少钱一个月
租用便宜VPS跑爬虫节点多少钱一个月,取决于节点数量和配置,通常分布式爬虫不需要高配,1核1G或1核2G已经足够跑Scrapy或Python脚本。
- 国内轻量应用服务器:活动价常见在几十元一个月,带宽多数为3M到5M,适合中小规模采集。
- 海外VPS:入门款在几美元到十几美元一个月,流量按月给,部分商家不限流量但带宽小。
- 中型节点:2核4G配置月付普遍在几十元到一百多元区间,可以同时跑多个爬虫进程。
如果只是学习或测试,先租两台便宜VPS足够,正式项目再按节点数乘以单价估算,稳定性比省下的十几块钱重要。
动态住宅IP爬虫VPS方案:节点IP轮换怎么做
数据中心IP容易被目标站识别,动态住宅IP爬虫VPS方案的核心是在每个VPS节点上挂独立代理出口,而不是让所有节点共享一个公网IP。
实操路径:
- 给每台VPS安装代理客户端,或直接在爬虫代码里配置
schema://user:pass@ip:port。 - 代理类型选动态住宅IP或动态机房IP,轮换周期控制在5到15分钟。
- 用Redis记录每个节点的当前出口IP,主控分配任务时把域名和IP做哈希绑定,避免同一目标域名短时间内被多个IP集中访问。
- 部分代理服务商提供API接口,可以在爬虫发起请求前自动获取新IP。
如果预算有限,可以先用海外VPS自带IP加代理池混合:高频任务走代理,低频任务走VPS本机IP,这样成本不会失控,出口也足够分散。
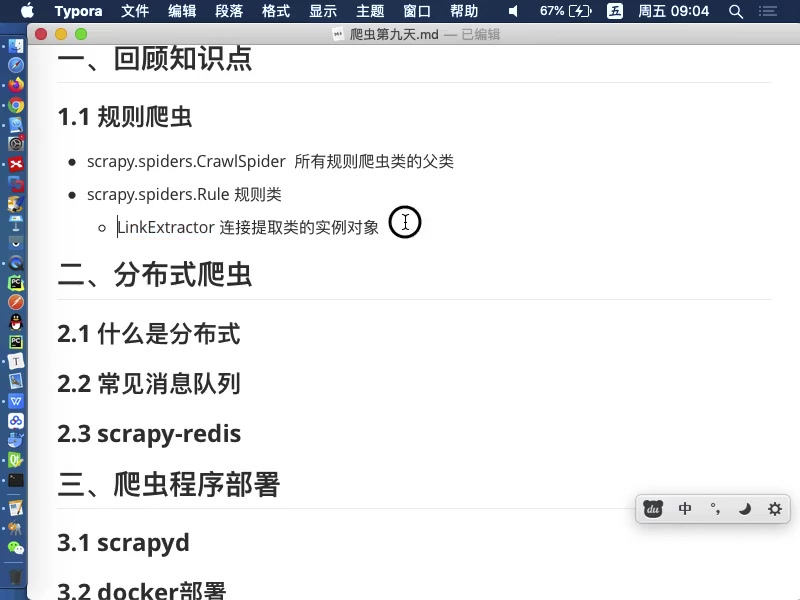
Ubuntu部署Scrapy分布式爬虫教程:从零跑通三个节点
下面以三台Ubuntu 22.04 VPS为例,说明怎么搭建最小可用的分布式爬虫集群。
主节点:安装Redis和Scrapy
sudo apt update
sudo apt install redis-server python3-pip -y
sudo systemctl enable redis-server
pip3 install scrapy scrapy-redis主节点的redis.conf取消bind 127.0.0.1并设置protected-mode no,允许从节点连接。
从节点:安装相同依赖
在另外两台VPS上执行同样的Python依赖安装,确保三台机器能通过内网或公网IP访问主节点Redis端口6379。
改造爬虫项目
在settings.py中加入:
REDIS_URL = 'redis://主节点IP:6379'
SCHEDULER = "scrapy_redis.scheduler.Scheduler"
DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"爬虫类继承RedisSpider,并设置redis_key,主节点和从节点都执行:
scrapy runspider your_spider.py任意一个节点执行redis-cli lpush your_spider:start_urls 起始URL,所有连上同一Redis的节点就会争抢任务,实现分布式抓取。
用Docker简化部署
如果不想逐台配置,可以写一个Dockerfile,基础镜像用python:3.11-slim,安装依赖后通过docker run启动,主节点再单独跑一个redis:7容器,这个方式在节点数量超过五台以后维护成本更低。
常见踩坑与性能调优
- 文件描述符限制:Linux默认限制可能让高并发爬虫直接报错,执行
ulimit -n 65535临时放开,长期修改
/etc/security/limits.conf
- Redis内存:分布式去重集合会持续增长,给Redis设置
maxmemory和maxmemory-policy allkeys-lru,防止内存写穿。 - 并发与延迟:单节点并发不要盲目拉高,多数VPS的CPU和带宽有限,1核1G机器建议并发数设置在8到16之间。
- 代理超时:动态代理响应慢会拖垮整个队列,在请求中间件里设置
DOWNLOAD_TIMEOUT = 15,超时自动重试。 - 出口IP检查:部署完成后在每个节点执行
curl ifconfig.me,确认出口IP符合预期,避免所有节点仍走同一IP。
借助虚拟专用服务器运行分布式爬虫节点,核心不是堆机器数量,而是把调度、去重、IP轮换拆清楚,主节点只负责任务分发,从节点专注抓取,故障随机一台也不影响整体进度,按目标站点选对VPS地区,再配合代理池,多数采集任务就能稳定跑起来。
Q&A:借助虚拟专用服务器运行分布式爬虫节点常见问题
租用VPS跑爬虫节点需要备案吗?
如果使用国内VPS对外提供网站服务,需要完成ICP备案,但纯作为爬虫计算节点、只出站访问目标网站,不绑定域名提供Web服务,多数情况下不强制备案,具体以云服务商和当地通信管理局要求为准。
分布式爬虫节点越多速度越快吗?
不是线性关系,节点增加后,调度和去重带来的Redis压力也会上升,目标站点风控触发概率可能同步变大,多数中小型采集任务用3到5个低配VPS节点就能达到不错的吞吐,继续堆节点反而会增加代理和运维成本。
用海外VPS爬国内网站会被墙吗?
海外VPS访问部分国内网站会经过国际线路,存在延迟高、连接超时、触发风控等情况,部分国内站点还要求国内IP才能返回完整数据,海外VPS可能只能拿到降级页面或验证码,抓取国内公开数据时,优先用国内VPS加代理更稳妥。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/657952.html