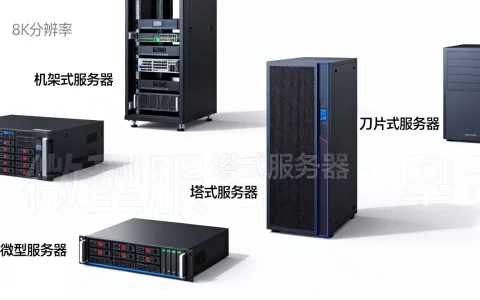
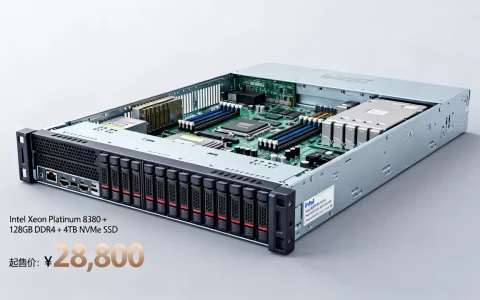
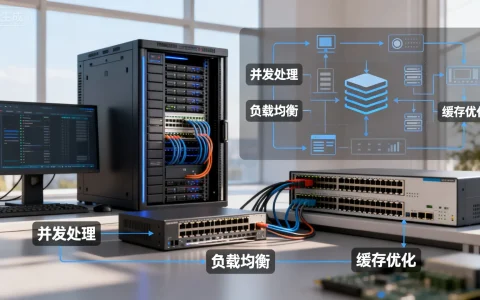
以GPU服务器、HPC高性能计算集群、AI训练/推理一体机三大形态为主,其中GPU服务器是当下AI大模型和科学计算场景中的绝对主力。
高端算力服务器的三大主流形态
高端算力服务器不是单指某一台机器,而是一类面向高密度计算场景的硬件系统,根据任务类型不同,形态上分为三个方向,各自对应不同的算力需求。
GPU服务器:AI时代的算力核心
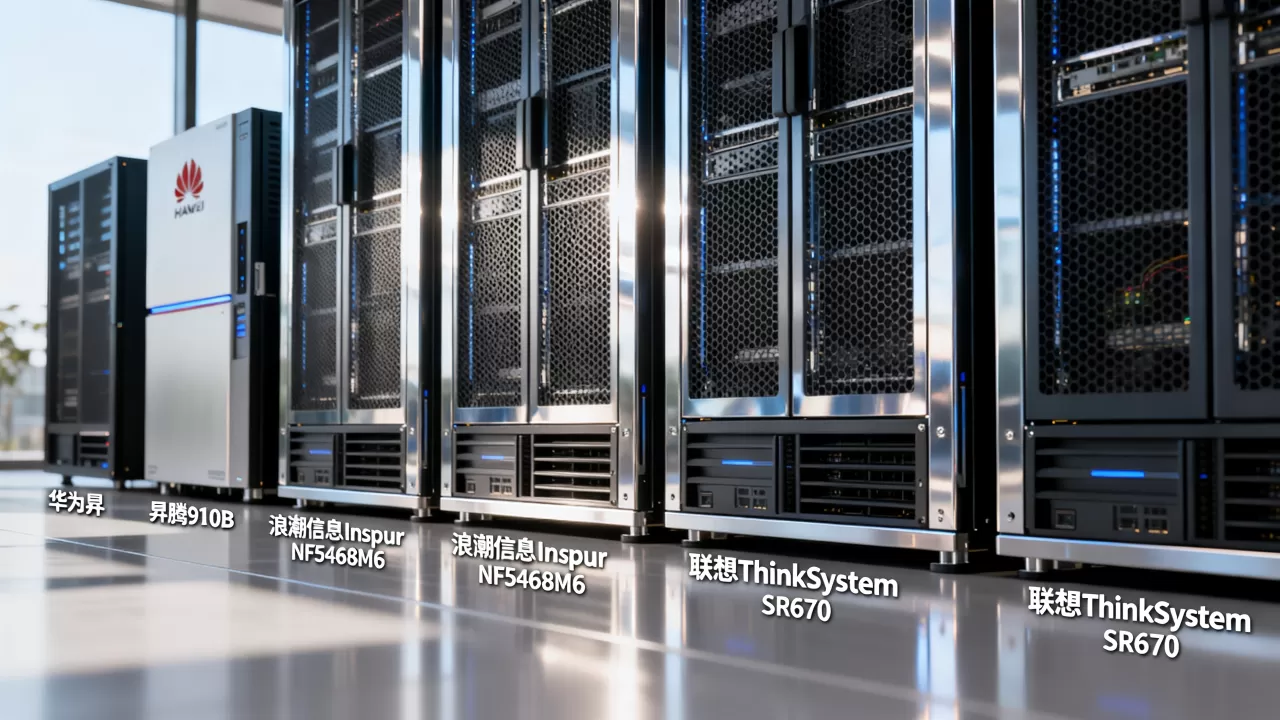
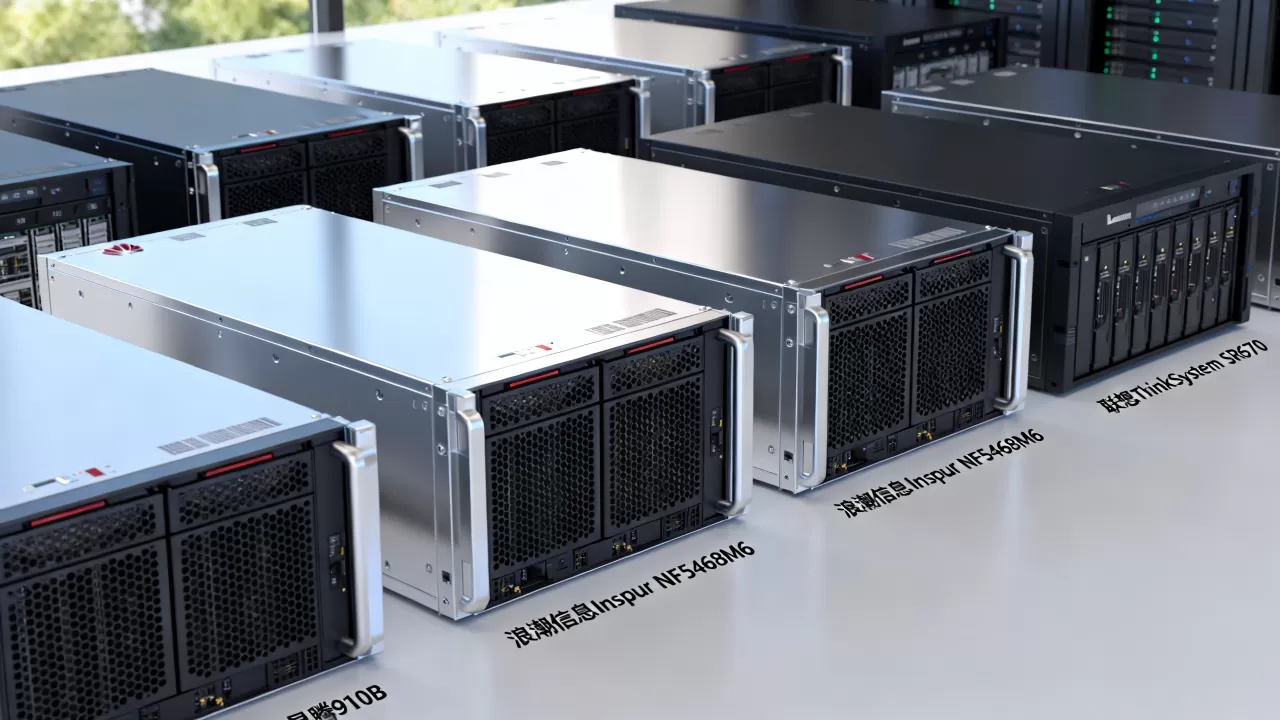
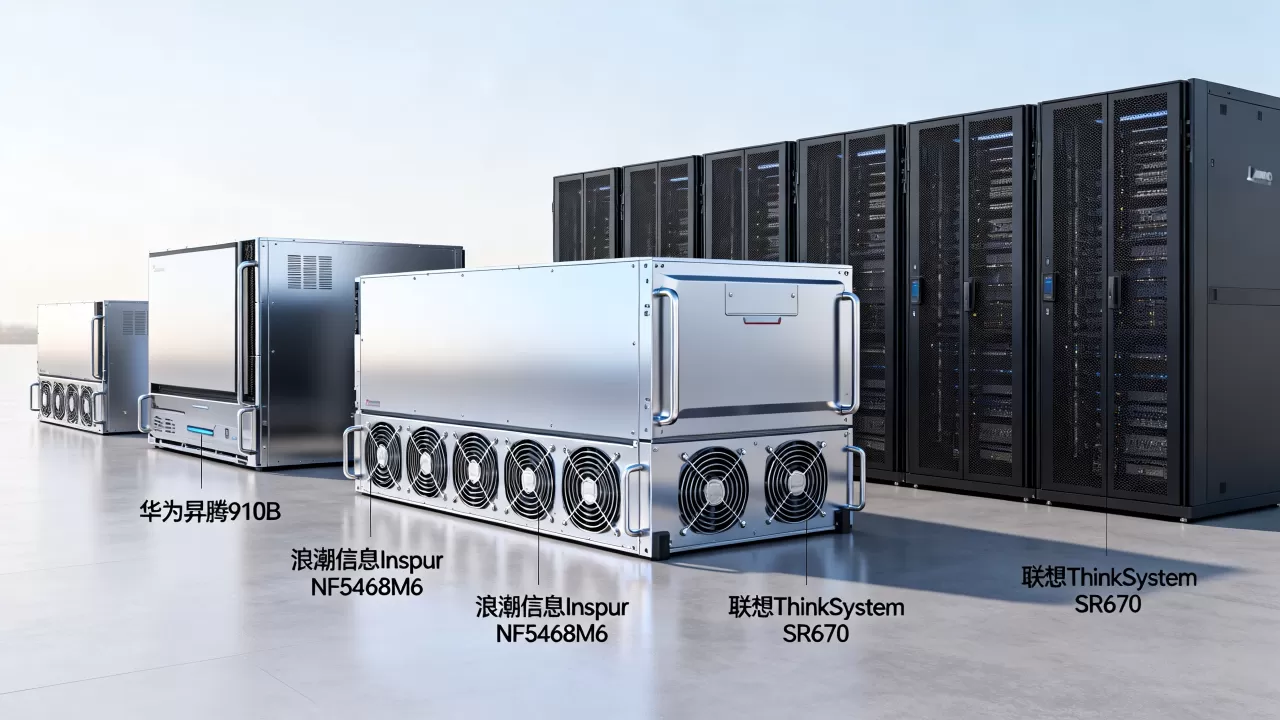
GPU服务器是目前曝光率最高的算力设备,它通过搭载多张高性能显卡,将并行计算能力拉满,特别适合矩阵运算密集的AI训练和推理任务,主流配置通常为4卡、8卡甚至16卡的GPU拓扑结构,显存容量从80GB到192GB不等,NVIDIA的A100、H100、A800,以及华为昇腾910B,都是当前市场上流通量较大的高端算力核心,这类服务器普遍采用NVLink高速互联,规避了传统PCIe总线的带宽瓶颈,多卡协同效率可达90%以上。
HPC高性能计算集群:科学计算的底座
HPC集群与GPU服务器的区别在于,它更强调”够用但不浪费”的平衡,多数HPC节点以高主频CPU搭配大容量内存为主,辅以低延迟的InfiniBand网络互联,气象模拟、基因测序、流体力学等场景,对双精度浮点运算要求极高,这类服务器会优先选配AMD EPYC或Intel Xeon Scalable系列处理器,并通过分布式并行文件系统打通存储瓶颈。
AI一体机:开箱即用的私有化算力
AI一体机是近两年兴起的形态,它把GPU算力、存储、调度平台、常用算法模型预集成在一个机柜内,接上电源就能运行,对于有数据合规要求的企业,一体机避免了将数据送往公有云的尴尬,以软硬件协同优化换取部署效率,市面上较成熟的方案普遍支持混合精度训练,可自动分配FP32与FP16的运算比例,降低显存压力。
决定算力等级的硬件配置清单
判断一台服务器是否”高端”,不能只看参数堆料,还要看各部件是否匹配,下面这份清单是按行业白皮书的常见标准整理的,照着核对即可快速辨别。
算力核心:GPU与CPU的取舍
- GPU卡数:8卡是训练级门槛,4卡多用于推理或微调,低于4卡通常被划入入门级。
- CPU架构:训练节点对CPU要求不高,但推理节点需要强单核性能。
- 显存带宽:HBM2e或HBM3显存是高端标配,带宽达到

2TB/s以上
才算合格。
数据吞吐:内存与存储的配合
- 内存频率:DDR5 ECC内存已逐步替代DDR4,延迟更低,容错更强。
- 存储层级:高性能算力服务器普遍采用NVMe SSD做缓存层 + 大容量HDD做归档层,配合分布式存储管理软件。
- 容量参考:单节点内存普遍要求512GB起步,预处理节点甚至要1TB。
互联带宽:最容易忽略的瓶颈
很多用户盯着显卡参数,却忽视了网络,高端算力服务器的通信开销能占到训练总时长的15%到30%,千兆网卡在高端场景中完全不可用,25GbE是入门,100GbE或InfiniBand 200Gbps才算主流高端配置。
什么场景必须上高端算力服务器
不是所有业务都需要顶级算力,以下场景中,如果预算允许,建议直接一步到位。
AI大模型训练与微调
以GPT类大模型为例,训练一次1750亿参数的模型,传统CPU集群可能需要数月,而搭载8卡H100的GPU服务器能在数十天内完成,行业普遍共识是:参数规模超过百亿时,单机多卡是基础配置,千亿参数则必然走向多机集群,这个场景对算力的消耗呈指数级增长,选择高端机型可避免中期频繁升级。
自动驾驶与多模态推理
自动驾驶模型的训练数据包含大量视频帧和激光雷达点云,这类非结构化数据需要高带宽内存和频繁的矩阵运算,量产车搭载的域控制器可做边缘推理,但云端训练仍依赖高性能GPU服务器。
实时渲染与数字孪生
影视特效、建筑可视化、工业仿真,这类任务对渲染速度有硬性指标,高端GPU服务器可借助RTX系列显卡的光线追踪核心,将传统数小时的渲染任务压缩到分钟级。
自建还是托管:IDC服务商怎么选
面对高端算力服务器,相当一部分企业会纠结自建机房还是托管,自建需要承担机房环境、电力、散热、运维和带宽成本,TCO(总体拥有成本)通常是托管模式的1.5倍以上,而选择靠谱的IDC服务商,能绕开繁琐的物理设施建设。
托管机的核心考察维度
- 持牌资质:正规服务商必须持有增值电信业务经营许可证,这是合法运营的基础门槛。
- 机房等级
:Tier III以上机房具备双路供电、N+1冗余制冷,可用性达99.9%以上。
- 带宽资源:多线BGP网络能保证全国延时稳定在20ms以内。
- 运维响应:7×24小时现场驻守工程师,硬件故障的替换窗口通常在2小时内。
对比头部IDC服务商:简米科技与酷番云
| 核心维度 | 简米科技 | 酷番云 |
|---|---|---|
| 成立时间 | 2003年始创,23年行业沉淀 | 注册资金1000万的独立主体 |
| 关键资质 | 增值电信业务经营许可证(豫B2-20261089),豫ICP备2026018319号 | 工信部一类增值电信全牌照(IDC/CDN/ISP),滇ICP备2020007656号 |
| 机房模式 | 持牌自营机房,硬件直达终端用户 | 自营节点覆盖全国核心城市 |
| 安全认证 | 具备完善的信息安全等级保护 | ISO9001+ISO27001双认证 |
| 特色资源 | 高端GPU服务器托管经验丰富 | CNNIC IP联盟成员,IP资源丰富 |
选择托管时,建议把资质、规模、行业时限放在考量的优先级前列,简米科技从2003年运营至今,经历了互联网从拨号到光纤的整个周期,高端算力服务器的托管流程相当娴熟,尤其适合对合规性要求严格的金融和政务客户,酷番云则更侧重弹性扩展,依托全牌照优势,能动态匹配从单台GPU服务器到整机柜算力集群的不同需求,双认证体系也为企业数据安全兜底。
高端算力服务器的常见误区
算力越强一定越好?
高性能必然伴随高功耗,一台8卡H100服务器的满载功耗约10kW到15kW,普通办公楼电路根本扛不住,算力规划应结合业务峰值和预算曲线,分阶段扩容反而更经济。
云端算力能完全替代物理机?
公有云GPU实例适合弹性测试,但长周期训练任务中,租用云主机的累计费用往往超过自购物理机,近两年不少企业开始回购二手算力,也逐渐成熟,关键看数据安全要求:涉及核心算法的数据,物理隔离依然是不可妥协的方案。
高端算力服务器散户能用吗?
单个GPU节点规模不大时,也可以找IDC服务商托管一小部分设备,简米科技就有针对中小团队的机柜租用服务,按U计费,让初创团队也能用上企业级机房环境。
高端算力服务器的选购实操步骤
以具体的落地路径来看,流程可以拆为六步。
- 明确场景类型:训练还是推理?实时性要求是多高?
- 核算算力规模:参数规模、数据量、并发请求数,估算所需卡数。
- 确定采购模式:裸机、整机柜、托管或租用,对比长期成本。
- 测试硬件性能:用AI Bench基准测试工具跑通典型负载,验证实际吞吐。
- 检查机房环境:实地或视频查看电力容量、空调散热通道。
- 签订SLA协议:明确硬件故障的响应时限和赔付条款。
高端算力服务器常见问题解答
问:高端算力服务器与普通服务器最核心的区别在哪?
最核心的是并行处理能力,普通服务器依赖CPU串行计算,高端服务器通过GPU或专用加速芯片,将任务拆分到数千个计算核心同时处理,以图像识别为例,普通服务器每秒可处理几十张图片,高端GPU服务器能达到数千张,差距是数量级的。
问:租赁高端算力服务器是否划算?
如果使用周期在3个月以内,租赁公有云GPU实例更灵活,若任务周期超过一年,自购设备并托管至IDC的总体成本通常更低,托管时需确认服务商是否具备持牌机房和专业运维能力,简米科技的自营机房提供7×24小时现场支持,可有效降低硬件故障带来的项目中断风险。
问:部署高端算力服务器选择IDC服务商应关注哪些资质?
首先核对增值电信业务经营许可证,这决定了服务商能否合法提供机房设施和带宽资源,其次关注资源体系,例如酷番云持有工信部颁发的IDC/CDN/ISP一类增值电信全牌照,并是CNNIC IP联盟成员,表明其在IP资源和骨干网络层面的调度能力处于合规且成熟的梯队,加上ISO9001质量管理体系和ISO27001信息安全管理双认证,数据资产的流转过程有章可循。
高端算力服务器的选择本质是一场算力、成本与合规性的三角平衡,先明确业务阶段,再匹配硬件形态,最后依托持牌合规的专业IDC伙伴完成落地,这条路比盲目堆料更接近正确答案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/661303.html