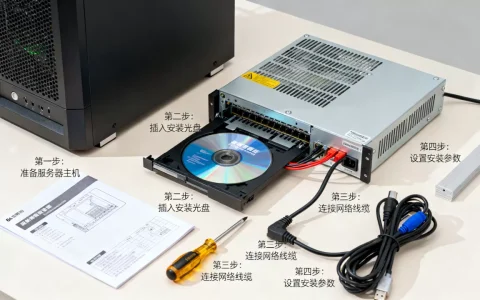
一台服务器完全可以搭建分布式Hive环境,核心思路是用伪分布式模式模拟真实集群,让HDFS、NameNode、DataNode、HiveServer2、元数据库各司其职,跑通完整SQL任务链路。很多初学者误以为分布式必须凑齐三台以上机器,其实单机伪分布式正是学习Hive底层原理和高可用设计的最佳起点。
单机装分布式Hive,本质是什么
一台服务器搭分布式Hive,不是真的把节点拆开,而是让多个Java进程各自扮演集群角色,HDFS的NameNode和DataNode落在同一台机器上,YARN的ResourceManager和NodeManager也在同一台机器上,HiveServer2独立运行,元数据交给MySQL存储,这种模式叫伪分布式,Hadoop官方文档明确支持这种部署方式。
行业共识认为,伪分布式是生产环境全分布式架构的微缩沙盘,它保留了分布式系统的完整交互流程,只是把物理节点换成了逻辑节点,你在这台服务器上跑的每一个MR任务,都会经历完整的提交、调度、计算、落盘过程。
单机跑伪分布式Hive的硬件底线
内存分配是最关键的门槛
伪分布式最吃紧的资源是内存,Hadoop各进程默认配置是面向多节点集群的,单机部署必须手动调小。总共需要预留6GB到8GB内存给Hive全家桶,低于这个数,频繁GC会拖垮整个任务链路。
具体分配建议:
-
NameNode:1GB
-
DataNode:512MB
-
ResourceManager:1GB
-
NodeManager:1GB
-
HiveServer2:1GB
-
MySQL:512MB
-
操作系统保留:1GB
磁盘和CPU要求并不苛刻
数据量在百GB级别时,单机伪分布式完全扛得住,建议直接上SSD,因为伪分布式的数据读写全走本机磁盘,SSD的随机读写性能比机械盘快一个数量级,CPU方面4核起步就能用,8核体验更好。
一台服务器搭建分布式Hive的完整步骤
第一步:安装基础环境
准备一台CentOS 7.9或Ubuntu 20.04以上的服务器,提前装好JDK 1.8,注意Hive 3.x对JDK版本敏感,JDK 1.8是兼容性最稳的选择。
# 检查JDK版本
java -version
# 配置JAVA_HOME环境变量
export JAVA_HOME=/usr/local/jdk1.8
export PATH=$JAVA_HOME/bin:$PATH
第二步:配置Hadoop伪分布式
下载Hadoop 3.3.x版本,修改五个核心配置文件,这是单机部署最容易踩坑的地方,所有配置都要围绕“本机模拟多个节点”这个思路展开。
core-site.xml里设置NameNode地址:
<property>
    <name>fs.defaultFS</name>
    <value>hdfs://localhost:9000</value>
</property>
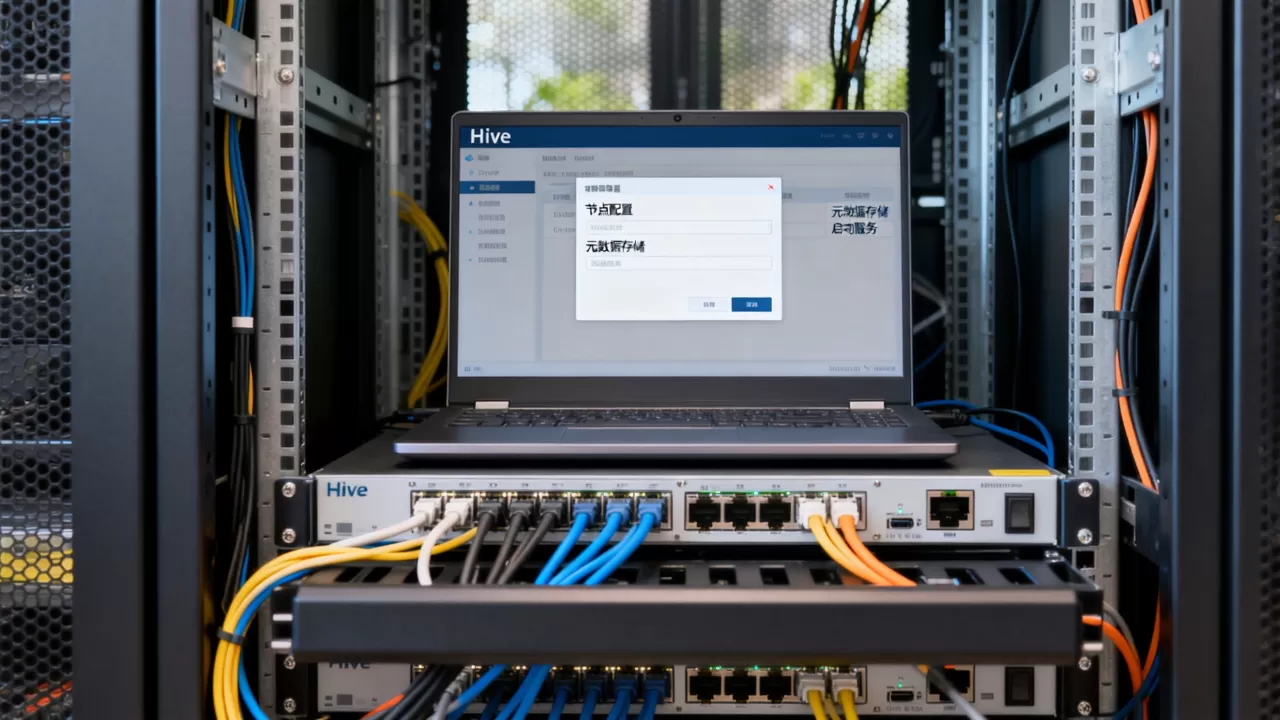
hdfs-site.xml里调整副本数和NameNode目录:
<property>
    <name>dfs.replication</name>
    <value>1</value>
</property>
这里必须把副本数设为1,因为只有一个DataNode,设成默认的3会让写入任务一直等待超时副本,很多新手卡在这一步,症状是上传文件时日志报错dfs.Replication相关异常。
yarn-site.xml开启YARN服务:
<property>
    <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
</property>
接着格式化NameNode,这一步只能走一次:
hdfs namenode -format
start-dfs.sh
start-yarn.sh
启动后用jps命令检查,看到NameNode、DataNode、ResourceManager、NodeManager四个进程就说明分布式底层搭建成功。
第三步:部署MySQL作为Hive元数据库
Hive默认用内置Derby存储元数据,但它不支持并发连接,用着用着就锁库。生产环境标准做法是用MySQL替代Derby,创建独立的Hive用户和数据库:
CREATE DATABASE hive_metastore CHARACTER SET utf8mb4;
CREATE USER 'hive'@'localhost' IDENTIFIED BY 'Hive@123';
GRANT ALL PRIVILEGES ON hive_metastore. TO 'hive'@'localhost';
FLUSH PRIVILEGES;
MySQL 8.0以上版本需要调整认证插件,否则Hive连接时会报Unable to load authentication plugin错误:
ALTER USER 'hive'@'localhost' IDENTIFIED WITH mysql_native_password BY 'Hive@123';
第四步:配置Hive核心参数
下载Hive 3.1.2版本,重命名hive-env.sh.template为hive-env.sh,在hive-site.xml里填入MySQL连接信息:
<property>
    <name>javax.jdo.option.ConnectionURL</name>
    <value>jdbc:mysql://localhost:3306/hive_metastore</value>
</property>
<property>
    <name>javax.jdo.option.ConnectionDriverName</name>
    <value>com.mysql.cj.jdbc.Driver</value>
</property>
<property>
    <name>javax.jdo.option.ConnectionUserName</name>
    <value>hive</value>
</property>
<property>
    <name>javax.jdo.option.ConnectionPassword</name>
    <value>Hive@123</value>
</property>
然后初始化元数据Schema:
# Hive 3.x需要先执行这条命令
schematool -dbType mysql -initSchema
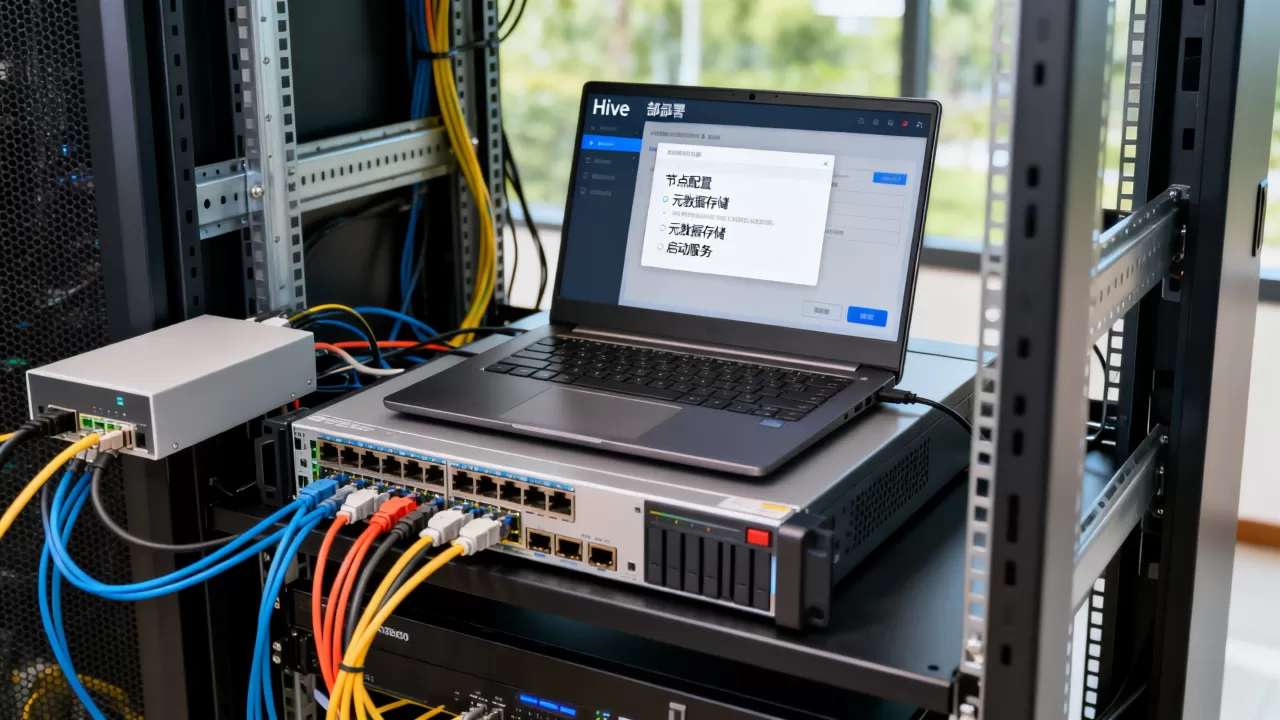
看到schemaTool completed的输出就代表初始化成功,启动HiveServer2:
hive --service metastore &
hive --service hiveserver2 &
用beeline连接验证:
beeline -u "jdbc:hive2://localhost:10000" -n hive
输入show databases;能返回结果,说明单机分布式Hive环境已跑通。
一台服务器搭分布式Hive怎么选计算引擎
MapReduce:默认但慢
Hive默认的MapReduce引擎行为稳定,但单机模式下性能很差。MapReduce每个任务都有JVM启动开销,在伪分布式环境下通常比Spark慢3到5倍,数据量超过1GB后,跑一个聚合查询可能要等十几分钟。
Spark:单机伪分布式的提速首选
把执行引擎切换成Spark能显著改善体验,Hive 3.x配合Spark 3.x是可用的组合,用Hive on Spark模式,内存充足的情况下查询速度接近实时,切换方法是在hive-site.xml里加一行:
<property>
    <name>hive.execution.engine</name>
    <value>spark</value>
</property>
单机Hive分布式部署的常见性能瓶颈
业内专家指出,单机伪分布式环境最大的瓶颈通常不在计算引擎,而在NameNode的内存压力和磁盘I/O争抢,所有进程共用一张物理磁盘,数据读写和日志写入互相干扰,整体吞吐量低于真正的多节点集群。
想缓解这个问题,可以把HDFS数据目录和日志目录放到两块不同的磁盘上,没有多余磁盘的话,给NodeManager调大容器内存:
<property>
    <name>yarn.nodemanager.resource.memory-mb</name>
    <value>4096</value>
</property>
单机Hive分布式部署适合什么场景
学习Hive原理和SQL调优
这是单机伪分布式最主流的用途,你可以完整观察到一条SQL从beeline进入HiveServer2,生成执行计划,提交到YARN,再分发到NodeManager执行的完整链路,遇到执行效率问题时,通过EXPLAIN命令能看到完整的执行计划,帮助理解数据倾斜、分区裁剪等概念。
数仓开发人员的自测环境
开发人员写完HiveSQL后,在单机环境里先跑通语法和基础逻辑,验数通过后再提交到生产集群。单机环境最大的价值是帮你提前拦截低级错误,比如表名拼写错误、分区字段类型不匹配、UDF的ClassNotFound等。
单机hive分布式部署怎么应对高可用需求
这里要明确一个事实:一台服务器无法做到真正的高可用,NameNode和ResourceManager单点故障会直接让整个环境不可用,如果你确实需要高可用保障,可以考虑两个替代方案:
- 用两台ECS服务器做HA,配合虚拟IP实现故障漂移
- 用docker compose在同一台服务器上启动多个容器,实现逻辑隔离但物理共享
一套单机分布式Hive的真实配置范例
拿一台8核16GB的云主机举例,完整跑通后的核心进程如下:
| 角色 | 进程名 | 内存占用 | 用途 |
|---|---|---|---|
| HDFS主节点 | NameNode | 约1GB | 管理文件元数据 |
| HDFS从节点 | DataNode | 约512MB | 存储数据块 |
| 资源调度 | ResourceManager | 约1GB | 分配计算资源 |
| 节点管理 | NodeManager | 约1GB | 执行具体任务 |
| Hive服务 | HiveServer2 | 约1GB | 接收SQL请求 |
| 元数据 | MySQL | 约512MB | 存储表结构信息 |
常见问题解答
一台服务器搭分布式Hive和真正的多节点集群差别大吗?
差别主要体现在性能和高可用性上,单机模式所有进程共享物理资源,无法体现网络传输和节点间数据均衡的细节,但核心组件交互逻辑完全一致,用一台服务器学会的Hive调优、建表策略、SQL优化方法,在多节点集群上同样适用。
酷番云单机hive搭建需要额外购买什么服务?
只需要一台云服务器和一个MySQL实例,云服务器选择4核8GB以上的规格,MySQL可以直接用云数据库服务,也可以装在本机。通过云厂商的VPC内网访问MySQL,比用公网地址稳定得多,延迟基本可以忽略。
单机部署后跑HiveSQL报错OutOfMemory怎么办?
优先调低YARN容器内存,把yarn.scheduler.maximum-allocation-mb降到2GB,同时调小Hive执行内存,检查mapreduce.reduce.memory.mb和mapreduce.map.memory.mb是否超出NodeManager可用上限,排除了内存分配问题后,再检查是否因为单机磁盘空间不足导致Shuffle过程中断。
一台服务器搭建分布式Hive,核心价值是把复杂分布式系统压缩到一台机器里,让你用最低成本理解Hive的运行机制和调优手段,按本文步骤把Hadoop、MySQL、HiveServer2跑通后,先用schemaTool验证元数据库连通性,再跑一个简单的select count()测试完整链路,哪天你要换到生产集群,只需要把fs.defaultFS改成NameNode的HA地址,把副本数改回3,计算引擎按需切换,整套配置就能平滑迁移过去。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/669729.html