南京AI推理服务器租用一年费用,先把GPU卡、配套资源、带宽和运维拆开算总账,再按调用量或独占时长分摊到业务,单卡年成本常见在几万元到十几万元,长期合约和本地化部署能再压一截。
南京AI推理服务器租用一年多少钱:总成本不是只有卡钱
很多团队第一次租AI推理服务器,只盯着单卡月租,年底算账才发现总支出比预期高一截,推理服务器租用成本怎么算?先把这四块拆开。
- GPU卡租金:占大头,推理卡和训练卡价格差不少,不能拿训练卡价格套推理场景。
- CPU/内存/存储配套:整机租用时通常包含基础配置,但独享高配存储或增加内存会额外计费。
- 网络带宽:按固定带宽或实际流量计费,南京本地IDC多数提供BGP多线,固定大带宽更贵但延迟更稳。
- 运维与技术支持:基础运维免费,深度调优、驱动升级、私有化部署可能单独报价。
单卡与整机两种租法的年度差异
南京本地算力服务商通常支持单卡租用和整机租用,单卡租用灵活,适合初期测试或小批量推理,中间可以换卡型,但单价略高,整机租用适合稳定生产和高并发推理,折算到单卡成本更低,但通常需要一次锁定半年或一年。
| 租用方式 | 适用场景 | 年度成本特征 |
|---|---|---|
| 单卡租用 | 初期测试、小批量推理、模型迭代 | 月租几千到一万出头,按卡时弹性 |
| 整机租用 | 稳定生产、多模型在线、高并发 | 月租较高,折算到单卡更便宜 |
南京AI推理服务器租用费用怎么摊到业务:三种分摊方法
“怎么摊”比“怎么算”更难,核心逻辑是:先算出年度总成本,再按实际消耗分到每条业务线,不要用平均摊,那会让低负载项目多花钱,高负载项目说不清。
按推理调用量分摊
适合多条业务线共享一台推理服务器,先把年度总成本除以总调用次数,得到单次推理成本,再按各业务线的调用量乘以单价,就是该业务线应摊费用。
假设一台整机年成本30万元,全年有效调用2000万次,单次推理成本就是0.015元,某业务线调用500万次,应摊7.5万元。
- 统计口径建议用“有效token数”或“成功请求数”,不要包含失败重试。
- 在vLLM或Triton Inference Server日志里能直接抓到每次请求的输入输出token数。
- 操作路径:登录推理服务所在服务器,抓取请求日志,按
prompt_tokens和completion_tokens字段累加统计。
按独占时长分摊
适合一个团队一段时期独占GPU卡,把单卡月租或整机月租折算到小时,再按各业务线独占的小时数分摊。
公式参考:单卡小时成本 = 单卡月租 ÷ 720小时,实际服务商可能按自然月30天计算,独占时长从控制台资源调度记录里导出即可。
按项目预算占比分摊
适合多个并行项目共同承担一整年的服务器租用,先确定年度总预算,再按各项目在算力评审会上确认的用量权重分比例,这个方法偏管理,但对AI推理这种弹性负载,建议每月用调用量回填修正一次,避免占比跑偏。
南京GPU服务器租用费用对比:按卡型看年度成本
南京GPU服务器租用费用对比,主要看卡型、显存和推理吞吐,不要拿训练卡价格直接套推理场景,大多数推理任务用INT8量化或FP16就能跑,不需要A100/H800满血训练卡。
常见推理卡型的适用场景
- A100 80G:适合大模型高并发推理,显存大,但租金高,适合核心生产环境。
- L40S:适合多模态和图形类推理,显存带宽表现好,单卡成本相对可控。
- 4090/4080消费卡:适合小模型、单机测试、低频调用,但南京IDC正规租用渠道里消费卡选择较少,多数是自备服务器托管。
- 国产推理卡:越来越多南京本地服务商提供昇腾、昆仑芯等方案,生态适配需要额外投入,但长期成本可能更低。
年度成本区间参考
下面用模糊区间给个大致概念,具体价格以实际服务商报价为准。
| 卡型 | 单卡月租大致区间 | 一年费用大致区间 |
|---|---|---|
| 高端推理卡(80G显存) | 大几千到一万多 | 几万到十几万 |
| 中端推理卡(24G-48G) | 两三千到五六千 | 两万多到六七万 |
| 消费级卡(10G-24G) | 千元以内到两千 | 一万到两万左右 |
这个表不是报价单,而是帮助你判断预算量级,南京本地IDC之间的差价主要来自机柜位置、电力冗余和网络质量。
南京AI算力租赁哪家便宜:地域价格差异与合约定价
“南京AI算力租赁哪家便宜”这个问题没有固定答案,南京作为东部算力节点,本地服务商在时延和运维响应上有优势,但价格未必比中西部便宜,多数情况下,同配置服务器在南京的溢价体现在低延迟接入和本地工程师上门。
影响南京本地租用价格的因素
- 数据中心位置:江北新区、江宁等区域机柜资源不同,电力成本有差异。
- 合约周期:包年通常比月付便宜,长期合约能谈下一定折扣,但幅度不会太夸张。
- 是否含运维:基础运维免费,深度调优和推理加速优化可能按项目收费。
- 带宽费用:固定大带宽比按流量计费更适合稳定推理,前提是带宽利用率高。
压低年度费用的实操技巧
- 优先选推理场景专用的半精度算力,不要为训练级浮点性能多付钱。
- 错峰使用:如果业务只在白天有调用高峰,可以考虑闲时租用。
- 把多个小业务合并到一台整机,用Kubernetes或vLLM多模型部署,提高GPU利用率。
- 签年度框架协议前,要求服务商提供资源利用率报告,按实际使用调整配额。
实操步骤:建立南京AI推理服务器一年费用分摊表
管理费用分摊不能靠口头,建议每年初建一张电子表格,按月或按季度更新,下面是具体操作顺序。
- 在算力平台控制台导出全年计费明细,字段至少包含资源ID、卡型、时长、费用、项目标签。
- 把每笔费用归类到四个成本项:GPU租金、配套资源、带宽、运维。
- 确定分摊维度:调用量、独占时长、项目权重,三选一或组合使用。
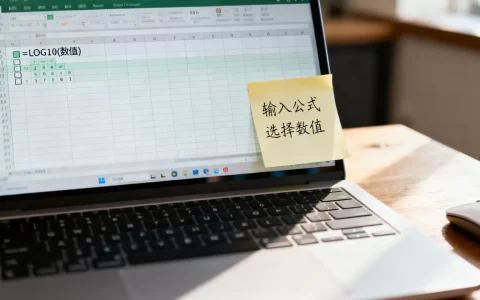
- 用公式计算每个业务线的分摊金额,例如在表格里用
=总成本该业务调用量/总调用量。 - 每月核对一次实际调用量,偏差超过可接受范围就调整下月系数。
用命令辅助核查调用量
如果推理服务部署在南京本地机房或云主机上,可以直接在服务器上拉取日志统计,以vLLM为例,服务启动时保留请求记录用于分账,统计当天请求总数可以执行:
grep "POST /v1/completions" /var/log/vllm.log | wc -l
统计token消耗需要按日志里的 prompt_tokens 和 completion_tokens 字段累加,建议用Python脚本自动化处理,这样分摊依据可验证,财务和业务方都看得明白。
把一年费用摊明白,关键是先拆总账,再选对分摊维度,最后每月核对,南京本地AI推理服务器租用,单卡年成本几万到十几万,整机更高,但合理分摊后能看清每块钱花在哪。
南京AI推理服务器租用一年费用怎么摊:常见问题解答
南京AI推理服务器租用一年费用包含哪些项目?
主要包括四块:GPU卡租金、CPU/内存/存储配套、网络带宽、运维服务,其中GPU卡租金占大头,带宽和运维容易被忽略,签合同前要确认报价单里是否包含系统重装、驱动升级和故障响应。
推理服务器租用成本怎么算才不被坑?
先算单卡月租,再乘以12,再加上配套和带宽,不要只看首月优惠。把年度总成本除以实际可用的GPU小时数,得到每小时真实成本,再对比多家南京本地服务商的有效算力单价,而不是只比月租数字,行业共识认为,推理场景关注吞吐和延迟,单独比价格没有意义。
南京AI推理服务器租用一年,按调用量还是按独占时长更划算?
调用量波动大的业务按调用量分摊更合理,能避免低负载时多摊钱,负载稳定、持续满负荷的业务按独占时长更划算,因为能享受整机或长租折扣,多数团队采用混合模式:基础配额按独占时长锁定,超出部分按调用量扣费,这样财务上既可控,也保留弹性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/674978.html