提供运维服务器有哪些?核心包括物理服务器、云服务器、虚拟专用服务器、托管服务器、GPU服务器、容器与混合云环境,以及围绕它们展开的监控、备份、安全、自动化和应急响应服务。
提供运维服务器有哪些类型?先分清物理、云和托管
服务器运维不是一句“帮你看着机器”,不同形态的服务器,责任边界、操作入口、故障处理方式完全不同,选错了,后面工单会堆成山。
物理服务器与裸金属:硬件也要管
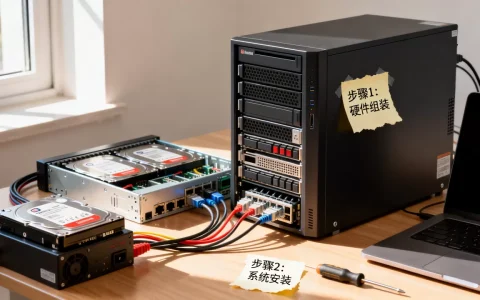
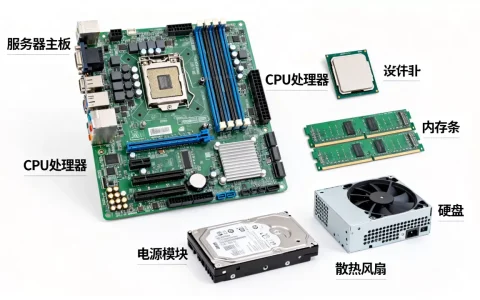
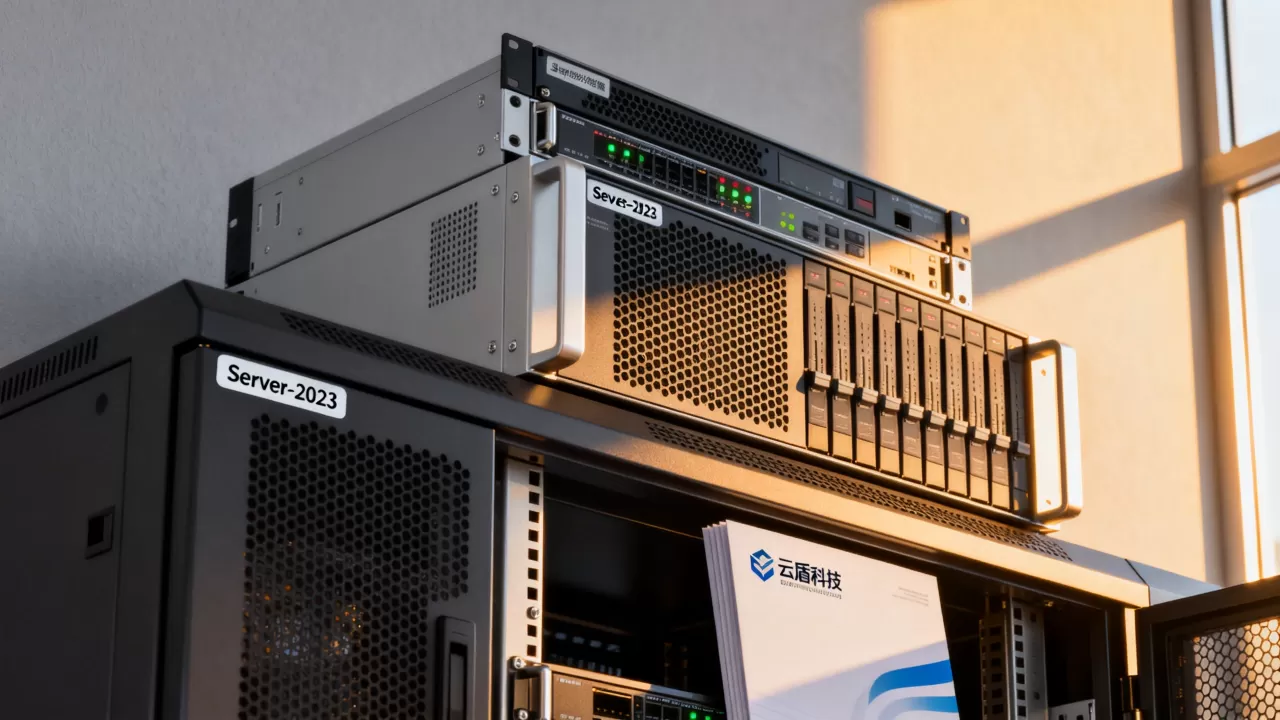
物理服务器通常放在IDC机房或企业自建机房,运维方要盯的不只是系统,还包括硬件告警。
- 通过带外管理查看硬件日志:
ipmitool sel list、ipmitool sdr - 检查磁盘健康:
smartctl -a /dev/sda - 查看RAID状态:
megacli -LDInfo -Lall -aALL或厂商工具 - 关注电源、风扇、网卡、内存ECC、机房温度
- 更换硬盘、内存、电源时,需要备件和现场支持
这类服务器适合数据库、高性能计算、合规要求高的业务,运维重点在硬件巡检、固件升级、RAID管理和机房协调。
云服务器与轻量应用服务器:责任共担
云服务器如常见的ECS、CVM、轻量应用服务器,云厂商负责底层物理资源,用户和服务商负责系统内部。
- 安全组、网络ACL、VPC路由要定期检查
- 云监控、事件中心、日志服务要接入告警
- 快照、镜像、备份策略要配置并演练恢复
- 系统盘、数据盘、带宽、连接数要设置阈值
云服务器运维更偏向策略和配置,比如安全组开放了高危端口,故障不会立刻出现,但风险会一直存在。
虚拟专用服务器、容器与混合云
VPS适合小型站点和测试环境,成本低,但资源隔离和性能上限有限,容器环境则要管Docker、Kubernetes、镜像仓库和编排配置。
- Docker巡检:
docker ps、docker stats、docker logs - Kubernetes巡检:
kubectl get nodes、kubectl top pod、kubectl describe pod - 混合云要统一监控、统一日志、统一权限
- 容器环境要关注镜像漏洞、资源限制、探针和持久化存储
据中国信通院公开资料,混合云和多云管理已成为企业IT架构的重要方向,运维对象变多后,没有统一平台,排查会非常被动。
运维服务器托管多少钱一个月?价格构成与避坑
价格通常由哪些部分组成
“托管多少钱”不能只看机柜费,常见费用包括:
- 机柜或U位租用费
- 带宽费,独享和共享差别很大
- IP地址费
- 电力费,按电流或实际功耗计算
- 硬件维保和备件费
- 高防、WAF、堡垒机等安全费用
- 备份空间和容灾费用
- 运维人力费,7×24和5×8价格不同
- SLA等级,响应和恢复要求越高,成本越高
价格跨度很大,一个小型官网和一套核心交易系统,运维投入不在一个量级。
小企业运维服务器怎么选?按业务场景定
小企业常见误区是只看月费,不看故障损失,更稳的做法是按场景选。
- 官网、小程序后端:轻量云服务器加云监控、快照、CDN即可
- OA、ERP、财务系统:云服务器或托管物理机,数据库做主从,备份要异地
- 视频、下载、直播:大带宽加CDN,源站要做流量清洗
- AI训练和推理:GPU服务器加集群调度,关注显存、散热和驱动版本
- 核心数据库:物理服务器或高规格云主机,重点做RAID、备份、慢查询优化
如果团队没有专职运维,优先选带基础监控、备份、安全加固的托管服务,不要等磁盘满了、证书过期了才找人。
北京服务器运维服务哪家好?先看本地响应能力
北京用户搜“北京服务器运维服务哪家好”,多半关心本地机房、现场速度和合规,判断时看这些:
- 是否有本地机房或合作机房
- 备件库离机房多远
- 工单响应是自动回复还是人工介入
- 是否支持驻场、上门、陪同审计
- 是否熟悉等保、日志留存、数据跨境等要求
- 合同里是否写明响应时间、恢复时间和赔偿
地域不是唯一标准,但本地响应在硬件故障时很关键,硬盘坏了,远程命令再快,也得有人换。
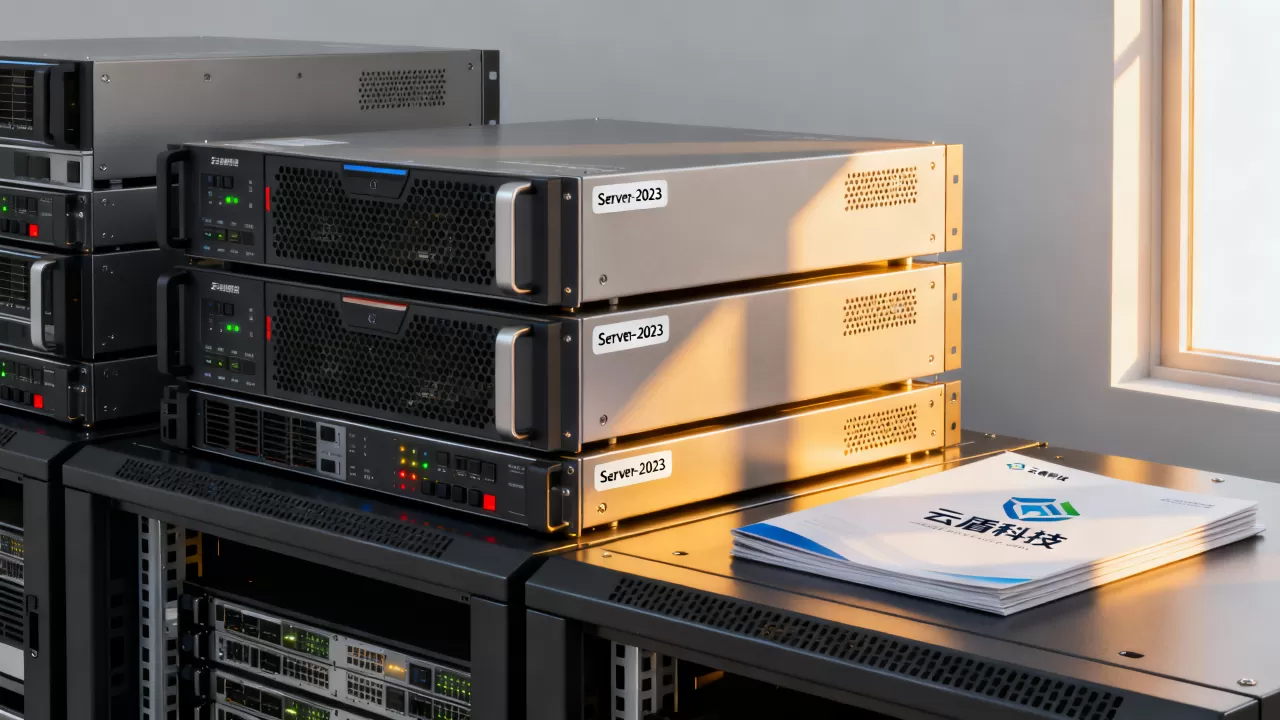
云服务器和物理服务器运维有什么区别?场景对比
| 维度 | 云服务器 | 物理服务器 |
|---|---|---|
| 硬件责任 | 云厂商负责 | 用户或运维方负责 |
|
扩容方式 | 控制台调整,通常较快 | 采购、上架、布线,周期较长 |
| 成本形态 | 按量或包年包月 | 租用、托管、一次性采购 |
| 运维重点 | 安全组、快照、云监控、IAM | RAID、BMC、固件、电源、机房 |
| 适用场景 | 弹性业务、Web、测试 | 数据库、高性能、合规、特殊硬件 |
监控告警差异
云服务器可直接用云监控,适合快速接入,物理服务器更依赖Zabbix、Prometheus加node_exporter、SNMP和IPMI。
- 云上要防“监控盲区”,比如云盘IOPS、连接数、NAT网关
- 物理机要防“硬件静默故障”,比如坏道、内存ECC错误
- 混合环境要统一告警收敛,避免短信风暴
安全与合规差异
云上强调责任共担,安全组、WAF、堡垒机、密钥管理要配好,物理机则要管机房出入、硬件资产、系统补丁和审计日志。
- SSH禁用密码登录,改用密钥
- 配置
fail2ban或类似工具防爆破 - 使用
ufw、firewalld或安全组限制来源 - 定期执行
yum update或apt upgrade - 数据库禁止公网暴露,走内网或跳板机
成本与弹性差异
云服务器弹性好,但长期高负载可能比物理机贵,物理机固定成本高,性能稳定,适合可预测负载,行业共识认为,没有监控和备份的运维等于让业务裸奔。
提供运维服务器有哪些具体服务内容?从监控到应急
日常巡检与监控
一套可执行的巡检路径比口头承诺有用。
- 登录堡垒机,确认操作审计开启
- 执行
df -h看磁盘,free -m看内存,top看负载 - 执行
ss -tunlp看端口,journalctl -u nginx --since "1 hour ago"看日志 - 部署node_exporter、Prometheus、Grafana,或使用Zabbix
- 设置CPU、内存、磁盘、网络、证书到期、进程存活告警
备份恢复与容灾
备份不演练,等于没有备份。
- 数据库:
mysqldump、xtrabackup,或云数据库自动备份 - 文件:
rsync、对象存储、云快照 - 遵循3-2-1思路:多份副本、不同介质、至少一份异地
- 每季度做恢复演练,记录恢复时间
安全加固与补丁
- 关闭无用端口和服务
- 限制 root 远程登录
- 配置日志留存和集中审计
- 对Web应用上WAF,对API做限流
- 对容器镜像做漏洞扫描
自动化与配置管理
- 用Ansible批量下发配置,保证幂等
- 用Terraform管理云资源,减少手工点击
- 用GitLab CI或Jenkins做发布流水线
- 用配置中心管理环境变量和密钥
应急响应与SLA
故障分级、响应时间、恢复时间、复盘报告要写进流程,业内专家指出,运维外包不是一包了之,权限和审计必须握在企业自己手里。
怎么判断运维服务商是否靠谱?实操检查清单
- 是否提供7×24人工响应,还是只给机器人
- 是否有监控大屏、工单系统、变更记录
- 是否定期做备份恢复演练和安全扫描
- 是否明确RTO、RPO、备份保留周期
- 是否支持数据导出、迁移和退出
- 合同是否写明赔偿条款和保密责任
可以要求试运行一个月,观察工单质量、告警准确率和故障处理速度,低价服务往往省掉监控、备份和演练,出事后再补,成本更高。
提供运维服务器常见问题解答
提供运维服务器有哪些常见计费方式?
常见有按台按月、按资源用量、按人力人天、按SLA等级计费,云服务器多按实例和增值服务计费,物理服务器多按机柜、带宽、IP和维保计费,混合模式也常见。
云服务器和物理服务器运维哪个更适合小企业?
多数小企业选云服务器加基础运维托管更轻,业务有高性能数据库、特殊硬件或合规要求时,再考虑物理服务器托管,关键看业务峰值、数据敏感度和团队技术能力。
提供运维服务器有哪些必须写入合同的SLA指标?
可用性、故障响应时间、恢复时间、备份频率、RPO、RTO、赔偿方式、数据归属和退出迁移支持,这些指标直接决定故障时能否追责、能否快速恢复。
提供运维服务器有哪些,答案不是一张设备清单,而是按物理、云、托管、容器和混合云匹配监控、备份、安全、自动化与应急,先看业务场景和SLA,再谈价格,才能让服务器真正稳定支撑业务。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/681280.html