矩阵式服务器并没有一个严格的官方定义,业内通常将采用高密度并行架构、能在统一管理框架下进行大规模横向扩展的服务器形态统称为矩阵式服务器,具体包括FPGA并行计算服务器、GPU集群服务器、高密度多节点服务器以及部分分布式存储一体机。
为什么你需要搞清楚矩阵式服务器的具体形态
搜索“矩阵式服务器有哪些”的朋友,大概率正在做技术选型或者搭建算力平台,行业共识认为,理解矩阵式服务器的分类,核心在于看清计算单元的组织方式和数据交换的拓扑结构,这决定了你的业务能否在处理海量数据时保持低延迟和高吞吐。
按硬件架构形态划分的三大主流类型
矩阵式服务器的本质是将多个计算单元按特定维度排列,协同完成单一任务,目前市面上能买到的成熟产品主要集中在以下三类:
- FPGA阵列服务器:这类服务器通过PCIe交换机将多块FPGA加速卡互联,卡间数据互通延迟能控制在微秒级,适合需要低延迟、高确定性的业务,比如金融行情极速交易、基因测序比对、图像信号预处理,国内互联网大厂的图片识别审核系统,早期大量采用这类方案。
- GPU集群服务器(最接近大众认知的矩阵形态):以NVIDIA HGX系列或AMD Instinct平台为基础,单台可集成8张甚至16张GPU卡,卡间通过NVLink或InfiniBinfiniBand高速互联,构成一个紧密的“计算矩阵”,AI大模型训练的标配环境就是这种服务器,8卡GPU服务器是目前市场上出货量最大的矩阵式算力单元。
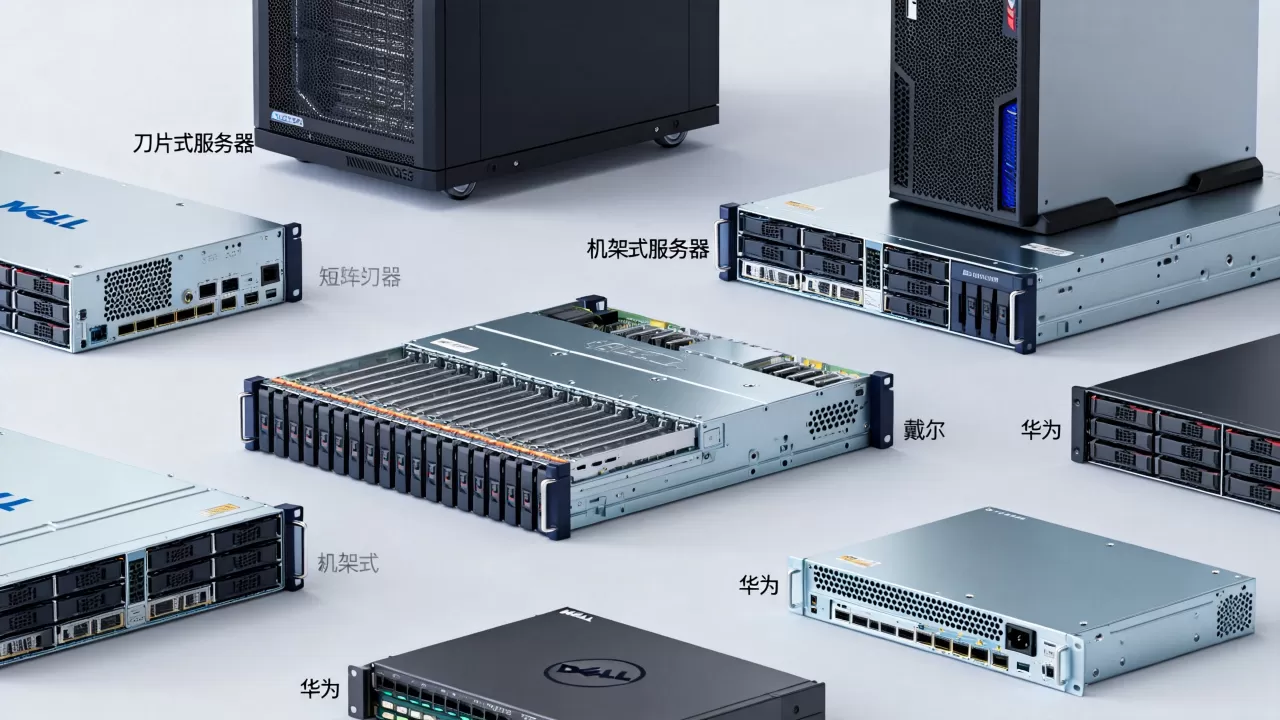
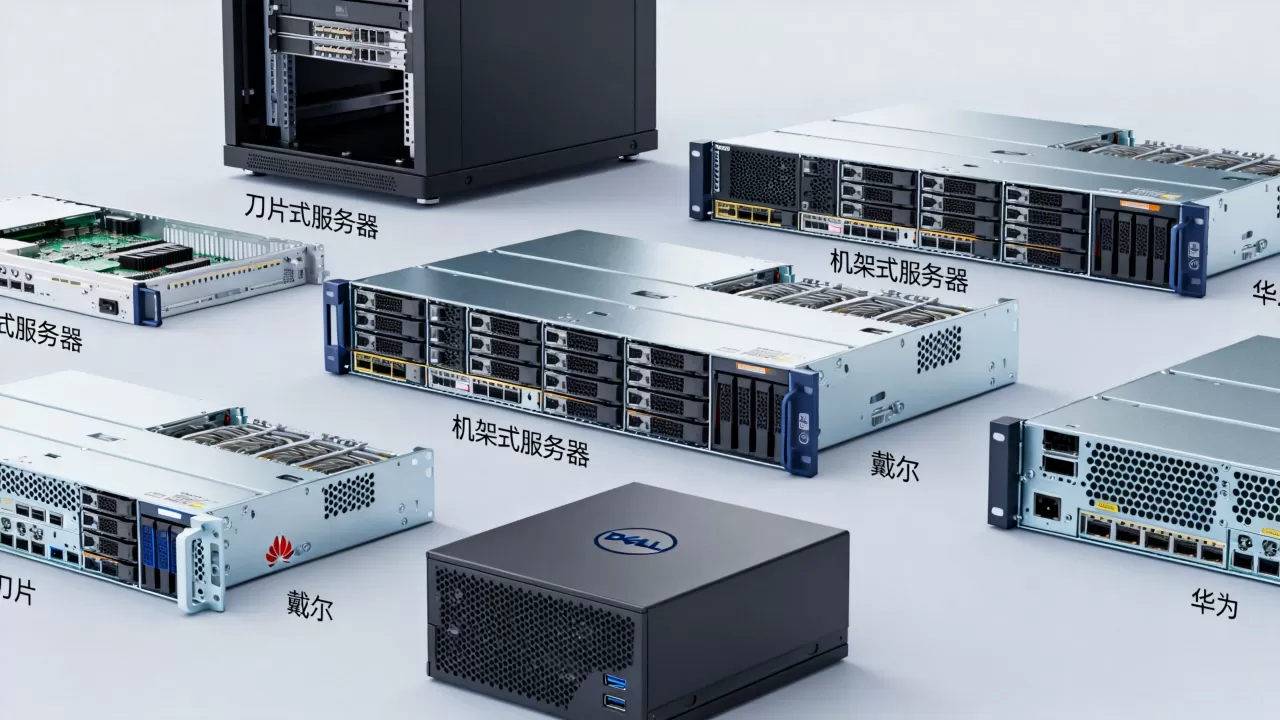
- 高密度多节点服务器(刀片/整机柜):在标准42U机柜内,通过Torus或胖树拓扑挂载几十个独立计算节点,每个节点是独立的服务器主板,但共享机柜的电源、散热和高速交换背板,这种形态适合云计算资源池、HPC高性能计算中心,比如气象模拟、流体力学计算。
按网络拓扑和部署规模划分的应用形态
除了单台设备内部的矩阵,跨服务器的集群同样具备矩阵特征,这类产品形态也常被客户称作“矩阵式服务器解决方案”。
- 超融合基础设施(HCI):将计算、存储、网络虚拟化融合在三台以上的标准x86服务器中,通过软件定义层把多台机器“矩阵化”为一个资源池,中小企业构建私有云时,多数会选择这种易运维的形态。
- 分布式存储一体机:采用横向扩展架构,每台机器既是计算节点也是存储节点,数据打散分布在所有节点的硬盘上,这种矩阵式布局让读写带宽可以随节点数量线性增长,单个文件系统容量可达PB级。
- AI训练集群(Data Center Scale)

:多个8卡GPU服务器通过高速交换机连接,形成更大规模的“GPU矩阵”,比如千卡集群、万卡集群,这属于机房级别的矩阵式服务器系统,国内大型智算中心采用的就是这种形态。
矩阵式服务器和普通服务器的区别
很多朋友分不清矩阵式服务器与传统机架式服务器的区别,这里有一个最简单的观察角度:看数据是“串着走”还是“并着走”。
普通服务器(如单路或双路机架式服务器)内部数据走共享总线,多核CPU竞争内存带宽,扩展多张卡时,卡间通信要绕道CPU或经过低速交换机,延迟高且吞吐容易到达瓶颈。
而矩阵式服务器的设计逻辑则完全不同:
- 高带宽内部互联:以8卡GPU服务器为例,卡间通过NVLink Switch(或OCS光交换)实现全互联,通信带宽是PCIe总线的数倍,这使得数据可以在卡间直接“流转”,无需频繁拷贝回内存。
- 异构计算调度:矩阵式服务器普遍支持CPU+GPU+DPU混合异构架构,CPU负责任务分发,GPU专注于大规模并行计算,DPU则接管网络和存储协议处理,三者各司其职,类似工厂里的流水线矩阵。
- 软件定义管理平面:无论是超融合还是整机柜,所有物理节点都被管理平台抽象成一个“资源矩阵”,运维人员通过一个Web界面即可完成所有节点的固件升级、状态监控和负载迁移。
不同场景下如何选择矩阵式服务器类型
对于正在规划采购的企业,具体的选型路径比理解抽象概念更重要,下面按场景给出具体的需求匹配建议以及市场上主流的报价区间范围。
AI大模型训练与推理(选GPU矩阵服务器)
核心配置关注点:显存容量与卡间互联带宽,训练千亿级参数模型,必须选择支持NVLink全互联的8卡机型,推理场景则相对灵活,可以选购4卡或6卡机型降低成本。
- 实操建议:咨询供应商时,务必询问是否支持液冷散热方案,单机功耗超过10kW的情况下,风冷很难压制散热噪音和功耗,液冷技术已经成为AI服务器的标配选项。
- 价格参考区间:根据公开采购信息,一台主流的8卡H系列GPU服务器(含CPU、内存、本地NVMe盘)价格通常在80万至120万元人民币之间,而采用上一代A系列显卡的服务器,价格会下探至40万元上下,适合预算有限但想快速验证模型的公司。
高频金融交易与数据库加速(选FPGA矩阵)
这个场景极其看重微秒级甚至纳秒级确定性延迟,FPGA矩阵服务器通过硬逻辑并行处理,不会像CPU那样出现因为缓存未命中导致的延迟抖动。
选型要点:
- 确认FPGA型号支持OpenCL或Verilog代码动态重配置。
- 检查PCIe通道数量,推荐选择支持PCIe 5.0 x16通道接口的机型,确保卡间通信不受总线带宽约束。
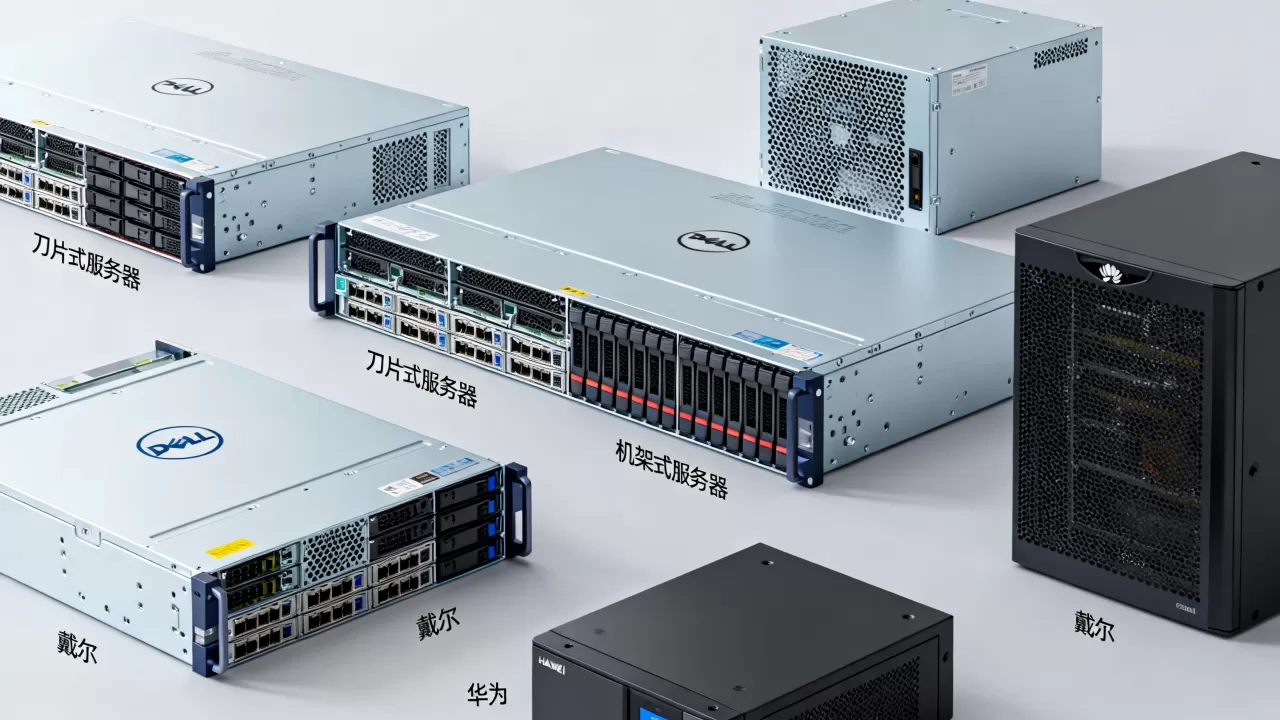
- 多数FPGA服务器采用2U机架式结构,单机可插入4到8张加速卡,相比GPU服务器需要注意供电冗余和扩展槽位物理空间。
企业私有云与桌面虚拟化(选高密度多节点服务器)
这一类是刀片服务器或整机柜服务器的主场,追求的是高计算密度和统一资源调度。
- 例如某品牌的高密度服务器,在2U空间内可放入4个独立计算节点,每个节点支持双路CPU和16条内存插槽。
- 成本优势测算:相比采购4台独立的1U机架服务器,一台2U高密度机器的采购成本节省大概15%至20%,同时机房托管费用降低一半(因为占地面积更小了),功耗也更低。
| 对比维度 | 8卡GPU矩阵服务器 | FPGA矩阵服务器 | 高密度多节点服务器 |
|---|---|---|---|
| 核心优势 | 高并行计算吞吐 | 微秒级确定性低延迟 | 高部署密度与统一管理 |
| 适合业务 | 大模型训练、科学计算 | 高频交易、信号处理 | 虚拟化资源池、HPC |
| 单台节点数 | 1个节点(8卡) | 1个节点(最多8-16卡) | 4个及以上独立节点 |
| 主要成本因素 | GPU卡采购价与功耗 | FPGA开发与授权费用 | 刀箱与背板交换模块 |
| 典型功耗范围 | 大几千瓦至万瓦级 | 1500W至3000W | 单节点约500W至800W |
决定矩阵式服务器价格的核心组件
关于矩阵式服务器价格,业内专家指出,成本的大头通常不是CPU,而是高速计算卡和传输模块,实际采购中这两项往往占总成本的60%到70%。
具体拆解来看:
- GPU计算卡:占据成本的绝对核心,企业需要特别关注HBM显存的规格,这直接决定了处理大数据矩阵运算时的上限速度,显存带宽不足比芯片算力弱更容易造成计算任务卡顿。
- 高速网络模块(如InfiniBiniBand或RoCE网卡):一台8卡GPU服务器通常需要配置8张200G(或更高速率)的网卡来实现跨机箱的Scale-Out通信,这一套网络模块组件的价格大概相当于一台中高端轿车。
- 高速交换背板:刀片服务器机箱内部的核心部件,它负责节点间的高速信号路由,采用无源背板设计的机型,故障率远低于有源背板,但价格更贵,采购时务必询问背板是否支持后续更高代际CPU的平滑升级。
结尾建议与核心结论
搞清楚了矩阵式服务器有哪些类型,做决策就容易多了,如果是预算充足并跑大模型业务,直接选择8卡GPU液冷服务器;如果是低延迟实时处理场景,FPGA矩阵服务器值得深挖;如果是想构建私有云或机房空间有限,高密度多节点服务器的性价比最高。
核心结论是:矩阵式服务器的本质是打破单机性能瓶颈,用高带宽互联把多组计算资源拧成一股绳,你不需要把所有类型都弄明白,只需盯住你业务中数据流动的最大阻碍,对应的服务器形态自然就清晰了。
常见问题解答
Q1:矩阵式服务器和传统的集群服务器是同一个概念吗?
不是完全等同,传统集群是多个独立服务器通过网络软件组合,节点间通过TCP/IP通信,耦合度较高,延迟明显,而矩阵式服务器更强调硬件层面的紧耦合,比如GPU卡间通过NVLink直连、刀片节点通过高速背板交换,这种硬连接方式在带宽和能耗效率上远超普通以太网集群。
Q2:采购矩阵式服务器时,如何避免被参数宣传误导?
建议在配置单中核对两个关键参数:第一是“卡间互联总带宽”,理论值越高越好,注意区分是“总带宽”还是“单卡带宽”(一般后者数字会更好看但实际会缩水);第二是“最大功耗”,务必询问在满负荷运行时的实际整机功耗,避免出现机房供电容量不够的尴尬情况。
Q3:中小企业第一次上手矩阵式服务器,资金有限,推荐用什么方案?
更稳妥的选择是购买门槛偏低的2U4节点高密度服务器,先搭建网络存储和虚拟化平台,后续若要开展AI业务,再单独外挂一台4卡GPU服务器专用作推理任务,这种初始投入金额可控,部署周期短的方案,可扩展性也强,尽量选择支持标准PCIe插槽的机型,预留加装GPU卡的硬件物理空间即可。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/688772.html