服务器基本运维的核心,是让系统、网络、存储、安全和数据备份始终处于可控状态,覆盖日常巡检、监控告警、补丁更新、账号权限、日志审计、备份恢复和故障处理。
你可以把服务器当成一台长期不关机的办公电脑,它更怕磁盘写满、证书过期、权限乱放、备份没演练,服务器基本运维有哪些?答案不是一张工具清单,而是一套固定动作:知道谁在用、跑着什么服务、出问题先看哪里、多久备份一次、变更后怎么回滚。
服务器日常运维工作内容有哪些
服务器日常运维工作内容有哪些,拆开看并不神秘,每天要做的,多数是重复但关键的小事。
硬件与机房环境巡检
物理服务器要看电源、风扇、硬盘指示灯、网卡状态和机房温湿度,云服务器虽然看不到硬件,但要看宿主机告警、云盘性能、快照状态和可用区事件,业内专家指出,硬件故障里相当一部分会先表现为性能抖动,而不是直接宕机。
- 物理机:
ipmitool sdr查看传感器,smartctl -a /dev/sda查看硬盘健康。 - 云主机:关注云厂商的实例健康状态、云盘IOPS和带宽水位。
- 机房环境:温度、湿度、UPS、空调、消防告警都要接入监控。
操作系统与补丁管理
系统补丁不能等到被扫描出漏洞才打,先测试,再灰度,最后全量,CentOS/Rocky可用 yum update 或 dnf update,Ubuntu/Debian用 apt update && apt upgrade,内核更新后要安排重启窗口。
- 检查版本:
cat /etc/os-release、uname -r。 - 查看可更新包:
yum check-update或apt list --upgradable。 - 重启前确认:
systemctl list-units --failed、ss -tunlp。
监控与告警
监控不是只看CPU,内存、磁盘、inode、网络丢包、TCP连接数、服务端口、证书到期、备份结果都要看,常用组合是Prometheus加Grafana,或者Zabbix加告警机器人。
- 负载:
uptime、top、htop。 - 内存:
free -h,重点看available和swap使用。 - 磁盘:
df -h、df -i,inode满也会导致服务写不了文件。 - IO:
iostat -x 1,看%util和await。 - 网络:
ss -tunlp、ping、traceroute。 - 服务:
systemctl status nginx、journalctl -u nginx --since "1 hour ago"。
账号权限与安全基线
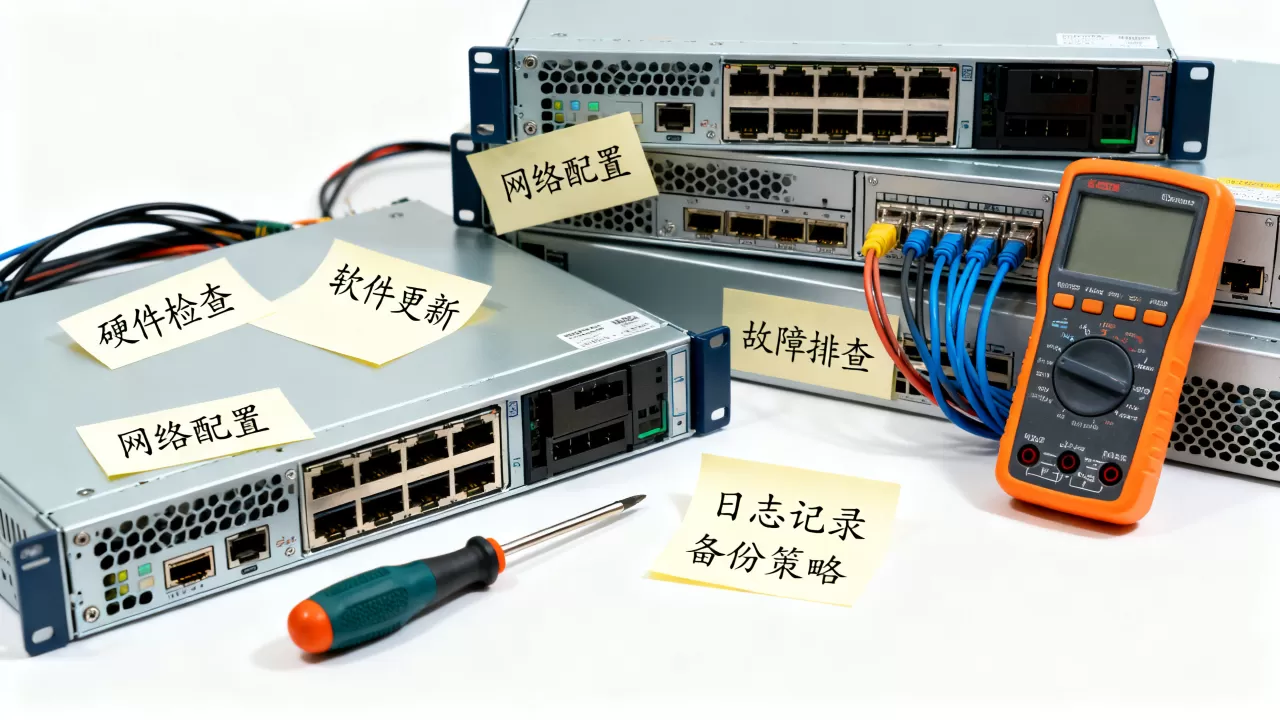
别让所有人用root直接登录,用SSH密钥,禁用密码登录,按最小权限分配sudo,定期清理离职账号、测试账号和长期不用的API Key。
- 修改SSH配置:
/etc/ssh/sshd_config中设置PermitRootLogin no、PasswordAuthentication no。 - 授权:
visudo编辑sudo权限,避免直接改/etc/sudoers。 - 密钥权限:
chmod 600 ~/.ssh/authorized_keys。 - 登录审计:
last、lastb、grep "Failed password" /var/log/secure(Ubuntu看/var/log/auth.log)。 - 防火墙:
firewall-cmd --list-all或ufw status。
备份与恢复演练
备份不是把文件拷走就结束,要确认备份成功、能恢复、恢复时间可接受,数据库用 mysqldump、xtrabackup 或云数据库快照;文件用 rsync、tar 或对象存储同步,行业共识认为,没有经过恢复演练的备份,不能算真正可用的备份。
- 文件备份:
rsync -avz /data/ backup@192.0.2.10:/backup/data/。 - 数据库备份:
mysqldump -uroot -p --single-transaction dbname > dbname.sql。 - 快照策略:每天一次,保留最近7到30天,关键系统做异地副本。
- 恢复演练:每季度至少一次,记录恢复耗时和缺失项。
日志与变更记录
日志要轮转,变更要留痕,否则一出故障,只能靠猜。logrotate 负责切割,ELK或Loki负责集中查询,Git或工单系统负责记录变更。
- 检查轮转:
logrotate -d /etc/logrotate.conf。 - 查看失败服务:
systemctl --failed。 - 记录变更:改了什么、为什么改、谁批准、怎么回滚。
中小企业服务器运维和大型企业有什么区别
中小企业服务器运维和大型企业有什么区别,核心不在技术名词,而在团队规模、流程深度和成本结构,下面这张表更直观。
| 维度 | 中小企业 | 大型企业 |
|---|---|---|
| 团队 | 1到2人兼岗,或部分外包 | 专职SRE、运维、安全、DBA |
| 工具 | 云监控、Zabbix、脚本、工单 | Prometheus、Grafana、ELK、CMDB、Ansible |
| 流程 | 口头沟通加简单记录 | 变更审批、灰度发布、复盘机制 |
| 备份 | 快照加手动导出 | 多副本、异地容灾、定期演练
|
| 成本 | 更看重人力效率 | 更看重平台稳定与合规 |
中小企业常见场景是:一台云主机跑官网、测试环境和数据库,运维既要看监控,又要改Nginx,还要管域名证书,大型企业则把职责拆开,网络、系统、数据库、安全各有人负责,靠平台和流程降低人为风险。
云服务器基本运维怎么做
云服务器基本运维怎么做,和物理机有交集,但多了几个云上重点。
购买后的第一小时
- 设置安全组,只放行必要端口,比如22、80、443。
- 使用SSH密钥登录,禁用密码和root远程。
- 更新系统:
apt update && apt upgrade或yum update。 - 安装监控Agent,配置磁盘、内存、进程告警。
- 开启自动快照,设置保留策略。
- 绑定域名,配置HTTPS证书和自动续期。
日常云上巡检
- 看云监控:CPU、内存、云盘IOPS、公网带宽。
- 看系统内:
df -h、free -h、ss -tunlp。 - 看备份:快照是否成功,数据库导出是否完整。
- 看账单:闲置云盘、未绑定公网IP、超标带宽都会增加成本。
- 看证书:
openssl x509 -in cert.pem -noout -dates。
容器与Kubernetes场景
如果跑Docker,至少掌握 docker ps、docker logs、docker stats,如果跑Kubernetes,要看 kubectl get nodes、kubectl get pods -A、kubectl describe pod,节点NotReady、镜像拉取失败、存储卷挂载失败,都是高频问题。
服务器运维外包多少钱一个月,北京团队怎么选
服务器运维外包多少钱一个月,没有统一报价,基础远程巡检通常低于7×24小时驻场;按台计费、按SLA计费、按工单计费都常见,北京服务器运维外包团队怎么选,要看本地响应能力、机房资源、等保经验和过往案例,北京人力与机房成本较高,同等服务等级往往高于二三线城市。
选择外包时,先问清楚几件事:
- 响应时间:5分钟、15分钟还是1小时?
- 服务范围:只监控,还是包含补丁、备份、故障处理?
- 是否驻场:远程还是现场,节假日怎么算?
- 交接方式:文档、账号、脚本、监控权限是否完整移交?
- 退出机制:合同结束后如何平滑迁移?
价格低不等于划算,一次严重故障造成的业务损失,往往超过全年基础运维费用,据工信部公开信息,近年来企业上云和混合云部署持续增长,运维对象从物理机扩展到云主机、容器和中间件,外包团队能否覆盖这些场景,比单纯比价更重要。
服务器基本运维的实操清单
把下面动作做成固定节奏,基本不会太乱。
- 每天:看告警、看磁盘、看服务、看备份结果。
- 每周:检查补丁、账号、日志、证书到期时间。
- 每月:做恢复演练、清理无用账号、复核安全组。
- 每季度:更新应急预案、检查容灾链路、复盘故障。
- 每次变更:记录原因、步骤、回滚方案和验证结果。
- 每年:做一次全面架构和安全评审。
具体命令可以形成脚本:
- 巡检脚本:
uptime、free -h、df -h、df -i、ss -tunlp。 - 服务检查:
systemctl --failed、journalctl -p err -b。 - 安全扫描:
lastb、grep "Failed password" /var/log/secure。 - 备份校验:
ls -lh /backup/latest、tar -tzf backup.tar.gz。 - 自动化:
ansible all -m ping、ansible-playbook site.yml。
服务器基本运维有哪些高频问题
服务器基本运维每天必须做哪些检查?
先看告警,再看负载、内存、磁盘、inode、服务端口、备份结果和证书到期,命令上至少跑一遍 uptime、free -h、df -h、df -i、ss -tunlp、systemctl --failed,如果数据库在外,还要看连接数、慢查询和主从延迟。
服务器基本运维需要掌握哪些脚本或工具?
Shell是基本功,Python适合写复杂巡检,配置管理用Ansible,监控用Prometheus加Grafana或Zabbix,日志用ELK或Loki,容器用Docker和Kubernetes,据中国信通院公开资料,云原生和自动化运维工具的使用范围在持续扩大,掌握一种配置管理工具会明显提升效率。
服务器基本运维和网络安全运维是一回事吗?
不是,基础运维管可用性、性能、变更、备份和故障恢复;安全运维管漏洞、入侵检测、合规和应急响应,两者有交集,比如补丁、权限、日志审计和网络隔离,基础运维和安全运维共享补丁、账号、日志三条主线,但目标、工具和考核指标不同。
把巡检、监控、备份、权限和变更记录做成固定动作,服务器基本运维就从靠人扛变成靠流程跑,真正稳定的服务器,不是从不出故障,而是故障来了能快速定位、恢复,并留下可追溯的记录。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/689220.html