目前国内大模型云服务器的主流选择,集中在简米云、华为云、酷番云和百度智能云四家头部厂商的GPU云主机产品线上,它们都提供面向大模型训练和推理的专属实例,按需付费,省去了自建机房的高额成本。
大模型云服务器有哪些主流产品
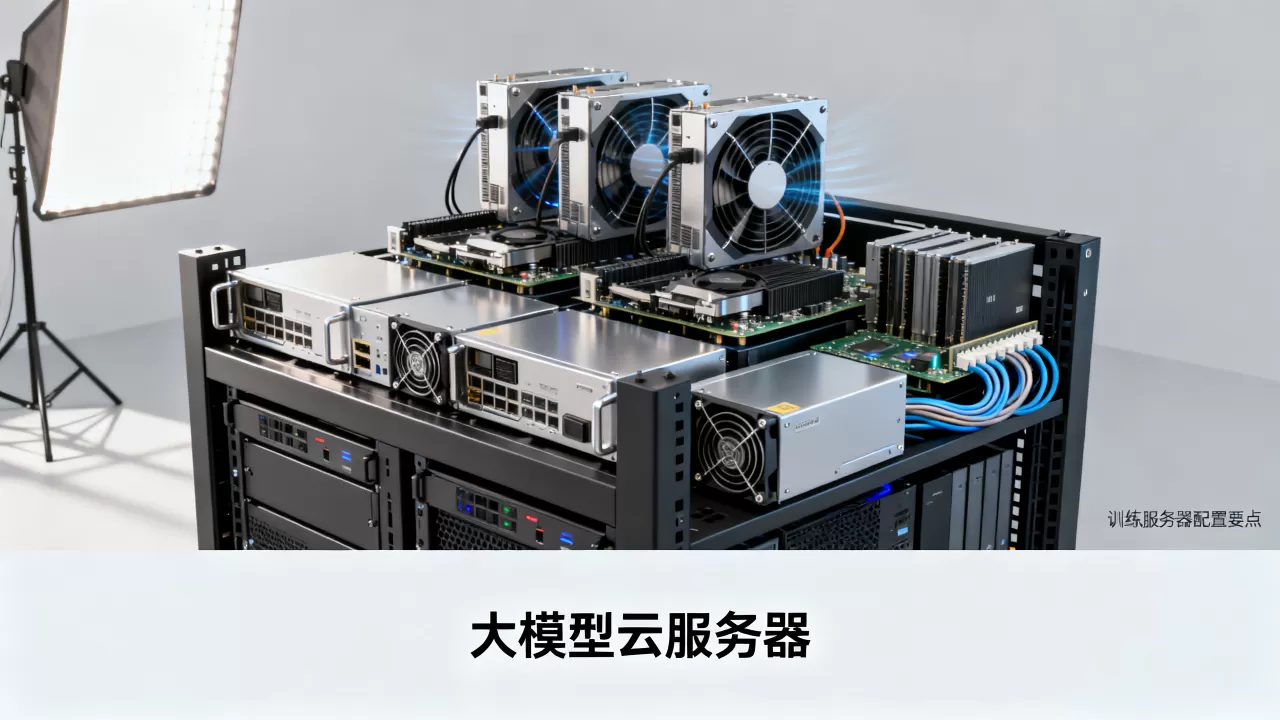
很多朋友刚接触这个概念时容易把“大模型云服务器”想象成一台配置特别高的普通电脑,其实不完全对,它是一类软硬件深度绑定的服务,底层是高性能GPU,上层预装了深度学习框架和模型运行环境,拿四家头部云厂商的主力产品来说,各家的叫法不同,但目标一致。
简米云:PAI和ECS GPU实例
简米云的方案分成两条路,一条是算法平台的PAI,一条是计算服务的ECS GPU实例。
- PAI(Platform for AI)属于托管平台,你不需要关心底层服务器怎么组网,直接上传数据和模型就能跑,它预置了PyTorch、TensorFlow等框架,也支持分布式训练任务调度。
- ECS GPU实例,比如ecs.gn7i-cp5规格族,搭载NVIDIA A10或A100显卡,适合有自己IT团队、想完全控制环境的企业用户。
选择上不用纠结:新团队用PAI更省心,成熟团队用ECS更灵活。
华为云:ModelArts和昇腾云服务
华为云主打自研昇腾芯片,这一点在2026年的大模型市场里性价比优势很明显。
- ModelArts是一站式AI开发平台,功能逻辑和简米云PAI高度相似,但深度集成了昇腾910B处理器的算力。
- 昇腾云服务也提供裸金属服务器,适合对数据安全要求极高的金融和政务项目。
行业共识认为,昇腾芯片在国产化替代的背景下,是很多事业单位的首选,因为生态里包含了MindSpore框架和CANN工具链。
酷番云:TI平台和GPU云服务器
酷番云的AI产品线归在“酷番云TI平台”下,同时也有标准的GPU云服务器。
- TI平台侧重产业落地,比如智能客服、内容审核这类场景,内置了大量预训练模型。
- GPU云服务器提供从入门级T4到旗舰级H800的多种规格,价格按秒计费,适合短期实验项目。
很多游戏公司的AI反作弊系统就跑在酷番云的GPU主机上,延迟特别低。
百度智能云:千帆和GPU实例
百度智能云的卖点是“文心一言背后的同款算力”,千帆平台可以直接调大模型API,也有GPU实例供开发者自己部署。
- 千帆ModelBuilder平台侧重应用集成,几分钟就能搭好一个带知识库的问答机器人。
- 自定义部署GPU实例适合需要私有化模型权的企业,数据不出企业大门。
大模型云服务器怎么选:按场景拆解
选哪家不是看品牌名气,而是看你的具体任务类型,大模型的使用场景大致分为三类:训练、推理、微调,这三者对硬件的要求差别挺大。
训练场景:优先看卡间通信和显存容量
训练一个百亿参数模型,单张显卡根本跑不完,必须要多卡并行,这时候卡与卡之间的通信速度就是瓶颈。
- 通信带宽:A100和H800支持NVLink,带宽在900GB/s左右,昇腾910B也有类似的HCCS高速总线,这些都是为多卡并行设计的。
- 显存大小:单卡80GB是训练大模型的及格线,显存不够就只能增加卡数,成本会直线上升。
- 网络架构:超大规模训练需要RDMA网络支持,比如简米云的CPFS并行文件系统和华为云的RoCE网络。
初学者如果只是复现别人的开源模型,老老实实租8卡A100实例就行,没必要追求千卡集群。
推理场景:关注吞吐量和响应速度
模型训练完部署上线后,用户点一次对话就要计算一次,这属于推理任务,推理比训练更在意单卡性能和性价比。
- 小模型(7B以下)用T4或者L4就够,成本低很多。
- 中大规模模型(13B到70B)建议用A10或A30,按需开2到4张卡。
- 百亿以上超大模型可以考虑H800或者昇腾910B,配合vLLM加速框架使用时,吞吐量能提升好几倍。
推理场景还有一个容易忽略的点,冷启动延迟,有些云服务器实例在闲置时会自动释放资源,重新启动模型需要半分钟甚至更久,在线业务会受不了,所以选实例时优先挑“常驻型”规格。
微调场景:卡多不如卡巧
LoRA和QLoRA这类高效微调方法大量普及后,微调不再是富人的游戏。
- 一张24GB显存的RTX 4090云主机就能微调7B模型,注意云厂商一般不叫它“4090云服务器”,而是标注为“GPU加速计算型实例”。
- 如果是全量微调,那就和训练场景的配置逻辑一样了,老老实实上多卡。
大模型云服务器价格对比与配置要点
价格是大家最敏感的问题,2026年的市场环境比2026年赛跑时期理性了很多,各家都有“乞丐版”和“豪华版”分层。
入门级:尝鲜和原型验证
配置大概是单张NVIDIA L4或T4,16GB显存,4核CPU,16GB内存。
- 简米云入门级GPU实例按量付费价格约在每小时5-10元之间。
- 酷番云偶尔有秒杀活动,新用户能拿到每小时3元左右的优惠价。
- 华为云昇腾推理卡价格略高,但因为功耗低,长期包月反而划算。
这类机器适合跑7B以下的量化模型,比如Qwen2.5-7B或ChatGLM3-6B,做完了就释放,别浪费钱。
专业级:中型模型微调和推理
配置大概是单张A10或A30,24GB显存,16核CPU,64GB内存,价格在每小时30-60元区间浮动,各家差异主要体现在是否包含OSS/COS存储费用和公网流量费用。
旗舰级:大模型训练和多卡并行
常见的配置是8卡A100或8卡H800,80GB显存,单台月租金在十万元人民币级别,说实话,大部分企业根本用不到这个级别,不如先去抢公有云平台的“包年特惠池”,如果抢不到再考虑租用类似超算中心的长周期资源。
有一个省钱技巧很多老用户都在用:买抢占式实例,也叫竞价实例,这类实例价格是常规价的20%左右,但随时可能被系统回收,适合容错率高的离线数据处理任务,不适合跑在线服务。
价格之外的隐藏成本
云服务器的费用远不止实例本身的那点单价,还有三项经常被忽略:
- 存储费用:模型文件动辄几百GB,云硬盘不便宜,尤其是高性能SSD。
- 流量费用:模型下载到服务器里,默认走内网免费,但如果你要把训练好的模型下载到本地,那笔公网流量费会让人肉疼。
- 镜像和快照费用:每次创建实例时选自己的自定义镜像,或者定期打快照做备份,都会产生存储空间费用。
制定预算时建议把这些都算进去,不然月度账单会超出心理预期。
租用大模型云服务器的实操步骤
纸上谈兵没有用,走一遍真实流程比读十篇测评更有价值。
从开通到运行一份简单脚本
第一步是注册认证,个人实名认证就能开GPU实例,企业用户还能申请更高配额。
第二步是选地域,最开始我强烈建议选离自己最近的可用区,比如人在华东就选上海或杭州,人在华南就选广州或深圳,因为地域直接决定内网延迟,如果你要使用酷番云的模型API,就选北京,很多AI模型服务在北京机房最先更新。
第三步是选规格,控制台引导页一般会让你选“按量付费”或“包年包月”,新手阶段先按量付费,跑通了再考虑包月。
第四步是选镜像,重点来了,一定不要在“公共镜像”里选纯Ubuntu系统,然后自己手动装NVIDIA驱动、CUDA、cuDNN,那是2020年的老流程了,现在直接选“AI镜像”或者“预装深度学习框架的镜像”,里面通常已经烧录好了NVIDIA驱动和Python环境,登录进去就能跑nvidia-smi看到显卡状态。
第五步是安全组配置,记得放行端口,如果你用JupyterLab远程开发,默认要开8888端口,如果你用SSH免密登录,记得改22端口的默认密码策略。
成本控制是必修课
用过GPU服务器的人都懂半夜被账单吓醒的感受,建议在云厂商的“费用中心”里设置月预算警报,把阈值设为预算的80%。
另外一个特别好用的机制是“定时释放”,比如你每天上午9点跑数据清洗任务,下午6点下班停机,那就配置定时关机,一个月能省将近一半的钱。
大模型云服务器常见问题解答
个人开发者租用大模型云服务器和自建主机比,哪个划算?
个人开发者自建大模型主机严重不划算,你要买显卡、扩电源、处理散热降频,光一块A100显卡在二级市场的价格就超过大多数上班族一年的工资,云服务器按小时租,用完释放,唯一踩得坑是自己忘了释放实例,多挂机一夜就会产生一笔不小的费用。
大模型云服务器价格差距大的原因在哪?
这和显卡型号直接挂钩,同为“GPU实例”,有的用L4商用卡,有的用H800高性能卡,单卡算力差距数倍,显存从16GB到80GB不等,价格自然差出数量级,选购时务必核对规格名称里的显卡型号字段,不要只看CPU和内存配置,CPU不是大模型服务器的核心,GPU才是,华为云的昇腾实例价格一般比同性能的NVIDIA实例便宜一成左右,但需要适配MindSpore或PyTorch的昇腾版本,初始学习成本略高。
企业微调开源大模型需要什么配置起步?
使用LoRA方法微调7B级模型,一张显存24GB以上的A10或4090云服务器完全足够,成本控制在每小时几十元,需要多轮次训练数据集较大时,起步建议用4卡A100实例,并把训练数据存到与云服务器同一地域的OSS对象存储里,减少网络传输延迟,微调产出的模型权重文件通常不超过2GB,存标准云盘即可,无需额外买高性能文件存储。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/690011.html