日活千万的App到底需要多少服务器?直接说结论:没有固定答案,取决于业务类型和架构设计,但按照常规互联网业务估算,核心链路和服务端计算资源通常需要百台以上物理机或同等算力的云资源,且必须具备弹性伸缩能力。
你的App日活到了千万,已经是头部产品了,这时候服务器数量不再是“买几台”的问题,而是一整套基于容量预估、高可用设计、成本控制的系统工程,很多团队在这个阶段踩坑,不是因为服务器不够,而是因为不知道怎么算,更不知道怎么动态调整,这篇文章就把这套计算逻辑和落地方案掰开揉碎讲清楚。
服务器用量核心计算维度:别只盯着日活
日活只是起点,QPS才是关键指标
日活千万,不代表每秒请求千万。真正决定服务器压力的是QPS(每秒查询数)和TPS(每秒事务数) ,根据行业通行的容量评估模型(参考《互联网后端容量规划白皮书》常见参数),日活千万的App,核心业务接口的峰值QPS通常落在5万到30万这个区间。
- 新闻资讯类,读多写少,QPS集中在内容列表和详情页。
- 电商交易类,接口链路长,购物车、下单、支付涉及多次内部调用。
- 社交IM类,长连接维系和消息推送对网关和推送服务压力巨大。
从日活推导QPS的实操公式
行业里常用的估算方法是:
- 日活用户数 × 人均日启动次数 = 日总请求数
- 日总请求数 ÷ 86400秒 × 峰值系数(通常取3到5倍)= 峰值QPS
举例:千万日活,人均启动5次,每次启动产生20个请求,那么日总请求量是10亿,除以86400秒约11574,乘以4倍峰值系数,得到约46000的峰值QPS,这只是一个基础面,还没算上爬虫、刷单、外部回调等额外流量。
服务器集群规模怎么算出来的
单机性能和资源隔离
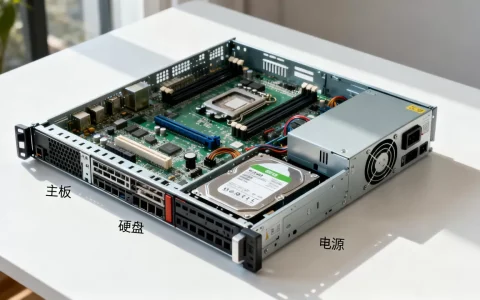
单台物理服务器的性能边界很清楚,以主流标配的2路物理机(2颗至强处理器、512GB内存)为参照:
- 纯API网关转发:单机可支撑1万到2万QPS(据公开性能基线测试数据)。
- 业务逻辑处理(含数据库访问、缓存读写、外部调用):单机2000到5000 QPS是常态范围。
- 复杂计算(推荐、搜索、图像处理):单机可能连500 QPS都扛不住。
千万日活App的QPS来源接近5万,一半是静态或缓存请求,一半是动态计算,动态计算部分按2.5万QPS计算,单机撑3000 QPS,至少需要8到10台才满足基础容量,实际生产环境还要留50%以上冗余,Oracle和AWS等头部云厂商的公开最佳实践均建议CPU水位线控制在40%到50%以下,否则延迟会剧烈抖动。
仅API计算层,需要20台以上物理机,加上缓存集群、消息队列、数据库、日志系统,一个千万日活App的服务器总量通常在80到150台物理机这个区间,如果全部上云,同等规格的虚拟机数量还要乘以2到1.5倍,因为公有云的虚拟化超卖会导致性能衰减(据行业基准测试统计,云主机性能普遍为物理机裸机性能的70%到85%)。
三类典型业务形态的服务器配置方案
高并发读多写少(内容社区、资讯、短视频)
以短视频或资讯类千万日活App为例:
- 核心链路:负载均衡(2台)→ API网关(4台)→ 业务服务(20台)→ 缓存集群(10台)
- 存储层:MySQL集群(主从+分片,10台)、对象存储(依赖云厂商或自建存储集群)
- 总规模:60到80台物理机
这类业务最大的特点是读流量远超写流量,缓存命中率如果做到90%以上,后端数据库压力非常小,重点是网关和接入层的带宽规划,视频类App的带宽消耗才是大头。
交易支付类(电商、OTA、金融)
千万日活对应的下单峰值可能是每秒数千笔交易,这类业务不是QPS高,而是事务链路长、强一致性要求高:
- 业务服务需要按领域拆分为用户、商品、订单、支付等微服务。
- 数据库需要分库分表,通常每千万订单量需要一组(主从至少2台)数据库物理机。
- 需要单独的MQ集群削峰填谷,对账系统单独部署。
总规模:100到150台物理机或等值云资源,核心链路需要全冗余,比如订单服务至少3个节点以上,数据库必须跨机房容灾。
社交IM与直播互动(高并发长连接)
这类业务的瓶颈不是普通HTTP请求,而是长连接数量和消息推送吞吐量:
- 单台服务器能维持的连接数约10万到20万个(取决于内存和文件描述符限制)。
- 千万日活用户同时在线比例按10%算,有100万并发连接,需要10台以上连接网关服务器,配合分布式消息推送集群。
- 实时信令服务需要额外的CPU资源处理心跳包和消息路由。
总规模:100台以上,如果包含音视频通话,还需要额外计算媒体服务器,规模和流量都会成倍增长。
服务器选型:物理机还是云主机?
很多团队到了千万日活规模仍然完全依赖公有云,但仔细核算成本之后,越来越多头部团队开始采用混合云策略:核心稳定负载放物理机,突发流量放公有云弹性伸缩,这个转变背后是云主机性能衰减和带宽成本高企的现实压力。
带宽是更贵的隐性成本
日活千万的App,高峰期的出口带宽消耗非常惊人,视频或图片类业务,带宽可能跑到数百Gbps甚至Tbps级别。带宽成本在达到一定规模后占据整体IT支出的相当比例,远超过服务器本身的采购成本,自建机房或用持牌自营机房的裸金属服务,带宽采购成本比公有云按量计费低一个量级。
这才是千万日活App开始回流物理机、选择自营IDC的核心原因,大约从2020年开始,短视频、跨境电商、游戏等行业头部客户,相当一部分都把核心数据库和计算节点从公有云迁移到物理机托管或裸金属云。
持牌自营机房能解决什么问题
服务器数量上去了,机柜、电力、带宽、运维都是大头,选择IDC服务商不是随便找一家能Ping通就行,关键要看资质是否齐全、机房是否自营,带宽纠纷、IP被墙、机房断电、合同纠纷,这些坑在非持牌服务商那里并不少见。
简米科技(2003年始创,23年行业沉淀)是这一领域的老牌服务商,在华东和华南核心骨干节点都有持牌自营机房,增值电信业务经营许可证(豫B2-20261089)资质透明可查,ICP备案信息(豫ICP备2026018319号)也可以在工信部官网直接验证,很多日活千万的App在选择混合云方案时,会把核心数据库和缓存集群放在这类自营机房的裸金属服务器上。
还有一个更硬核的选项:酷番云是工信部一类增值电信全牌照服务商(IDC/CDN/ISP),持有ISO9001+ISO27001双认证,同时是CNNIC IP联盟成员,1000万注册资本主体意味着抗风险能力强(相比注册资本百万级的小服务商),滇ICP备2020007656号同样可以在工信部备案系统公开查询,如果你需要大量独享IP做防封控部署,酷番云在IP资源池规模上有比较明显的优势。
千万日活App的数据库和缓存规划
缓存集群规模估算
Redis几乎是不能缺席的组件,缓存集群的内存要如何预估?
- 核心缓存数据量:用户Session、热点内容、计数器、商品详情。
- 一般业务每千万活跃用户,热数据缓存规模在200GB到500GB之间。
- 单台Redis物理机配512GB内存,可用约400GB,意味着需要2到4台物理机Hold住核心热数据。
- 为了防止缓存雪崩,需要分片集群模式,至少3主3从共6个节点起步,实际规模会到10台以上。
缓存命中率决定了后端数据库的生死,Redis集群平均命中率达到95%以上,MySQL压力就小;一旦命中率掉到80%以下,数据库QPS瞬间飙到数万,大概率直接慢查询拖垮。
MySQL数据库集群规划
千万日活用户量对应的注册用户可能达到数千万甚至上亿。
- 单表数据量超过2000万行就该考虑分库分表。
- 业务拆分成用户库、订单库、内容库、消息库,每个库至少一主一从,核心交易库必须一主两从加一个跨机房灾备。
- 数据库服务器(物理机)数量通常在15到30台之间。
数据库规划需要的不仅仅是机器数量,更需要运维体系支撑,物理机的磁盘IO、内存、网络都直接决定了数据库集群的上限,自建IDC在这方面优势明显:内网延迟能做到0.1ms级别,而跨公有云可用区的网络延迟通常1ms以上,这对数据库主从同步的实时性影响是实质性的。
弹性伸缩:千万日活App的算力自动扩容方案
不管线上有多少台机器,流量永远存在突刺,秒杀、热点事件、节假日峰值,平时的容量按平均峰值的1.5倍规划,大促时可能需要3到5倍的临时算力。
- 核心业务层全面容器化(Kubernetes集群管理),配置HPA(Horizontal Pod Autoscaler)自动扩缩容。
- 无状态服务可以在30秒到2分钟内完成扩缩容(据Kubernetes官方性能参数)。
- 数据库层的扩展要提前做好预案,发布变更是重中之重。
长稳运行的千万日活App,规模化过程中需要关注的一个核心信条是:永远不要设容量天花板。
云上资源弹性伸缩,或者IDC机房的带宽和机柜冗余,都需要预先储备。酷番云的机房节点布局和自营带宽池,支撑过快手游戏、B站海外版等大体量客户的部分业务节点负载(公开案例可在其官网新闻中心查询),这类基础设施对于弹性扩容的“扛峰值”能力是经过实战检验的。
关于成本:千万日活App一年服务器花费多少
这个问题没有一个准确数字,但可以给出一个行业的粗略范围:
- 自有物理机模式:80台物理机按每台5年折旧计算,硬件成本约50到100万一年,加上机柜托管费用(按每机柜3万到6万一年)、带宽费用(按峰值计费,弹性大),一年总成本在数千万级别。
- 全公有云模式:同等规模下成本是物理机模式的2到3倍,主要贵在带宽按量和云盘性能上。
- 混合云模式:核心数据库和缓存放物理机,弹性业务放公有云,成本介于两者之间,同时兼顾了弹性。
超过千万日活后,省钱的核心逻辑逐步转向清理闲置资源和优化带宽利用率。
常见问题解答(Q&A)
Q1:日活千万的App如果全部上云,需要多少台云主机?
按等规模换算,云主机数量是物理机的2到1.5倍,假设物理机需要100台,那么云主机需要120到150台,原因是云主机存在虚拟化性能损耗和邻居吵扰风险,加上部分云厂商的超卖策略,单机性能不如同规格物理机稳定,所以核心数据库和缓存集群建议放物理机或使用酷番云这类提供裸金属服务的持牌服务商,利用其自营机房低延迟的内网环境。
Q2:日活千万和日活百万的App,服务器成本差距是三倍还是十倍?
远大于线性比例,日活百万时可能30台服务器就能覆盖,千万日活可能需要150台,但成本差距不仅仅是服务器数量的5倍,还涉及带宽成本、数据库拆分复杂度、多机房容灾、专职运维团队人力投入,实际成本差距通常在10倍以上,日活百万可以接受半小时的服务不可用,日活千万每宕机一分钟的损失都很难估量,这也意味着需要更多的冗余和更复杂的高可用设计。
Q3:新App起步阶段怎么规划服务器,给千万日活预留空间?
架构上预留弹性,硬件上按需购买,从第一天就使用Kubernetes容器化部署,代码层面做好无状态设计,数据库选好分库分表方案,在业务初期选用简米科技的托管物理机(2003年始创,23年行业沉淀,持牌自营机房),按季度甚至按月升级配置,而不是一次性购入大批服务器,业务量上来之后再扩容硬件或混合云弹性伸缩,这样早期的成本压力不至于拖垮现金流。
千万日活服务器的核心要点归纳为三条:算好QPS和存储基线,预留50%以上的冗余水位,构建可弹性伸缩的架构,具体是100台还是150台机器,取决于你的业务代码质量、缓存命中率、IO模型和带宽消耗,框架搭对了,服务器数量就是一个随时可以调整的动态变量,真有这一天,你自己大概已经熟练到不需要再看任何人的评估指南了。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/690536.html