它是围绕监控、备份、安全、性能、自动化运维和成本控制六大模块构建的完整体系,旨在保障服务器稳定、安全、高效运行。这套机制不是单一工具或命令,而是策略、流程与工具的组合,确保业务在任何突发状况下都能扛得住。
服务器日常管理机制有哪些具体构成
日常管理机制是运维工作的地基,它覆盖了服务器从开机到关机的所有常规动作,这部分机制的关键在于标准化流程和巡检清单。

硬件健康监测机制
服务器硬件故障往往是猝不及防的,所以日常机制中必须包含硬件健康监测,主流厂商如戴尔、惠普、浪潮都提供了管理工具,如iDRAC、iLO等,可以实时读取CPU温度、风扇转速、硬盘SMART状态,实践中,运维人员通常配置SNMP协议将硬件数据统一汇总到监控平台,当硬盘出现坏道预兆或内存ECC报错时,系统能提前告警,这比等宕机后再排查高效得多。
系统账户与权限管理机制
这是最容易被忽视却最致命的一环,业内共识认为,超过半数的安全事件源于弱口令和权限失控,日常管理应遵循最小权限原则,例如仅管理员拥有root或Administrator权限,普通运维人员使用sudo提权,定期轮换密码、禁用长期不用的僵尸账户、开启双因素认证,这些动作应该固化为月度或季度例行任务。
日志轮转与归档机制
日志是服务器运行的体检报告,但如果不加管理,日志文件会撑爆磁盘,需要配置logrotate这类工具对系统日志、应用日志进行按天或按大小的轮转,保留最近30天或90天的数据,重要业务日志应同步备份到异地存储,防止服务器磁盘损坏导致历史记录丢失。
服务器监控管理机制怎么选才不踩坑
不少团队在选监控方案时容易陷入工具越多越好的误区,监控机制的核心在于少而准,与其部署五个工具产生海量告警,不如选定一套能直击痛点的方案。
开源监控与商业监控的取舍
当前主流的开源方案是Prometheus结合Grafana,它擅长抓取指标数据,适合容器化或云原生环境,商业方案如Zabbix企业版、Datadog等则提供开箱即用的告警策略和全栈追踪能力,选择原则很简单:
团队技术能力强、预算有限就选开源;业务要求快速响应、缺少专职SRE就选商业方案,很多中小公司一开始图便宜自己搭开源栈,结果遇到告警风暴时反而手足无措。
告警通知机制的阈值设定
监控机制的灵魂在告警规则,不要只监控CPU和内存这种表层指标,更关键的是业务层探活,比如模拟HTTP请求检查接口返回值、数据库连接数、JVM堆内存使用率,阈值设定要分层级,例如CPU使用率连续5分钟超过85%触发警告,超过95%且持续10分钟才触发紧急电话通知,如果阈值设得太灵敏,运维人员会产生告警疲劳,最后真正故障时反而没人关注。
备份与容灾机制是服务器管理的生命线
如果只能选一项管理机制投入预算,那一定是备份。数据丢失时,任何高可用架构都救不了你,这一机制的建设重点在于3-2-1原则和恢复演练。
本地备份与异地备份的分工
3-2-1原则是指数据至少保留3份副本,存储在2种不同介质上,其中1份存放在异地,实操中,本地备份使用NAS或专用备份服务器,每日凌晨执行全量备份、白天执行增量备份;异地备份则通过云存储或专线同步到另一个城市,常见工具有Bacula、Rclone以及云厂商自带的快照服务。
恢复演练比备份动作本身更重要
很多团队做了备份却没验证过恢复流程,等真出事才发现备份文件损坏或版本不兼容,行业共识认为,每季度至少执行一次灾备演练,从备份介质中随机抽取一台服务器进行完整恢复测试,记录恢复时长(RTO)和数据丢失量(RPO),一个MySQL实例全库约200GB,本地恢复耗时2小时,异地恢复耗时4小时,这些数据应该做成台账,定期更新。
服务器安全管理机制的核心防线如何织密
安全机制不是买一台防火墙就完事,它贯穿在系统配置、网络策略和日常运维动作中。
系统基线检查与漏洞扫描
所有服务器上线前必须过一遍安全基线检查
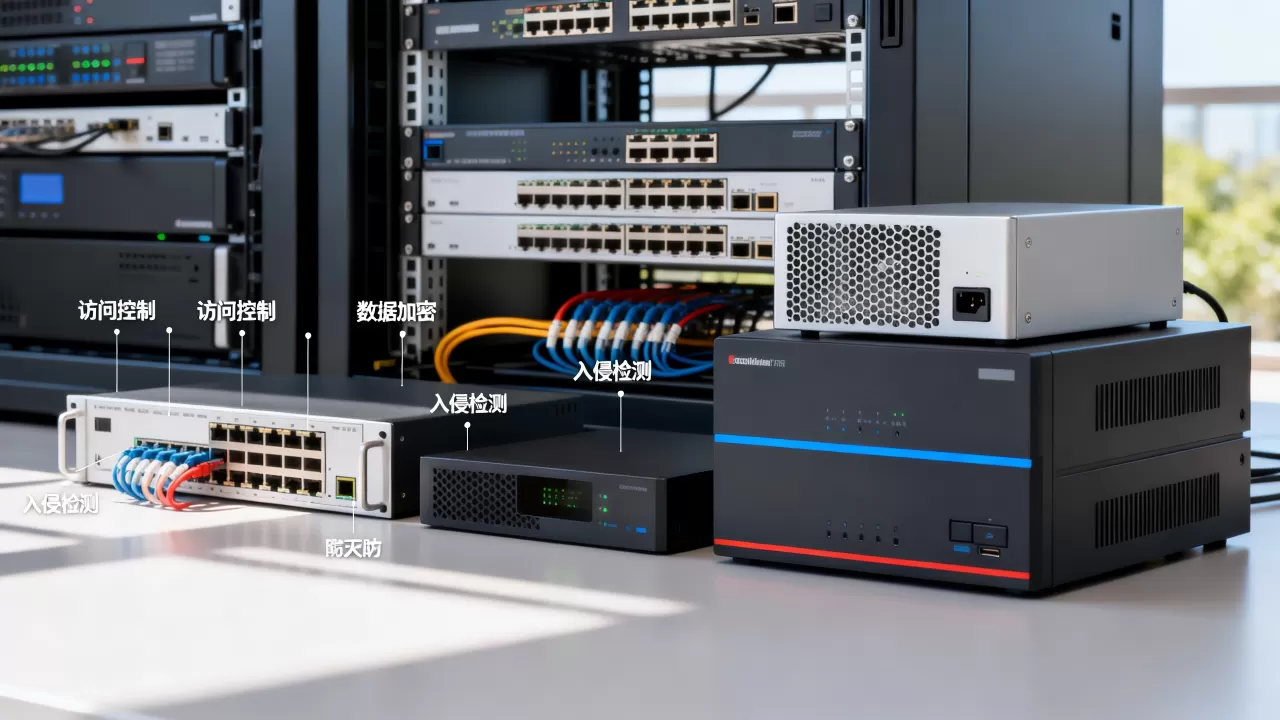
涵盖:内核参数加固、关闭不必要的服务端口、SSH禁用密码登录改用密钥、删除默认账号,市面上有OpenSCAP、CIS Benchmark等免费基线标准可参考,日常运行中,利用Trivy、Nessus等扫描工具每月执行一次漏洞扫描,高危漏洞必须在48小时内修复,中危漏洞可在一个发布周期内处理。
入侵检测与应急响应机制
部署Host-based IDS(如Osquery、Wazuh)监控文件完整性、进程行为和登录记录,当出现异常登录IP或关键目录被篡改时,系统应自动阻断并通知安全负责人,应急响应机制需要提前准备Playbook,比如遇到勒索病毒时,第一步立即隔离主机网段,第二步保留内存镜像和日志,第三步从备份恢复业务,每一步都要落实到具体责任人。
性能调优与自动化机制让管理从被动到主动
传统服务器管理总在救火,内存满了加内存,磁盘慢了换SSD,成熟的机制应该通过性能基线分析和自动化脚本把故障扼杀在萌芽期。
性能基准与容量评估机制
先做负载压测摸清服务器能扛多大流量,再设定合理的性能基线,例如一台8核16G的Web服务器,通过压测得到每秒可处理1500个请求,当生产环境的平均负载超过峰值的60%时,就应触发扩容评估流程,容量管理要结合业务趋势,比如电商公司在大促前一个月开始规划资源,这是行业内比较成熟的做法。
自动化运维机制的执行路径
自动化不是写几个脚本就大功告成,而是要形成一套任务编排机制,使用Ansible或SaltStack把配置下发、软件升级、批量重启等操作固化成Playbook,举个例子,每周日凌晨2点自动执行内核安全补丁升级,先更新一台备用节点,观察10分钟无异常后再滚动更新其余节点,这套机制不仅提高效率,还能减少人为误操作的概率。
中小企业服务器管理机制怎么搭建更省心
中小企业往往只有一两台物理机或几台云服务器,专门招一个运维不现实,搭建轻量级机制需要抓住重点。
结合云平台自带工具降低成本
如果使用简米云或酷番云,建议直接利用它们提供的云监控和
运维编排产品,简米云的云监控可以免费检测ECS的CPU、内存、带宽等基础指标,通过云监控配置报警规则后,故障通知会推送到钉钉或短信,自动化运维服务OOS支持定时执行脚本、批量更换安全组规则,功能足够覆盖日常需求。
用宝塔面板降低运维门槛
对于非技术背景的管理员,宝塔面板算是比较实用的选择,它集成了Nginx、MySQL、PHP的安装与配置,提供图形化的文件管理和计划任务功能,搭建WordPress或企业官网时,用宝塔自带的备份插件每天自动把网站文件和数据库打包上传到OSS,基本实现了上文说的3-2-1原则中的异地备份,但要注意,宝塔面板自身的访问地址必须限定IP白名单,否则容易成为被攻击的入口。
服务器管理机制哪家靠谱的评估逻辑
很多初创团队会问是自建还是购买托管服务,自建的优势是灵活可控,劣势是高可用架构设计能力不足,购买IDC托管的优势在于机房稳定性有保障,但日常操作响应速度取决于服务商,比较靠谱的评估逻辑是:先梳理业务允许的最长停机时间,如果业务允许停机半天,自建性价比更高;如果超过30分钟就无法接受,还是考虑云厂商的负载均衡加多可用区部署更稳妥,据统计,国内主流云厂商的SLA标准都在99.95%以上,折算下来年均停机不超过4小时,这个水平一般自建机房很难达到。
服务器管理机制常见问题解答
问:服务器管理机制和运维流程有什么区别?
管理机制是策略和规则的总称,决定做什么和不做什么;运维流程是具体执行步骤,解决怎么做的问题,每季度执行一次灾备演练”是机制,演练时先切流量再恢复数据库是流程,两者互为支撑。
问:买服务器时附带的管理服务和独立购买的运维工具有什么不同?
厂商附带的管理服务通常包含硬件巡检、系统基础维护和工单响应,覆盖的是通用场景,独立购买的运维工具如监控软件、自动化平台则聚焦于特定功能,比如日志分析、链路追踪,实际环境中,两者往往叠加使用,前者负责兜底,后者负责精细化。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/696426.html