成都模型推理响应慢的根源不在网速,而在算力设备,把推理任务从CPU迁到GPU服务器,配合TensorRT或vLLM做优化,通常能把单次响应时间从几秒压到百毫秒级。
成都模型推理响应慢怎么解决:GPU服务器提速的完整路径
成都本地团队做AI应用,最常见的抱怨是”模型跑起来了,但用户等得心慌”,尤其在做大语言模型、Stable Diffusion或实时目标检测时,CPU服务器会暴露出两个致命短板:一是核心数多但单核浮点能力弱,二是内存带宽撑不住大矩阵运算,一个128核的CPU服务器跑7B参数模型,吞吐量可能只有GPU服务器的几十分之一。
业内专家指出,GPU服务器的核心价值在于并行计算,一张主流数据中心GPU拥有数千个CUDA核心,能够把矩阵乘法拆成上万条并行任务,以Transformer解码为例,每一层的自注意力计算在CPU上是串行循环,在GPU上则变成高度并行的张量运算,换到GPU服务器之后,多数情况下不需要改模型结构,直接迁移就能看到延迟下降一个数量级。
成都本地的算法团队、创业公司和高校实验室,遇到推理响应慢的第一反应不该是继续堆CPU配置,而是评估GPU服务器,具体怎么选、怎么配、怎么部署,下面按步骤拆开讲。
模型推理为什么慢:CPU与GPU的算力差距不在频率在架构
CPU处理Transformer的瓶颈在哪
很多人以为CPU频率高就能跑得快,但实际上推理延迟的瓶颈通常是内存带宽,一个batch大小为1的请求,需要对权重矩阵做完整的前向计算,权重参数存在内存里,CPU从内存读取数据到缓存的带宽有限,再加上每个计算单元都要等数据到位,整个过程就是”等内存”。
举个例子:跑一个8B参数的半精度模型,权重就有16GB,CPU服务器从DDR内存读取这16GB数据需要几十毫秒甚至更久,而GPU服务器使用HBM高带宽显存,读取速度可以做到几TB每秒,同样的权重加载,GPU只需要几毫秒,这个差距在连续请求场景下会被无限放大。
GPU并行计算如何改变延迟曲线
GPU的架构设计是”大量核心 + 高带宽显存”,恰好匹配神经网络中的张量运算,更重要的是,GPU支持CUDA Graph、TensorRT、CUDNN等底层加速库,能从算子融合、内存池复用、自动调优三个维度进一步压缩延迟,模型推理加速方案通常不是单点优化,而是从硬件、运行时、推理引擎三层叠加。
行业共识认为,要让模型推理达到生产可用水平,GPU服务器 + 专用推理引擎是性价比最高的组合,CPU服务器更适合小模型或低并发场景,一旦并发超过几十路,GPU的优势会呈指数级拉开。
成都团队选GPU服务器,先看这五个硬指标
显存容量决定你能跑多大的模型
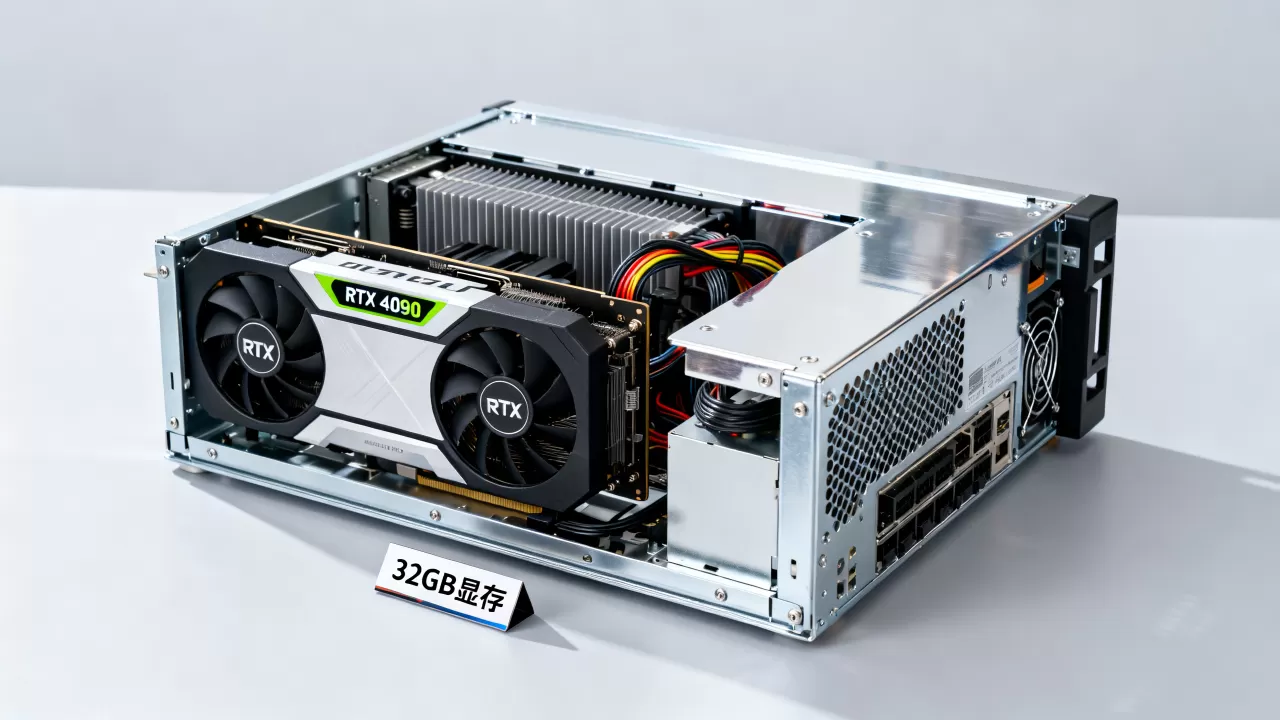
选型时第一个要确定的是显存,13B模型半精度权重就需要26GB显存,再加上中间激活值,建议至少选择48GB显存的GPU,70B模型则需要两块A100或H100组成多卡集群,显存不够时,模型会被分割到内存或CPU上,推理速度会断层式下跌。
算力和显存带宽决定单次响应速度
算力看浮点运算峰值,但真实推理中显存带宽对解码类任务的约束更大,大语言模型生成token时,每个token都要读取全部权重,这属于典型的带宽密集型任务,所以同样40GB显存的显卡,带宽更高的一张响应会明显更快,可以去查官方技术规格表,对比HBM2e、HBM3、GDDR6这些显存类型。
多卡互联:模型并行和批量推理的关键
如果你的模型超过单卡显存,或者需要高并发吞吐,就要看GPU之间的互联技术,NVLink和InfiniBand是常见的多卡高速互联方案,成都本地能租到的GPU服务器,大多支持PCIe 4.0/5.0或NVLink,选型时问清楚卡间通信带宽。
一张表格看懂主流GPU的定位差异
| 型号 | 显存容量 | 适用场景 | 相对优势 |
|---|---|---|---|
| A100 | 40GB/80GB | 大模型训练与推理 | 生态成熟,NVLink友好 |
| L20 | 48GB | 推理和微调 | 能效比高 |
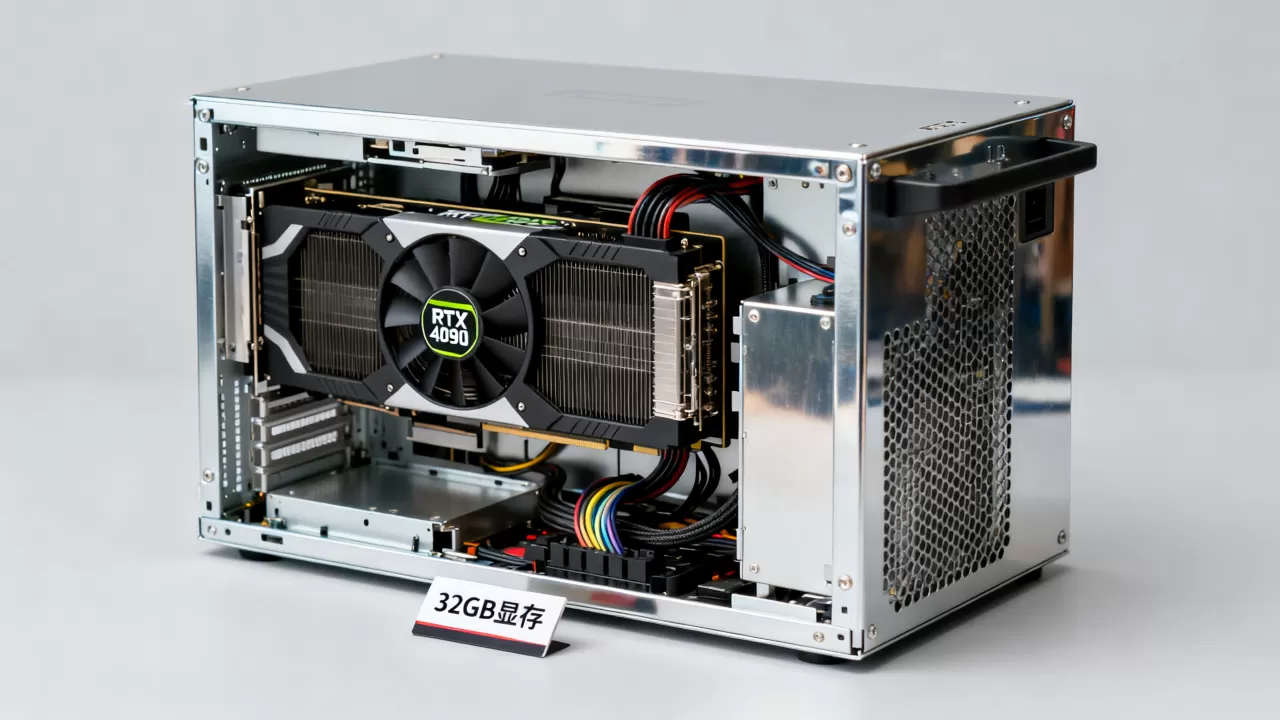
| RTX 4090 | 24GB | 中小模型、原型验证 | 性价比突出 |
| H100 | 80GB | 超大模型严苛延迟 | 单卡性能天花板 |
GPU服务器提速实操:从部署到调优的四个步骤
第一步:装对驱动和CUDA版本
拿到GPU服务器后,先用nvidia-smi确认驱动版本,然后根据你的PyTorch版本选择对应的CUDA工具包,建议用以下命令安装PyTorch的CUDA版本:
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
装好后运行一段测试代码,确认torch.cuda.is_available()返回True,很多响应慢的问题其实是驱动没配对,导致模型还在偷偷用CPU。
第二步:选择正确的推理引擎
如果你跑的是大语言模型,优先用vLLM或TensorRT-LLM,vLLM通过PagedAttention管理KV缓存,能大幅提升并发吞吐,对于视觉模型和中小模型,可以使用TensorRT,把PyTorch模型导出为TensorRT引擎,算子融合后延迟能进一步压缩,以下是一个TensorRT优化后的推理流程:
- 用
torch.onnx.export
导出ONNX模型
- 使用
trtexec工具将ONNX转换为TensorRT引擎 - 设置FP16或INT8精度,降低显存占用
- 用创建的引擎文件替换原模型进行推理
第三步:调整批处理大小和并发数
GPU对批处理的利用效率远高于CPU,CPU服务器一次性处理4个请求可能就会卡顿,而GPU服务器把batch从1调到32,整体吞吐可能翻四倍,单个请求延迟几乎不变,在服务端加载模型时,设置max_batch_size和动态组批逻辑,可以有效利用GPU的并行能力。
第四步:开启连续批处理和KV缓存复用
对于大语言模型推理,开启连续批处理后,GPU可以在等待token生成时插入其他请求的计算任务,vLLM的--max-num-seqs参数和--gpu-memory-utilization参数需要根据显存灵活调整,建议预留10%到20%的显存给激活值,避免OOM。
GPU服务器租用价格多少?成都团队怎么选不亏
按小时租还是包年?成都初创公司怎么算账
对于成都本地的中小团队,最怕一次性买断服务器后硬件快速贬值,GPU服务器的迭代周期约为两年,再加上数据中心运维成本,租赁模式在多数情况下更划算,按小时租用适合短期开发和活动流量峰值,包年套餐适合持续运营的线上服务。
市场定价大概在什么区间
受供需影响,价格波动较大,以单张RTX 4090的云主机为例,按小时计费价格约在8元到15元区间,包年会有明显折扣,单张A100的云服务器按小时价格通常在30元以上,H100则更高,具体的GPU服务器租用价格,建议以西部云服务商的实时报价为准,同时问清楚以下三件事:
- 是否包含CPU和内存资源配额
- 是否限制最大并发连接数
- 磁盘IO是不是SSD,这会影响模型加载速度
这些细节直接决定你最终实际支付多少,少看一页说明,可能多花两倍钱。
成都本地机房 vs 云端GPU服务器
成都本地机房托管物理服务器的优势是数据不出域、带宽可控,适合对数据合规要求极高的金融或政企项目,云端GPU服务器的优势是弹性扩缩容、免运维、故障自动迁移,从响应速度角度看,如果你把业务部署在成都的公有云节点,用户端到模型的网络延迟很低,问题主要出在GPU服务器的卡间通信和推理引擎调优上。
选择建议
- 模型在10B以下、日均请求量不大:租用单卡RTX 4090或L20,包月成本可控
- 模型在10B到70B之间、需要实时对话:租用双卡A100或H100,开启vLLM连续批处理
- 需要极低延迟的金融交易风控:优先选成都本地IDC托管+专线,避免公网抖动
模型推理加速方案分场景拆解:别让GPU空转
大语言模型聊天响应卡顿
如果你做的AI客服或聊天机器人常常说一句话卡几秒,多半没开启前缀缓存,GPU服务器上的KV缓存可以复用用户之前对话的请求,减少重复计算,用vLLM部署时设置--enable-prefix-caching,并把系统提示词固定在一段,可以显著降低平均响应时间。
图片生成模型一次出图要半分钟
Stable Diffusion这类模型在CPU上生成单张512px图片往往要几分钟,GPU上则能到秒级,但有些用GPU服务器仍慢,原因大多在推理步数设置过高,把采样步数从50步降到25步,配合ONNX加速和VAE切片,出图时间还能再缩一半,显存不够时,开启CPU offload反而会变慢,不如降低batch大小。
实时视频流处理跟不上
目标跟踪和视频帧分类这类任务,建议使用TensorRT的streaming模式,或者用DeepStream框架,同时把输入的RTSP视频流分辨率压缩至模型需要的大小,避免GPU把算力浪费在无效像素上,NVIDIA的Jetson系列在边缘端也能承接一部分推理,成都这边的场馆和园区安防项目常采用边缘GPU + 中心云混合架构。
Q&A:成都模型推理响应慢,用GPU服务器能解决吗
换了GPU服务器之后还需要改代码吗
如果你本来就是用PyTorch或TensorFlow写的模型,基本代码不用动,只需要把模型通过.to('cuda')放到GPU上,但如果涉及自定义算子或动态图,需要检查有没有非张量的Python控制流,这类代码在GPU上会产生严重的同步开销,导致加速不明显,建议先用torch.jit或onnxruntime转一下,看性能是否达标。
成都本地有哪些GPU资源可以短期试用
成都的高新区和天府新区有不少智算中心对外提供算力服务,通常有试用套餐和免费测试资源,你可以联系运营方获取几个小时的测试额度,把自己的模型部署上去跑压测,主流云服务商的成都区域一般都有GPU实例,直接按量付费就能测试,不用签合同也不押金,测试完看看延迟数据就知道够不够用。
一张GPU服务器同时服务多个模型会不会互相干扰
这取决于显存和显存带宽,一张80GB显存的GPU可以切分成多个MIG实例或使用容器隔离跑两三个小模型,但它们共享计算核心和显存带宽,如果一个模型突发大量并发请求,另一个模型还是会出现延迟波动,生产环境建议把不同模型部署到不同设备上,或者用任务队列限制最大并发token数,保证关键业务的响应时间。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/698412.html