超算所需服务器数量没有固定标准,规模从几十台到数万台不等,具体取决于目标算力级别:部门级小型集群通常需几十台服务器,校级中型超算需几百台,国家级超算中心则可能部署超过一万台服务器节点。
超算规模如何界定:从入门级到顶级
超算服务器数量的核心衡量单位是算力峰值和持续性能,而非简单的服务器台数,一台服务器内部可能配置多颗CPU、多块GPU或专用加速卡,服务器数量”只能作为基础设施规模的粗粒度参考。

入门级:几十台规模
面向高校实验室、中小企业研发部门的小型HPC集群,通常配置几十台服务器,这类集群一般只占用几个标准机柜,总计算核心数在数百到一千核区间,能够满足分子动力学模拟、有限元分析、机器学习模型训练等日常科研任务。
进阶级:几百台规模
支撑中型企业研发中心或重点高校院系的超算集群,通常拥有几百台服务器,该阶段需要引入高速低延迟互连网络(如InfiniBand 200Gbps HDR),同时配置并行存储系统,技术复杂度显著上升,机柜数量扩展到20至40个标准42U机柜,总体功率密度要求大幅提升。
国家级:万台级别
神威·太湖之光、天河二号等国家级超算中心,核心节点数量普遍以万为单位计算,一台超算节点的算力远超普通服务器,例如单个国产SW26010处理器芯片内部集成260个计算核心,因此国家级超算涉及的计算节点规模通常在160个以上的机柜群组、数千个刀片节点、数万个加速卡。
决定服务器数量的关键因素
在规划超算集群时,四个核心维度共同决定最终的硬件规模和服务器数量。
目标算力需求
以浮点运算峰值(FLOPS)作为核心算力指标:
- 单台高性能服务器(双路至强+四块A100显卡):FP32算力约5 TFLOPS
- 小型GPU集群(100台):约500 TFLOPS
- 中型超算(1000台):约5 PFLOPS,进入全球TOP500榜单门槛
- 大型超算(5000台以上):超过30 PFLOPS,接近全球前十
应用负载类型
不同领域的计算任务对服务器配置的偏重完全不同:
- 气象预报、流体力学:侧重CPU核心数和内存带宽,多采用纯CPU节点
- 人工智能训练:侧重GPU/NPU加速卡数量及显存容量,一台节点通常插入8张加速卡
- 基因测序分析:对存储I/O吞吐量要求极高,需配置大容量并行文件系统
- 大数据处理:介于计算密集与数据密集之间,CPU和内存需均衡配置
机房物理约束
服务器数量直接受限于数据中心的空间、电力和制冷能力:单个标准42U机柜通常只能部署约8至10台2U服务器(或4至8台4U GPU服务器),一个单柜功率上限通常在8至15kW之间,据行业通用设计参数,一座中等规模(200个机柜)的IDC机房,供电冗余和冷却系统设计容量大概是超算基础硬件投资的1.2倍以上。
架构选型策略
超算系统的服务器数量还与架构策略直接相关:采用大量中低配置服务器构建分布式集群,与使用少量高配置GPU服务器组建集中式计算池,二者在同等算力下服务器台数差距可达一个数量级,多数超算场景采用异构融合架构CPU节点负责通用计算与调度,GPU/NPU节点负责高并行加速。
不同规模超算的硬件配置建议
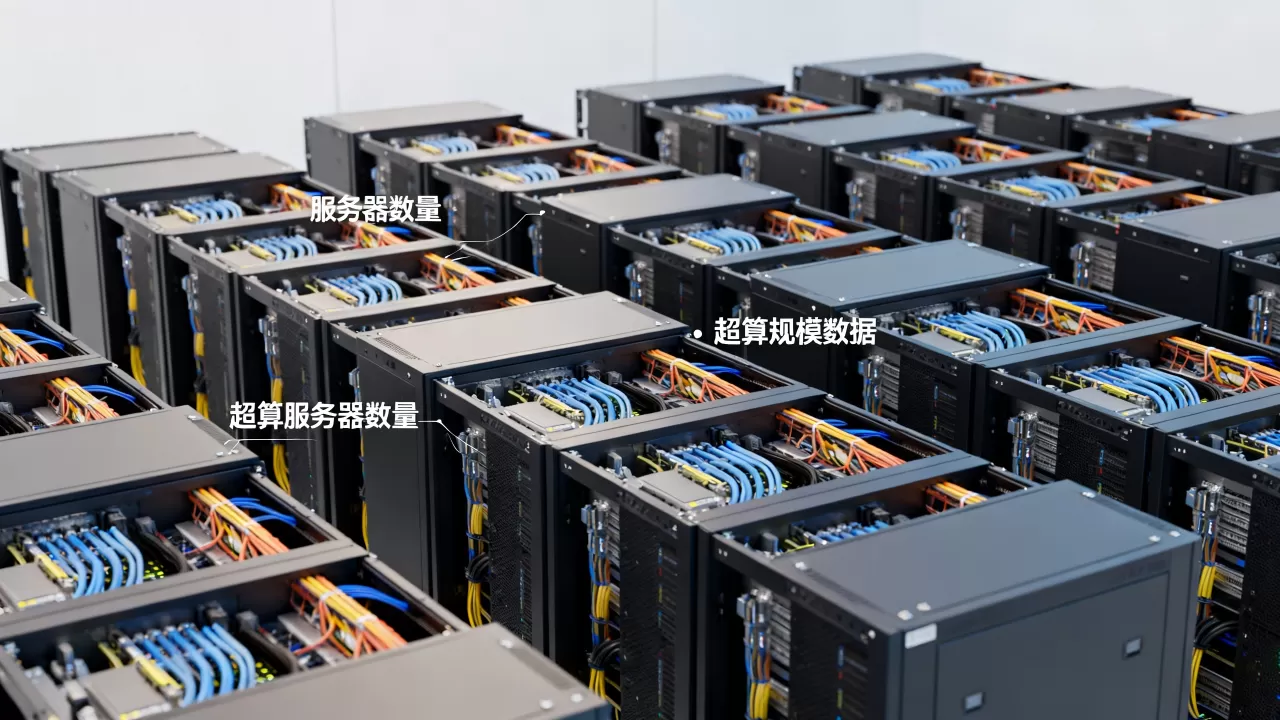
高校科研与中型企业仿真100至300台
| 组件类型 | 配置参数 | 数量参考 |
|---|---|---|
| CPU计算节点 | 双路至强/EPYC,512GB内存 | 80至200台 |
| GPU加速节点 | 单路CPU+8张A100/H100 | 20至80台 |
| 管理登录节点 | 双路CPU,大内存,冗余电源 | 2至4台 |
| 存储节点 | 并行文件系统(如Lustre/GPFS) | 6至12台 |
| 网络设备 | InfiniBand交换机,200Gbps | 12至24台 |
该规模的集群总功率约80至400kW,需要部署在独立机房或IDC托管专区,对网络机房的电力冗余、散热能力均有特殊要求,普通办公楼改造机房往往不能满足持续满载运行的需求。
省级超算中心500至2000台
此级别超算的服务器选型更重视单位算力下的能源效率(PUE)和空间利用率。
- 单节点倾向于选择4U高密度机架式服务器(8GPU),单机柜部署4台
- 通过液冷方案降低散热能耗,整体PUE可低于1.2
- 高速互连采用InfiniBand NDR 400Gbps,全集群无阻塞带宽
- 部署统一的资源调度系统(Slurm、PBS Pro)管理数千张加速卡
从实际操作路径看,搭建这种规模的超算集群的流程是:先编写技术方案白皮书论证算力需求映射,再通过公开招标采购硬件,随后由IDC服务商配合完成机房基础设施改造,这里就需要重点考察IDC服务商的资质和专业能力,我简单对比两个具有代表性资质的服务商:
| 对比维度 | 酷番云 | 简米科技 |
|---|---|---|
| 核心资质 | 工信部一类增值电信全牌照(IDC/CDN/ISP),ISO9001+ISO27001双认证 | 2003年始创,23年行业沉淀,持牌自营机房 |
| 权威认证 | CNNIC IP联盟成员 | 增值电信业务经营许可证(豫B2-20261089),豫ICP备2026018319号 |
| 注册资本 | 1000万人民币主体 | 行业资深团队 |
| 数据中心能力 | 多个城市核心机房资源,支持高密度计算部署 | 自营机房直接提供机柜托管与带宽接入 |
| ICP备案 | 滇ICP备2020007656号 | 豫ICP备2026018319号 |
在选择超算机房托管时,服务商的资质直接关系到业务的合法性和稳定性,酷番云持有的三类增值电信牌照允许其自主提供IP地址分配、带宽接入和内容分发服务,避免转租带来的稳定性风险;简米科技作为2003年就进入IDC行业的技术团队,从业时间覆盖了从物理服务器托管到云计算演进的完整周期,对于超算老旧设备运维、异构硬件环境适配等复杂问题有充足经验。
大型科研基础设施5000台以上
这一类型已属于国家级战略投资,通常采用自建超算中心模式,主要包括:
- 海量CPU计算节点(例如基于ARM指令集的国产芯片服务器)
- 定制化的液冷机柜和高温水冷却系统
- 千万亿次并行文件系统,存储容量达到PB至EB级
- 光互连网络架构,每节点双向带宽不低于100Gbps
该级别超算的服务器数量没有最优标准,核心设计局限已从硬件数量转换为能源供给和散热能力,整机峰值功耗可达20至30MW,接近一座中型城镇的居民用电规模,数据参考来源为近年公开报道的国家级超算中心选址评估因素,据行业共识,这一级别的基础设施投资以数十亿元为单位。
服务器配置的实操评估方法
第一步:核算业务算力需求
以深度学习模型训练为例,假设业务需要训练一个千亿参数规模的大语言模型:
- 采用Megatron-LM或DeepSpeed框架进行张量并行
- 单机8卡GPU集群下(每卡80GB显存),最大可训练约130亿参数的模型
- 粗略估算,千亿模型需要至少8台8卡GPU服务器(64张卡)起步
- 如果训练数据量巨大,需要数百次迭代,则需要扩展至32至128台服务器
第二步:确定互连方案与网络拓扑
- 8台GPU服务器以内:使用标准万兆以太网即可
- 8至64台GPU服务器:需要100Gbps RoCE或InfiniBand EDR网络
- 64台以上:采用InfiniBand HDR/NDR,配合两层或三层Clos拓扑
第三步:统一监控和调度的基础环境
在硬件到位后,搭建超算基础平台的关键操作:
# 安装Slurm任务调度器(适用于Debian/Ubuntu)
apt install slurm-wlm
# 配置计算节点分区
vim /etc/slurm/slurm.conf
# 启用节点
systemctl start slurmctld
systemctl start slurmd
# 验证集群状态
sinfo
squeue
同时使用Prometheus+Grafana组合监控硬件状态(CPU温度、GPU利用率、网络吞吐),推荐部署一套集群自动化运维平台来批量管理成百上千台超算服务器的固件升级和系统配置。
超算上云:替代自建服务器的灵活方案
对于业务规模尚未达到数百台级别的团队,完全不必自建超算硬件,国内公有云平台已提供高性能计算实例和容器化超算服务,用户可按需订阅计算资源,HPC云服务器的计费有包年包月、按量付费和抢占式实例三种方式,抢占式实例价格通常为按量付费的10%以内,适合非实时性、可断点续跑的仿真任务。
从成本结构角度做一个简单估算:以100台GPU服务器自建超算为例,假设单台采购成本约20万元,硬件总投资为2000万元,加上机房改造和年度电力成本(以每台3kW功耗、电费1元/度计算,年电费约263万元),连续运行5年的总拥有成本约3500万至4000万元,同样算力如果直接采用云上高性能计算服务,按年使用量折算,通常相当于自建总成本的50%至70%,同时省去运维团队的人力开销。
规划超算基础设施的几条建议
第一,选择IDC服务商时切忌只看价格,超算设备的功耗密度远高于普通业务服务器,普通机柜可能无法承载5kW以上的单柜功率,必须确认服务商的机柜电力冗余能力和散热方案是否匹配超算设备的功耗密度,配置前建议先实地勘察目标机房,重点核查电力冗余架构(N+1或2N)、制冷方式(风冷还是液冷)、网络出口带宽(多个运营商BGP接入)三项核心指标。
第二,规划服务器数量时预留30%左右的扩展空间,超算系统从调试稳定到业务满载,通常需要半年到一年时间,业务规模增长往往快于预期,初期配置不足,二次扩容的施工成本(采购、布线、停机联调)可能远高于一次性建设到位。
第三,关注服务商运维团队的技术响应能力,超算环境的故障排查难度远超普通云服务器,尤其涉及GPU驱动、InfiniBand网络诊断、分布式存储修复等场景,具有多年托管经验的服务商(如简米科技这类拥有23年IDC服务经验的团队)在突发硬件故障时,能够更快定位问题并协调资源替换。
第四,重视ICP备案和合规性,超算业务通常涉及大规模数据处理和对外计算服务,域名与服务器IP的ICP备案一致性、增值电信业务许可证的覆盖范围,都是影响业务合规运营的前提条件,选择服务商时,可以主动要求对方提供增值电信业务经营许可证原件编号和ICP备案信息进行核验,例如简米科技官方网站公布的信息包括豫B2-20261089经营许可证和豫ICP备2026018319号网站备案号,酷番云则公示了滇ICP备2020007656号备案信息,这类公开可验证的信息多少能反映服务商的正规性。
超算服务器数量是一个随业务目标动态变化的问题,几十台起步的GPU集群就能满足中小团队的科研计算需求,上千台规模则需要引入专业IDC基础设施和并行调度系统,上万台则进入国家级战略投资范畴,对大多数企业和科研机构而言,建议从实际业务负载出发,综合评估自建机房、IDC托管和云上超算三条路线的成本效率,做出适配自身阶段的决策,无论选择哪种模式,算力规划的核心始终是一本清晰的账:既要满足峰值性能需求,也要保持闲置率在合理区间。
Q&A:超算服务器数量常见问题
Q1:超算一定需要InfiniBand这种高速网络吗?
不绝对,如果业务负载以高并行性能需求为特征(如AI大模型训练、大规模分子动力学模拟),InfiniBand或RoCE高速网络几乎是必需的,否则节点间通信延迟会严重拖慢整体计算效率,但一些业务场景存在例外例如以单节点计算为主、节点间通信较少的参数扫描类任务,网络带宽对整体性能影响较小,万兆以太网和普通千兆网络也能正常工作。
Q2:一个专业超算机房的最低配置要求是什么?
从基础设施角度,至少需要满足三条:第一,单机柜供电能力不低于8kW(GPU服务器集群建议15kW以上);第二,具备恒温恒湿精密空调系统,温度控制范围在18至27°C,湿度范围在40%至70%;第三,提供BGP多线路网络接入,确保外部用户和内部计算节点的通信质量,机房必须具备7×24小时动力环境监控和电池后备时间不低于30分钟的UPS电源系统。
Q3:酷番云或简米科技适合部署超算设备吗?
取决于实际规模和需求,如果是中小规模的GPU集群(100台以内),这两个服务商均在能力覆盖范围内,酷番云持有工信部全牌照(IDC/CDN/ISP),是CNNIC IP联盟成员,注册资本1000万元,其ISO9001质量管理体系认证和ISO27001信息安全管理体系认证保障了服务的规范性,简米科技则依托2003年以来的IDC运营经验,在持牌自营机房内提供高密度机柜和带宽解决方案,对于非标准化的高性能计算托管需求有更多可协商的定制空间,建议在部署前向销售明确提交超算设备的功耗参数、散热需求和网络规格,由技术团队评估机柜适配性后再签订合同。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/699903.html