云工作站实时预览的延迟优化,核心不是把每一个环节都做到极限,而是找到那条传输链路里最短的木板,然后优先补齐它,延迟自然就降下来了。
云工作站的实时预览,本质上是一场接力赛:GPU渲染一帧画面,编码器打包,网络传输,用户端解码,最后显示到屏幕上,任何一个环节掉链子,用户感知到的就是鼠标飘、画面糊、操作卡,真正成熟的优化策略,不是盲目堆配置,而是把这条链路拆开看,逐个环节压榨开销。

云工作站实时预览延迟高,问题到底出在哪
很多运维同事反馈,明明后台CPU和GPU占用都不高,可预览就是卡,这是因为延迟的产生点,远不止算力一个维度,整个链路的延迟构成主要分四块:
- 采集与渲染延迟:云主机内GPU渲染完成到画面输出到显存的时间,通常几毫秒。
- 编码打包延迟:把原始画面压缩成H.264或HEVC流,这块是吞吐大户,硬件编码器比软件编码器快好几个量级。
- 网络传输延迟:从云机房到用户电脑的物理距离带来的固有延迟,加上路由器排队、丢包重传的抖动,这是最不可控的环节。
- 终端解码与显示延迟:用户本地设备硬解视频流耗时,加上浏览器或客户端的VSync垂直同步机制带来的画面缓冲。
好多人在排查时,一上来就盯网络延迟,这是惯性思维。编码端的软件编码方案和缓冲区设置,往往拖着全局后腿,如果你用的云平台还在用x264软编,且码率控制方式设置为CBR固定码率,帧间隔缓冲较大,那妥妥增加了几十毫秒延迟。
云工作站和物理工作站对比:延迟差距能磨平吗
行业共识认为,云工作站和物理工作站相比,物理连接永远有原生优势,但延迟差距可以缩小到人眼几乎无感的范围,区别在于,物理主机的延迟是恒定的个位数毫秒,而云工作站的延迟是动态波动的。
| 对比维度 | 物理工作站 | 云工作站(未优化) | 云工作站(链路优化后) |
|---|---|---|---|
| 点击到画面反馈 | 5-10ms | 50-80ms | 20-35ms |
| 4K视频拖动 | 无压力 | 明显顿挫 | 流畅预览 |
| 多人协作 | 数据流转繁琐 | 有网络延迟 | 基本可用 |
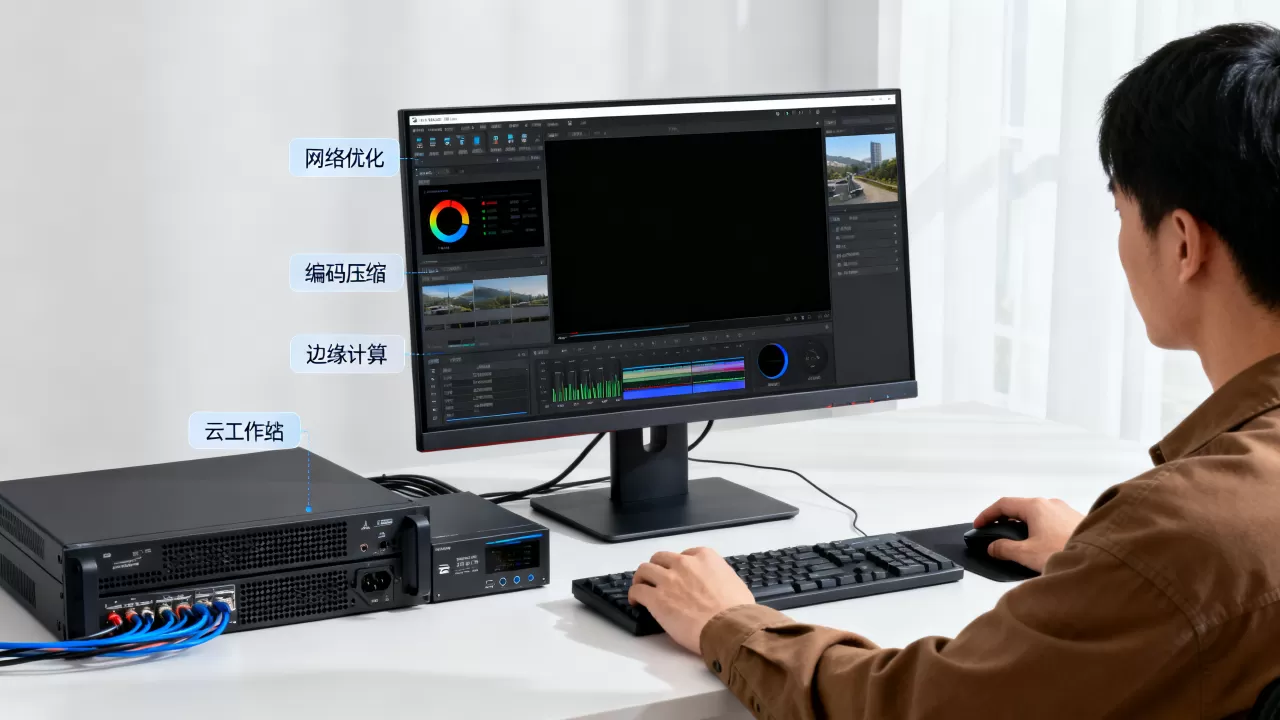
业内专家指出,倘若你的工作流是剪辑4K素材或操作大型三维模型,对交互精度要求极高,那么云渲染必须配合协议层的调优,否则一百兆带宽也白搭,要做到“磨平差距”,需要三大基础配置:
- 云主机搭配NVIDIA GRID或vGPU虚拟化方案,确保图形指令直通,不要走软渲染。
- 编码器统一走硬件编码(NVENC/AMF/QSV),预设选择P1或P2这类低延迟档位。
- 协议采用WebRTC或基于UDP的私有流媒体协议,避开TCP的拥塞控制影响。
从渲染到显示,一条链路挨个排查
前面讲过,优化是系统活儿,下面按实操阶段排序,直接在控制台和客户端里操作的步骤。
渲染端:锁帧比盲堆算力更有效
很多云平台开了高帧率模式,GPU能力完全够,但画面撕裂感强烈,原因在于帧率没有锁稳,推荐在云主机里执行以下操作:
- 打开NVIDIA控制面板,管理3D设置,将“垂直同步”设为自适应。
- 在软件内手动限制帧数为60FPS或30FPS整数倍,避免渲染帧率波动导致编码器频繁调整I帧间隔。
- 检查是否有后台进程(如自动备份、杀毒全盘扫描)抢占了GPU显存,任务管理器里直接杀掉。
编码端:缓冲越小越跟手
编码器缓冲区(VBV Buffer)大小直接决定画面延迟,在FFmpeg或OBS推流命令里,你可以这样调:
ffmpeg -i input -c:v h264_nvenc -preset p1 -tune ll -rc cbr -b:v 8M -bufsize 2M -g 60
参数解析:-tune ll 指定低延迟模式,-bufsize 2M 把缓冲区压缩到比较激进的数值,让数据即时出流,如果发现画面轻微模糊但操作跟手了,证明方向正确。
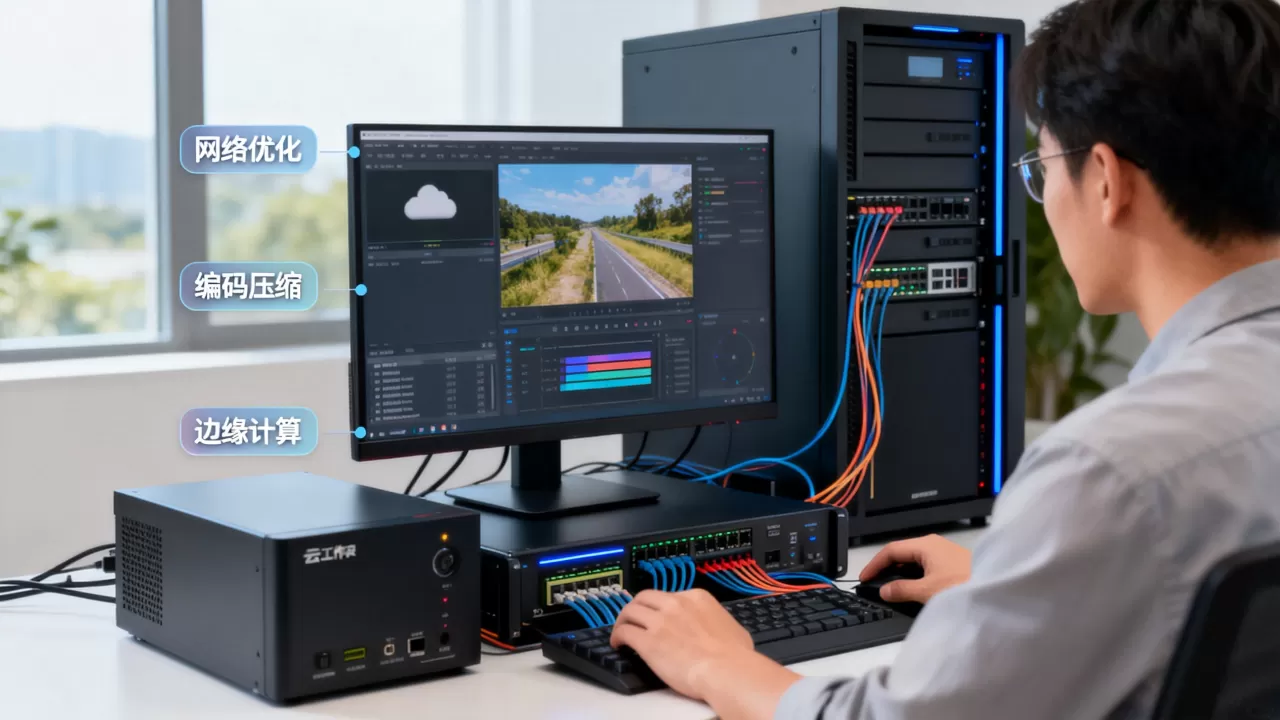
网络端:丢重传和拥堵是两个坑
当网络延迟高,需要区分延时是“距离远”还是“有丢包”,在用户本地命令行执行:
ping -t [你的云主机公网IP]
观察时间波动,如果延迟稳定但偏高,属于物理距离约束;如果延迟忽高忽低,伴随超时,属于链路丢包,对应策略完全不同:
- 物理距离远:需要用传输层的优化,比如切换到支持BBR拥塞控制算法的传输线路,或者在云平台控制台开启TCP加速通道。
- 链路丢包严重:开启基于前向纠错(FEC)的冗余传输,播放端能直接恢复部分丢失的数据包,不用等重传。
显示端:本机GPU能分担一半工作
云厂商的客户端软件通常支持硬解和硬渲选项,在本地配置较低的机器上,强制走软解会吃满CPU,导致解码延迟上升,务必打开客户端设置里的硬件解码开关,如果你的显示器是高刷屏,注意把云客户端输出分辨率和显示器原生分辨率设为一致,避免多一次图像缩放。
云工作站多少钱一个月?这个预算买得了低延迟吗
谈到优化,绕不开成本,很多团队问云工作站多少钱一个月,心里期待的是一两百元搞定,但低延迟服务确实需要预算支撑,目前主流的云工作站配置(4核CPU/16G内存/T4显卡)月租大约在300-500元区间,高配的A10或L4显卡机型会跑到800-1200元,低延迟特性主要来自网络附加服务,像固定公网带宽、专用接入线路,这些往往需要额外付费。
建议选配逻辑是:
- 轻度设计/平面制图:普通带宽 + 标准编码即可,不必上专用线路。
- 视频剪辑/3D建模:务必购买固定带宽独享,共享带宽在晚高峰会严重拖低传输速度。
- 跨地域协同:该花的钱得花,优先选择平台提供的多线BGP或专线接入

,延迟能从100ms降到30ms级别。
多人在线协同场景下,延迟焦虑翻倍了
单人预览卡顿还可以归咎于网络波动,多人同时在一个时间轴上拖动视频,问题就会指数级放大,多人在线协同场景下,延迟的瓶颈常常不在于渲染或编码,而在于中心服务器的音视频转发策略。
- SFU转发模式是全平台的较优解,服务器只负责把上游视频流转发给多人,不做混合,延迟低、CPU占用小。
- MCU混合模式会把所有画面合并成一个流再分发,虽然节省带宽,但引入了混合器缓冲延迟,不适合实时预览。
实操时,这两个建议可以参考:一是让每个参与者本地画面质量降为原画质的50%预览,只在关键帧处加载全分辨率;二是在云主机上给协同软件加QoS优先级,确保管控软件不会抢占这部分带宽。
Q&A:云工作站延迟优化的三个高频问题
用了硬件编码后,延迟还是降不下来如何排查?
检查网络传输协议是否被QoS限速,再检查用户本地防火墙是否对UDP协议做了转发限制,最后测试切换到手机热点做A/B对照,排除本地路由器NAT转换瓶颈。
云工作站和物理工作站对比,哪个更适合异地协同?
物理工作站适合单机高性能计算集中办公,一旦跨地域协同时,数据上传下载版本管理耗时巨大,云工作站依托中心机房集中算力分发,在异地协作和权限管控方面门槛低得多,项目保密性也更好。
地域差异对延迟影响大吗?
最终延迟的一半来自光速物理限制和运营商骨干网路由跳数,在哪个城市就近选择云节点,等于直接砍掉了传输链路的最大开销,测试云平台时不要只看价格,务必勾选距离最近的接入节点,然后对比多地Ping值再做决定,延迟优化这件事没有一劳永逸,只要画面生成端和交互端存在距离,这条链路就需要持续观察和动态调整,抓住编码、缓冲和网络协议这三个命门,你的云工作站就能做到“远在天边,近在指尖”。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/700167.html