服务器运维系统没有“最好”的,只有最匹配你业务规模和团队现状的方案,主流选择集中在三类:以Zabbix、Prometheus为核心的监控告警系统,以Ansible、SaltStack为代表的自动化运维平台,以及以JumpServer、齐治为代表的堡垒机与审计系统。
监控告警系统:先看清楚服务器在干什么
基础监控:从Zabbix到Prometheus
Zabbix是老牌开源监控工具,行业共识认为它对传统物理机和虚拟机的覆盖非常扎实,你可以通过它监控CPU、内存、磁盘IO、网络流量这些基础指标,它自带的触发器能实现邮件、短信、企业微信告警,部署方式为:在服务器上安装Zabbix Server,被监控机器装Agent,然后在Web界面配置模板和告警阈值。
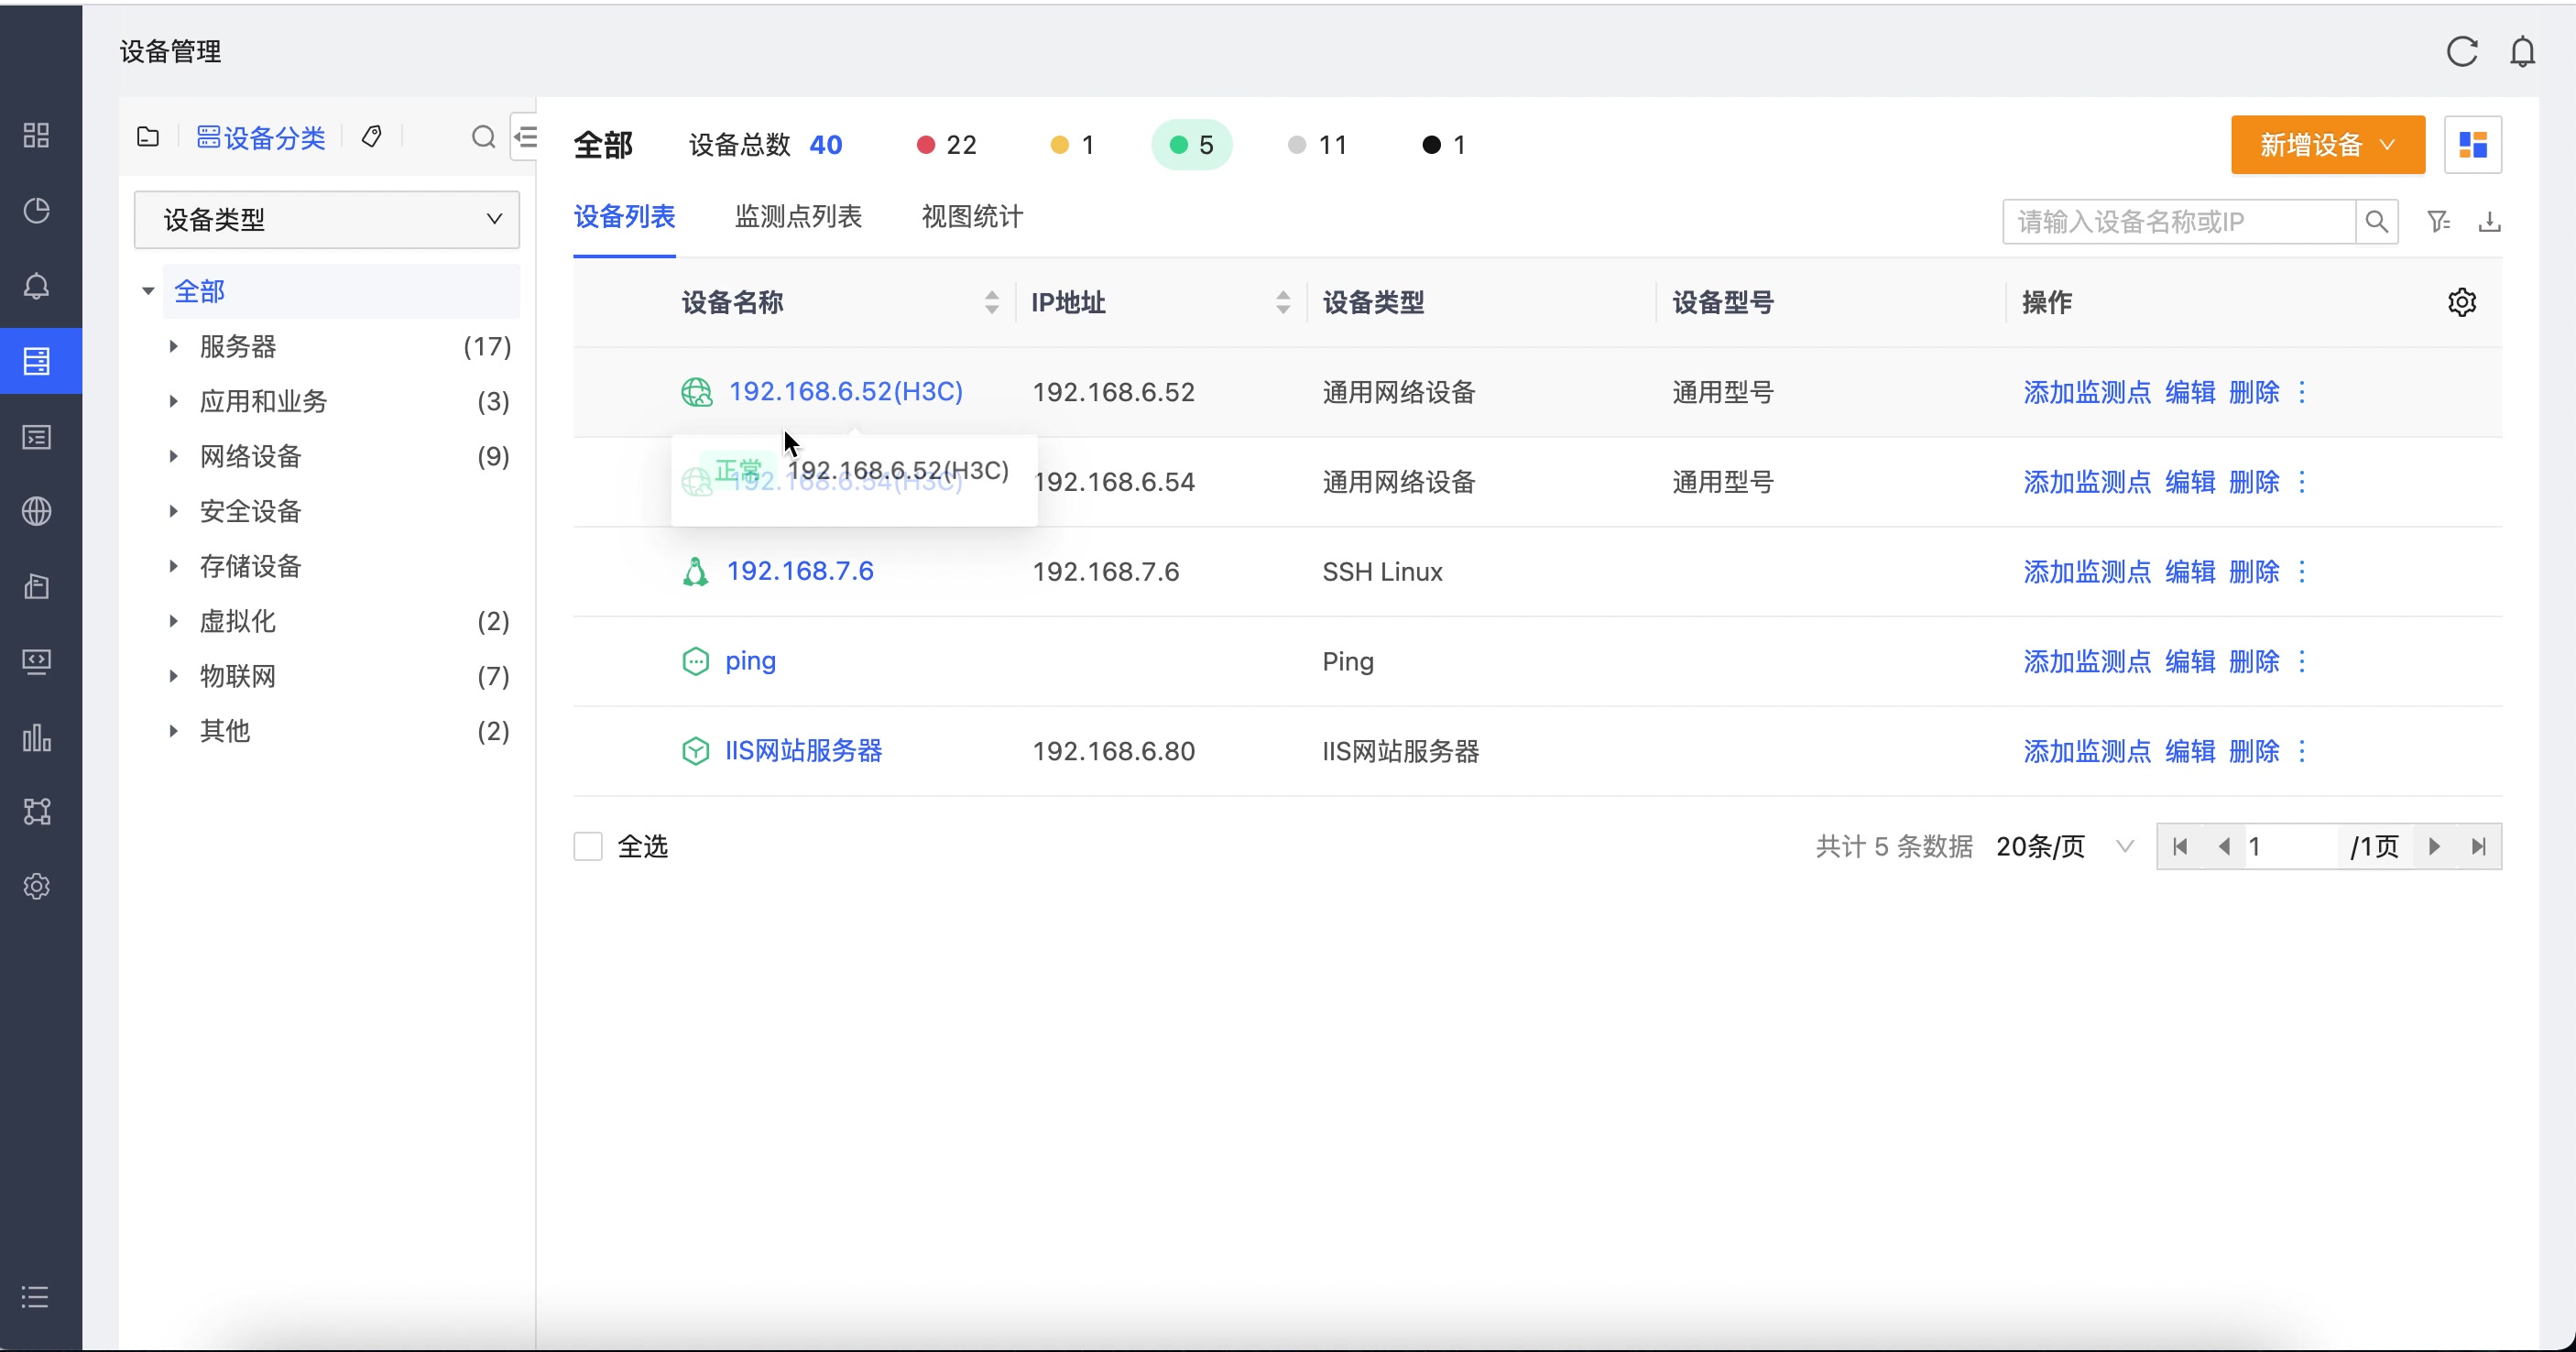

Prometheus则是云原生时代的宠儿,配合Grafana可视化面板,能展示极其细腻的时序数据曲线,它的核心优势在于拉取模型和标签体系,特别适合Kubernetes容器环境的动态服务发现,如果你想监控一个正在快速扩容的微服务集群,Prometheus是更顺手的选择。
拨测与用户体验监控
除了看服务器内部指标,你还需要知道用户端访问是否顺畅。云拨测(如简米云云监控的站点监控)能模拟真实用户请求,从全国甚至全球多个节点发起访问测试,这类工具关心的核心指标是响应时间、可用率、DNS解析耗时,如果你的业务主要服务国内用户,地域上建议重点关注华东、华北、华南节点的拨测数据,这几个区域的网络质量基本代表了大盘用户的访问体验。
日志监控:ELK还是Loki
日志是排查问题的第一手资料。ELK(Elasticsearch + Logstash + Kibana)是经典组合,功能强大但资源消耗偏高,处理每天几GB的日志就需要考虑给Elasticsearch节点预留充足的堆内存。Grafana Loki是后起之秀,它只索引日志的元数据,不索引全文内容,因此存储成本比ELK低约一个量级(仅代表相对比例用于参考,不构成精确数字),如果你预算有限,只是需要集中查看日志、按关键词过滤,Loki结合Promtail采集器是更轻量划算的方案。
自动化运维系统:把重复劳动交给机器
批量操作工具:Ansible与SaltStack
Ansible基于SSH协议,无需在目标机器上安装Agent,学习曲线平缓,你只需要写一份Playbook,就能在数百台服务器上批量执行命令、分发配置文件、部署应用版本,它的命令模式很直接:
ansible all -m ping
ansible webservers -m shell -a "uptime"
第一句测试连通性,第二句批量查看负载,对于10台以内服务器的场景来说,Ansible加一个简单的定时任务就能覆盖大部分日常运维操作。
SaltStack通过ZeroMQ消息队列通信,速度比Ansible快得多,但需要在每台机器上部署Minion进程,在几千台服务器级别的大规模集群场景中,多数情况下SaltStack的推送效率优势明显,但相应地,它的架构复杂度也更高,需要额外维护Master节点的高可用。
脚本与定时任务管理
很多系统自带但被低估的是crontab的集中管理方案,你可以用Ansible的cron模块统一管理所有服务器的定时任务,避免每台机器各写各的,导致后续排查时无所适从。Jenkins不只是CI/CD工具,它也能当作强大的运维任务调度平台,通过Pipeline脚本,你可以把服务器的健康巡检、备份任务、应用重启等操作编排成可视化流水线,每次执行结果都有历史记录和日志留存,方便追溯。
配置管理:版本化你的服务器状态
这里说的配置管理,指的是让服务器的环境配置也具备版本控制能力,例如使用Ansible的roles结构,把Nginx的配置、Java的环境变量、内核参数等全部声明化,这样当服务器宕机需要重建时,不必手工回忆配置过程,只需执行一条playbook,就能在十几分钟内还原出一台环境一致的服务器,这种基础设施即代码的思路,是任何规模团队都值得采用的运维改进方式。
堡垒机与审计系统:管好人能做什么
为什么需要堡垒机
服务器运维系统的拼图里,最容易被忽略却最重要的是访问控制与审计,如果没有堡垒机,开发人员往往直接通过SSH密钥登录服务器,时间一长,密钥很难收回,操作日志无据可查,一旦出现误删数据或恶意操作,根本无法定位责任人。
堡垒机是部署在业务服务器前方的跳板机,所有运维人员必须先登录堡垒机,再通过它跳转到目标服务器,系统会完整记录每个人的操作命令,甚至可以录像回放。
开源与商业堡垒机的定位差异
JumpServer是开源界使用较广的堡垒机系统,功能全面,支持Web终端、SSH客户端、数据库运维等多种协议,它采用组件化架构,包含Core、Luna、Koko等核心服务,部署需要准备一台至少4核8G内存的专用服务器。
商业产品如齐治、行云管家在合规性和易用性上做得更深入,例如央企国企的等保测评中往往有专门的堡垒机审计项要求,商业产品的价值更多体现在服务支持和定制化能力上,中小企业可以优先考虑JumpServer,先满足基本的身份认证与操作审计需求;对合规要求苛刻的行业,选择商业产品更稳妥。
云厂商的托管运维方案
如果公司已经全面上云,使用简米云、酷番云等云厂商的云盾安全管控平台或访问控制(CAM),也是一种轻量级的替代策略,通过RAM子账号授予不同权限,就已经实现了基础的细粒度控制,再结合操作审计服务CloudTrail,可以记录所有API调用行为,用这种方式,就无需自己维护一套堡垒机系统,成本更低。
如何挑选合适的服务器运维系统组合
按场景选型的实用建议
对于初创团队:监控选Zabbix或Prometheus(视技术栈而定),自动化选Ansible,堡垒机先用云厂商的基础RAM授权方案,这套组合的开源软件成本为零,但需要运维人员有一定的命令行走查能力。
对于中大型企业:监控考虑Prometheus + Grafana + AlertManager全家桶,自动化选SaltStack或Ansible Tower(AWX),堡垒机采购商业产品满足合规审计,这套方案能满足数百台服务器的规模化运维要求。
一个常见的误解是以为必须上一套重型的商业化运维平台(如腾讯蓝鲸)才能解决问题,蓝鲸这种PaaS级平台功能极其强大,但学习成本与维护成本同样高昂
,对于大多数团队而言,把开源工具组合用好,效果远好于盲目追求大而全的商业系统。
具体操作路径参考
选定方案后,建议按这个顺序推进落地:
- 先部署监控告警系统,将核心业务服务器的CPU、内存、磁盘使用率纳入监控面板,配置好钉钉或企业微信告警群,设定合理阈值(如磁盘使用率超过80%触发警告)。
- 再搭建Ansible控制机,编写第一批Playbook:系统补丁更新、NTP时间同步、日志清理策略。
- 最后视合规需要部署堡垒机,将日常运维账号统一收编,签发一次性临时凭据替代长期SSH密钥。
常见问题解答:围绕服务器运维系统的选型疑问
问:监控系统到底选Zabbix还是Prometheus?
答:取决于你管什么,如果是物理机、VMware虚拟机较多,Zabbix的网络发现和设备模板更成熟;如果云原生环境占比高,Prometheus的数据模型更适合服务发现与动态伸缩,多数情况下,两者共存也是合理选择,Zabbix管底层基础设施,Prometheus管应用层与容器环境。
问:服务器运维管理系统有免费的可靠选择吗?
答:有,Prometheus、Grafana、Ansible、JumpServer都是成熟的开源项目,广泛应用于生产环境,其可靠性并不因免费而打折扣,反而因为社区活跃、迭代速度快,很多场景甚至领先商业产品,需要付出的主要是学习时间和维护精力,确实不想费劲折腾,也可以考虑Grafana Cloud的免费额度,对于小规模监控场景完全够用。
问:如何让领导同意采购商业运维系统?
答:可以从审计合规风险和数据安全角度切入,如果业务涉及用户隐私数据,一旦出现运维误操作导致数据泄露,面临的罚款与声誉损失远高于运维系统采购成本,数字画像通常是先明确当前人力在救火上消耗的时间占比,再说明自动化系统能回填多少运维开发时间,商业系统节省的往往正是最稀缺的高级工程师时间。
服务器运维系统的核心价值在于把被动救火转变成主动预防,监控、自动化、堡垒机三者形成闭环,才算构建起合格的基础运维体系,基础设施的稳定性,终究是业务增长最坚实的底座。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/700315.html