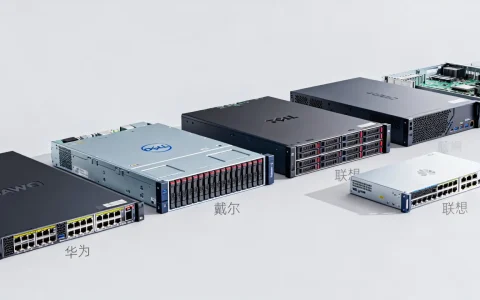
顶级超算服务器并不是一台单独的电脑,而是一整套为超高并行计算任务打造的集群系统,目前全球市场上最顶尖的玩家主要是IBM、HPE、戴尔、浪潮、联想和中科曙光这几家。
顶级超算服务器有哪些代表性产品线?
要搞清这个问题,先得明白“顶级”这个词在超算领域有两条路线:一条是跑Linpack基准测试冲排名的巨型集群,另一条是面向商业用户、能买得到的高性能计算节点,后者才是大多数人能接触到的“顶级超算服务器”。


国际品牌的商用超算主力机型
HPE的Cray EX系列是目前很多国家级超算中心的底座,比如美国橡树岭实验室的Frontier就用了这套架构,它的强项在Slingshot互联技术,能把几万个节点像一台机器一样协同工作,IBM这边,Power System AC922曾经是Summit和Sierra的核心,CPU和GPU之间用NVLink高速直连,适合AI混合推理,戴尔的PowerEdge XE系列则更接地气,机架级设计,散热和能耗控制做得很成熟,不少企业自建超算的首选就是它。
国内品牌的顶级超算代表
浪潮的TS860和SX系列在国内互联网大厂和科研院所出镜率很高,尤其是冷板式液冷方案,能把PUE压到1.1以下,联想的深腾系列继承了ThinkSystem的可靠性,在气象局和石油勘探行业口碑不错,中科曙光的星云系列则是国产自主架构的旗帜,基于海光或申威处理器,在政府主导的超算中心几乎成了标配。
这些机器的共同特征
顶级超算服务器和普通服务器最大的区别,不是单颗CPU多快,而是扩展能力和带宽,内存带宽、PCIe通道数、节点间互联速率,每一项都是为“几千个核心同时算一道题”设计的,你用普通服务器组集群,跑一百个节点就可能网络拥塞,但顶级超算能做到上万节点线性扩展。
顶级超算服务器配置到底怎么选?
很多人以为直接买最贵的零件堆上去就行,结果预算烧完,性能却跑不出来,配置的关键在于“瓶颈匹配”。
计算芯片:CPU还是GPU优先?
从实际应用场景看,纯科学计算(如分子动力学、天气预报)更吃CPU主频和AVX512指令集,Intel Xeon Max系列或AMD EPYC Milan-X是主流选择,而深度学习训练、CAE仿真这类并行度极高的负载,GPU才是核心。
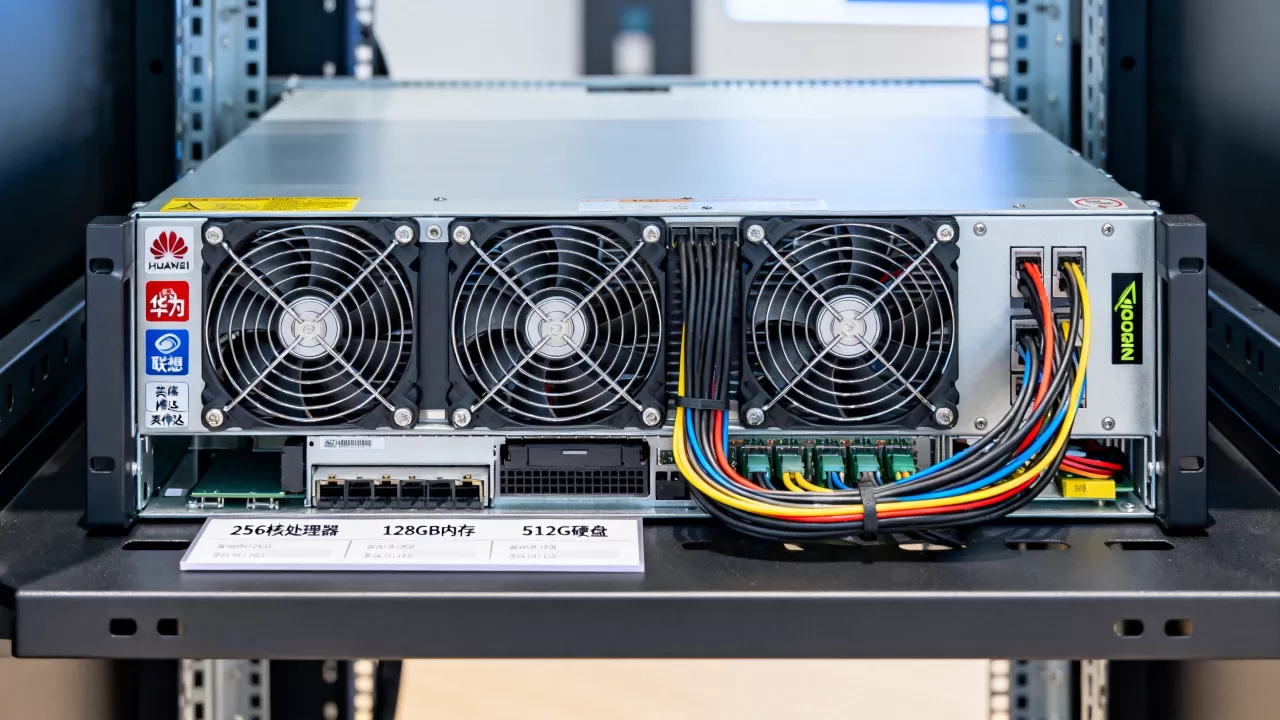
一个顶级超算节点通常配2颗CPU加4到8张加速卡,比如H100或MI300系列,如果预算有限,优先保GPU,CPU选中端即可。
互联网络:容易被忽略的大件
InfiniBand NDR 400Gb/s是目前商用超算的标配,HPE的Slingshot和华为的CloudEngine则走的是以太网增强路线,这一块的开销往往占整机成本的20%到30%,行业共识认为,网络延迟超过2微秒,一万核以上的作业效率就会急剧下降,所以别只在CPU和GPU上花钱。
存储分层别偷懒
顶级超算必须配三级存储:闪存盘做突发写入缓存,并行文件系统(比如Lustre或BeeGFS)做热数据存取,大容量HDD做归档。I/O瓶颈比计算瓶颈更容易翻车,很多实测案例显示,同样的计算代码,换一套存储架构,整体跑完时间能缩短一半。
顶级超算服务器价格大概多少钱?
这是所有人最关心的问题,可惜没有固定答案,一台入门级的小规模超算(32节点双路CPU加4张GPU卡)大约需要200万到500万人民币,而真正能进全球TOP500的集群,造价通常按亿元计。
影响价格的因素
- 节点数量:每增加一个节点,不只是加一份硬件,网络交换机和布线成本会非线性上涨。
- 液冷系统:风冷机柜每千瓦散热成本很低,但顶级配置功耗动辄30千瓦以上,必须上液冷,这部分改造费用可能占到总价的15%。
- 软件生态:编译器、调度器、数学库的授权费常常被忽略,一个Slurm调度器本身免费,但商业版MPI和性能调优服务收费不菲。
租赁模式反而更划算
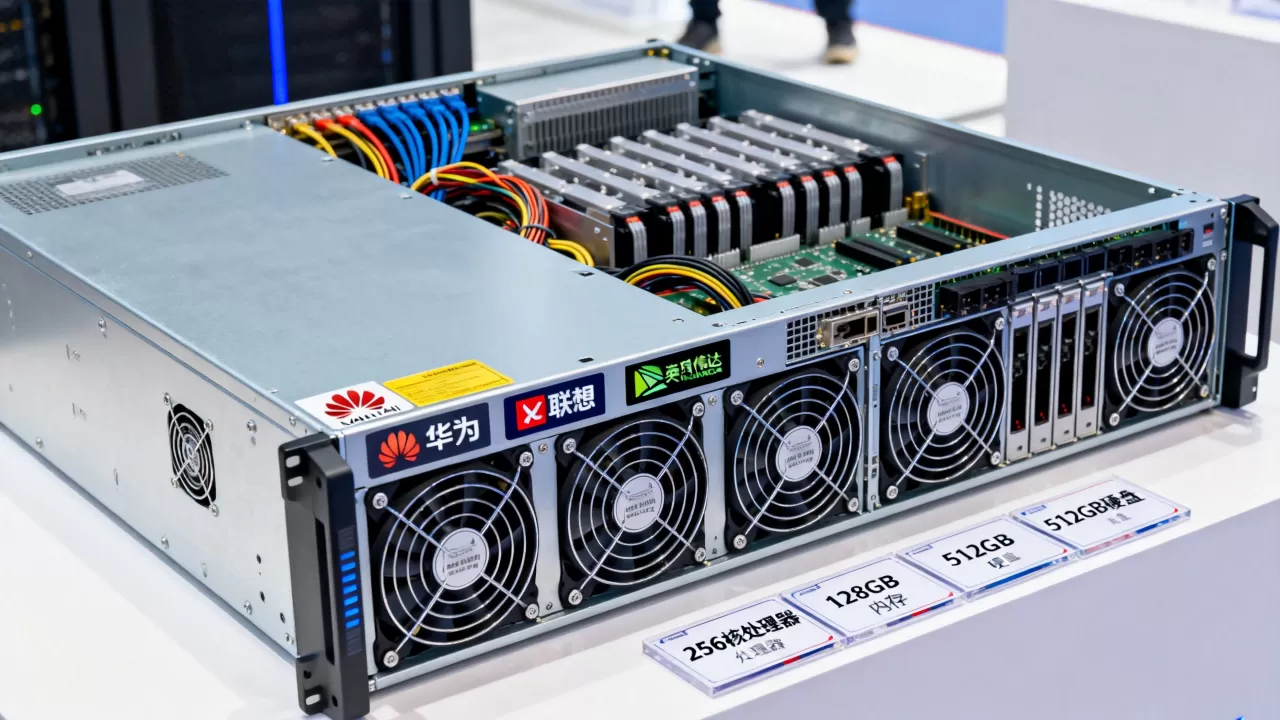
对于预算不足又需要顶级算力的团队,现在主流是租用超算云服务器,简米云、华为云都有弹性高性能计算实例,按核时计费,一块钱能买到几十个核时,如果你只是偶尔跑一次百万核级的作业,租比买便宜一个数量级。
怎么评估一套顶级超算服务器值不值?
别只看峰值算力,要看持续性能,Linpack跑分是营销用的,实际场景中你的代码能用到多少浮点运算能力才是关键,建议做三件事:
第一步:跑微基准测试
用HPL(High Performance Linpack)和HPCG(High Performance Conjugate Gradient)跑小规模测试,HPL成绩好不代表内存密集型应用强,HPCG更贴近真实的大规模稀疏矩阵运算。
第二步:看节点间的实际带宽
用MPI的osu_latency和osu_bw工具测一下点对点延迟和带宽,如果双向带宽低于理论值的80%,说明网络拓扑或驱动配置有问题,直接让供应商调优。
第三步:压测你的真实工作负载
把生产环境里最耗时的那个计算任务放上去,记录完整运行时间,业内专家指出,很多超算项目验收时用的是优化过的基准程序,实际业务性能往往只有标称的50%到70%,所以自己的压测结果最可信。
国产超算服务器能比肩国际顶级吗?
近几年国产超算服务器在硬件规格上已经追得很紧,中科曙光基于海光三号的整机柜方案,单集群能扩展到数千节点,液冷技术甚至走在了前面,华为的Atlas超级节点用昇腾910B做AI训练,在互联网大厂内部已经大规模部署,不过短板依然存在:软件生态和互联芯片,InfiniBand目前主要靠NVIDIA收购的Mellanox,国产的交换芯片还难以支撑十万节点级别的超大规模集群,如果业务场景涉及自主可控要求,国产方案值得选,但要有适配投入的心理准备。
顶级超算服务器和普通服务器到底差在哪?
直观对比一下:
| 维度 | 普通服务器 | 顶级超算服务器 |
|---|---|---|
| 单节点核心数 | 32-128 | 128-512 |
| 内存带宽 | 200-400GB/s | 1TB/s以上 |
| 节点互联 | 千兆/万兆以太网 | InfiniBand 400Gb/s |
|
典型故障率 | 年约2% | 年约0.5%(冗余设计) |
| 管理方式 | 单机或集群 | 统一调度系统(Slurm/LSF) |
| 适用场景 | Web服务、数据库 | 科研计算、AI训练、仿真模拟 |
从这表里能看出来,顶级超算牺牲了单机性价比,换来了极致的并行效率,普通服务器组一百个节点,跑MPI程序可能还没单机快;超算服务器跑一千个节点,性能基本线性增长。
顶级超算服务器用什么操作系统?
几乎清一色的Linux,CentOS 7虽然停维护了,但大量超算中心还停在上面,因为数学库和编译器全绑定了旧版本,现在新装机更倾向Rocky Linux或Ubuntu Server 22.04 LTS,你要熟练用命令行工具,比如module load加载环境,sbatch提交作业,图形界面在这里毫无意义。
常见疑问解答
顶级超算服务器能用来挖矿吗?
不能,超算架构追求的是大规模协处理器并行,挖矿则需要高单核整数运算,用超算挖矿,功耗和成本远超收益,而且大多数超算集群的内网与外网隔离,根本接触不到矿池。
小公司买一台顶级超算服务器需要什么条件?
除了预算,还要有专用的机房环境:稳定的双路电、工业级空调或液冷管路、抗震机柜,很多企业买回来发现性能不达标,其实是机房散热跟不上导致降频,如果没这些条件,强烈建议租用云超算。
顶级超算服务器的使用寿命是多久?
硬件生命周期一般在5年左右,但实际服役时间常超过8年,全球顶尖超算的淘汰标准不是坏了,而是“算力跟不上新算法需求”,维护重点是换硬盘和清洗冷板,CPU和内存几乎不会坏。
顶级超算服务器是硬核科学研究和高端工业设计的“基建”,选型时别迷信参数表,多从实际负载和生态环境出发,预算充足选国际一线,追求自主可控选国内头部,小规模需求直接租云超算。能解决你问题的那套配置,就是最好的顶级超算服务器。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/705012.html