临床队列研究数据清洗的批处理资源规划,核心是算清数据体量、清洗规则复杂度和时效要求,再按“峰值预留、弹性调度、分层存储”原则分配CPU、内存、存储和网络。
临床队列研究的数据清洗,往往不是“跑个脚本”那么简单,一个多中心回顾性队列,可能涉及几万受试者、上千个变量、几十条逻辑核查规则,还要做术语映射、单位统一、时间窗计算,批处理资源规划不到位,轻则夜间任务跑不完,重则内存溢出、磁盘写满,第二天研究者拿不到干净数据,下面从负载估算、实操路径、场景配置、成本优化几个角度拆解。


先算清楚:临床队列数据清洗的批处理负载从哪里来
临床队列数据通常来自EDC系统、医院HIS、LIS、PACS、随访平台,清洗任务包括缺失值处理、逻辑核查、离群值检测、单位换算、诊断编码映射(ICD-10、MedDRA)、受试者去重、访视时间窗计算,这些任务对资源的需求差异很大。
- CPU密集型:规则引擎逐行匹配、字符串模糊匹配、正则表达式清洗、诊断编码映射。
- 内存密集型:大表连接、去重、排序、分组聚合,一个包含500个变量、10万行记录的数据框,加载到Pandas可能占用数GB内存。
- I/O密集型:读写CSV、Excel、SAS、Parquet文件;多中心数据同步;中间结果落盘。
- 网络密集型:多中心数据汇总、云上对象存储读写、远程数据库查询。
临床队列研究数据清洗需要多少计算资源?先搞清三个变量
并发任务数。 按中心、按受试者、按数据域拆分任务,能并行多少,直接决定CPU核数需求。
单任务数据量。 最大单表行数乘以变量数,估算内存占用,经验上,Pandas处理时内存约为原始CSV的3到5倍。
规则引擎效率。 用纯Python循环还是向量化操作,用单机Pandas还是Spark SQL,性能差距可能达到数量级。
业内常见做法是:小型队列(数千受试者、变量数少于200)用16核64G单机;中型队列(1到5万受试者、变量数200到1000)建议32到64核、128到256G内存;大型多中心队列或含影像、组学数据时,考虑分布式集群,据国家卫健委医院信息化相关标准,临床科研数据应在院内完成脱敏和清洗,这意味着资源规划还要兼顾安全合规。
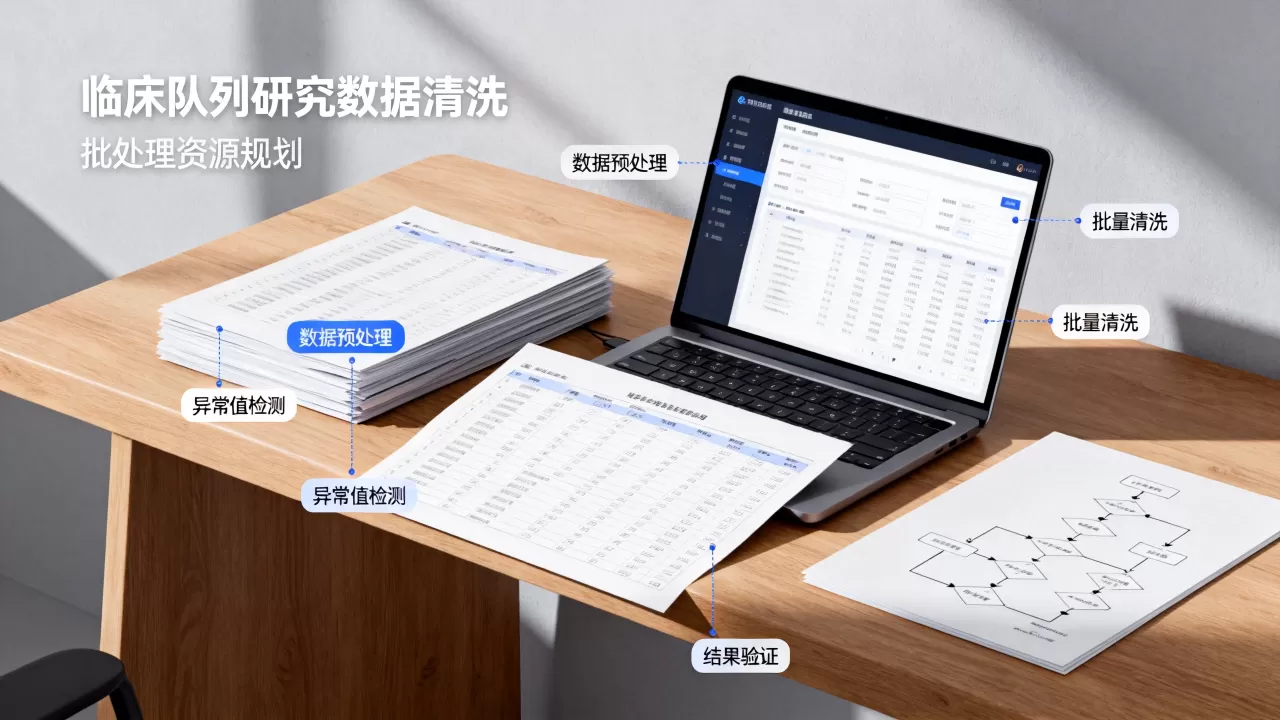
批处理资源规划的四步实操路径
第一步:把清洗流程拆成可并行的任务单元
不要写一个巨型脚本从头跑到尾,按受试者ID范围、中心编号、数据域(人口学、检验、用药、随访)拆成独立任务,工具可选Snakemake、Nextflow、Airflow,或者简单的GNU Parallel。
# 示例:按中心拆分任务并并行
ls centers/.csv | parallel -j 8 'python clean_center.py {}'
Nextflow示例:
nextflow run clean_cohort.nf -profile slurm -resume
拆分后,每个任务内存可控,失败可重试,整体吞吐量提升。
第二步:选择计算环境本地服务器和云平台做临床数据清洗哪个更划算?
这是很多团队纠结的问题,从数据安全看,涉及患者隐私的原始数据,本地服务器或院内私有云更稳妥,从弹性看,云平台适合突发的大规模批处理,但网络传输和合规成本不低。
| 对比维度 | 本地物理服务器 | 云虚拟机/容器 | 院内HPC集群 |
|---|---|---|---|
| 初始投入 | 较高,需采购硬件 | 按需付费,无硬件折旧 | 较高,共享资源 |
| 弹性扩展 | 差,受限于硬件 | 好,可快速扩缩容 | 中等,受队列限制 |
| 数据安全 | 高,数据不出院 | 需评估合规,加密传输 | 高,院内网络 |
| 运维成本 | 需专人维护 | 云厂商负责底层 | 需专业运维 |
| 适合场景 | 稳定、长期、敏感数据 | 短期、峰值、非敏感数据 | 多课题组共享 |
临床队列数据清洗批处理服务器租用价格受哪些因素影响? 地域、核数、内存、存储类型、计费方式都会影响,华东、华南节点通常比西部节点略高;按需实例比包年包月贵;SSD存储比HDD贵,如果只是夜间跑批,可以选用抢占式实例或定时启停,成本能降下来,具体价格建议直接查云厂商定价页,用“按量付费+定时销毁”策略控制预算。
第三步:存储与I/O规划别让磁盘拖慢批处理
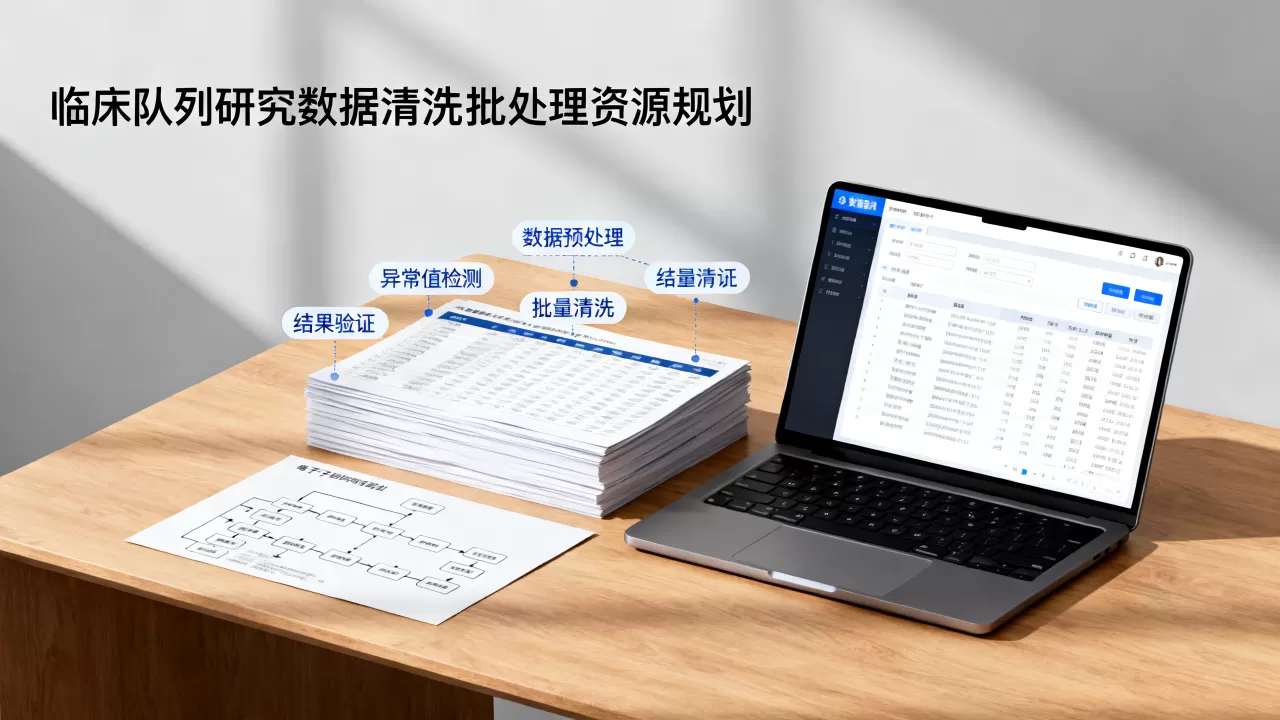
- 原始数据:保留在只读存储,如对象存储或NAS,打标签、加校验和。
- 中间结果:放在本地SSD或高性能云盘,任务结束后清理。
- 清洗后数据集:用列式格式Parquet或Feather,比CSV节省空间,读取更快。
- 多中心同步:用rsync、rclone或专线,避免批处理时临时拉取大文件。
# 将CSV转为Parquet,减少I/O压力
python -c "import pandas as pd; df=pd.read_csv('raw.csv'); df.to_parquet('raw.parquet')"
第四步:调度、监控与容错
- 调度器:Slurm、PBS、Kubernetes Job、Airflow。
- 监控:Prometheus + Grafana看CPU、内存、磁盘IO;每个任务输出规则命中数、耗时。
- 容错:设置重试次数,记录失败任务ID,支持断点续跑。
- 夜间窗口:多数医院批处理在凌晨2点到6点,要预留峰值资源,避免和HIS备份冲突。
三甲医院临床科研数据清洗批处理实战:一个典型场景的资源分配
某三甲医院做回顾性队列,纳入近5年3万名住院患者,变量约800个,涵盖检验、影像报告、病理、用药,清洗规则包括缺失率过高的变量剔除、逻辑矛盾标记、诊断编码映射、重复入院去重。
资源分配如下:
- 计算节点:1台物理服务器,32核,128G内存,2TB SSD。
- 数据库:PostgreSQL存储结构化数据,用dblink或FDW连接HIS只读库。
- 批处理脚本:Python Pandas分块读取,每块5万行,并行4个进程。
- 调度:crontab每晚2点触发,预计4小时内完成。
- 关键命令:
python clean_cohort.py --chunk-size 50000 --n-jobs 4 --output parquet
如果数据量继续增长,比如加入影像组学特征或全基因组数据,单机内存会成瓶颈,此时可迁移到Spark on YARN或Kubernetes集群,用分布式DataFrame做连接和聚合,行业共识认为,先垂直扩展再水平扩展,能避免过早引入分布式复杂度。
成本与资源优化:临床队列数据清洗批处理资源规划中的常见坑
坑一:内存溢出。 一次性加载全部数据,Pandas直接OOM,解决:分块读取、只选必要列、用category类型压缩字符串。
坑二:规则重复计算。 每条规则单独扫描全表,I/O浪费严重,解决:合并规则,一次遍历完成多项核查。
坑三:存储瓶颈。 中间结果反复读写HDD,任务卡在磁盘,解决:中间文件放SSD,用Parquet列式存储。
坑四:网络延迟。 多中心数据实时拉取,拖慢批处理,解决:提前同步到本地缓存,批处理只读本地。
坑五:许可费用。 商业统计软件按核收费,批处理集群核数多,成本飙升,解决:评估开源替代,如R、Python、Julia。
成本构成大致包括:硬件折旧或云资源费、存储费、网络费、人力运维费、软件许可费,据工信部相关产业报告,医疗信息化投入中,数据治理和科研平台占比逐年上升,规划时,建议先跑一个10%样本的预实验,记录峰值CPU、内存、磁盘IO,再线性放大到全量,这个办法比拍脑袋估算靠谱得多。
Q&A:临床队列研究数据清洗批处理资源规划常见问题
问题1:临床队列数据清洗一定要用分布式计算吗?
不一定,多数单中心回顾性队列,数据量在几十GB以内,单台高配服务器足够,只有多中心、多组学、影像数据达到TB级,或者需要小时级完成时,才考虑分布式,业内专家指出,分布式带来的运维和调试成本,往往超过其性能收益。
问题2:临床数据清洗批处理放在夜间跑,资源怎么预留?
按历史峰值上浮一定比例预留,同时设置弹性队列,比如独占物理机,或云上保留实例加抢占式实例,监控实际使用率,连续观察两周再调整,如果任务经常超时,优先优化规则和I/O,而不是盲目加核。
问题3:临床队列研究数据清洗需要多少计算资源?有没有快速估算公式?
可以用这个公式粗估内存:最大单表行数 × 变量数 × 每单元格字节数 × 并行分块数 × 安全系数,更简单的办法是:先跑10%样本,用/usr/bin/time -v或Python的memory_profiler记录峰值内存,再乘以10,留出20%到30%余量,CPU核数则按可并行任务数乘以每任务核数来定,最终资源是否够用,以实际批处理窗口内能否稳定完成为准。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/707332.html