在服务器上查看一整天的日志,核心就一句话:先把时间边界定准,再用grep、sed或awk把对应时间段的日志行切出来。 实际操作里,日志文件位置、日志格式、时区偏差都会影响结果,下面分场景拆开讲。
Linux服务器查看一整天的日志命令怎么组合?
服务器日志不像人写日记那样规规矩矩按天归档,多数情况是一个文件里连续写,所以查“一整天”不是找文件,而是定一个时间窗口,把窗口内的内容捞出来。
先确认日志文件在哪
不同应用、不同发行版,日志位置差别不小,常用路径包括:
/var/log/messages或/var/log/syslog:系统级日志,Debian系和CentOS系的通用入口。/var/log/nginx/access.log:Nginx访问日志。/var/log/tomcat/catalina.out:Tomcat容器运行日志。- 应用自定义路径:比如Java微服务常写到
/home/app/logs/下,按天滚动生成app-2026-05-20.log这种格式。
如果拿不准路径,先执行ls -lh /var/log/看看哪些文件比较大,日志量大的文件通常就是目标,也可以用find / -name ".log" -mtime -1在今天修改过的日志文件里找。
服务器时间先校准,否则“一天”会偏
这一步容易被忽略,服务器时间和本地电脑时间不一致时,你查到的“可能不是真正的今天。
查看服务器当前时间:
date
如果发现时间不对,先通过ntp同步:
ntpdate -u ntp.aliyun.com
同步完再查日志,时间段才靠谱。时区偏差是排查全天日志时最常见的隐形坑。
三个基础命令组合用法
假设日志文件是/var/log/app/order.log,要查2026-04-15凌晨0点到23点59分的内容:
用grep直接匹配日期字符串
grep "2026-04-15" /var/log/app/order.log
用sed按起止行切分
sed -n '/2026-04-15 00:00/,/2026-04-15 23:59/p' /var/log/app/order.log
用awk做条件过滤,兼容时间精度差异
awk '/2026-04-15 00:/,/2026-04-15 23:/' /var/log/app/order.log
grep适合快速看总量,sed和awk适合做边界切割,推荐优先掌握后两个。
一天日志怎么切:sed和awk的实际用法
工具本身不难,难点在边界处理,一个日志文件往往跨越多天,跨天时段的数据最容易漏查或重复。
sed按时间段精确切分
sed是按“行号范围”或“字符串范围”处理文本的。
sed -n '/2026-04-15 00:00:00/,/2026-04-16 00:00:00/p' /var/log/app/order.log
这个命令会把从2026-04-15 00:00:00出现的那一行开始,一直输出到2026-04-16 00:00:00。
注意:如果日志里某个时刻恰好没有请求,那么这一行的匹配位置可能偏移,导致切片不精确,多数情况下误差可接受,但要求严格时建议配合head或tail手动校准首尾。
awk处理多条件时间过滤
awk比sed更灵活,能对字段级别做处理。
awk '/2026-04-15 00:00:00/,/2026-04-16 00:00:00/' /var/log/app/order.log
如果想在切分后顺手统计某个接口的访问量,可以写成:
awk '/2026-04-15/ && /order/submit/ {count++} END {print count}' /var/log/app/order.log
把切分和统计合并到一条命令,排查效率高不少。
跨天日志的切割技巧
日志文件按天滚动时,当天的完整数据可能不在一个文件里,比如catalina.out是单文件追加模式,昨天23:50的日志和今天00:10的日志挨在一起。
这种情况建议分两步:
grep "2026-04-15" /var/log/app/order.log > /tmp/day_start.txt
grep "2026-04-16" /var/log/app/order.log >> /tmp/day_start.txt
先取前一天所有内容,再取后一天内容,合并后就是跨天窗口的完整数据。把时间边界交给grep,把内容提取交给重定向,逻辑最清晰。
Java应用一天日志怎么查:从catalina.out里定位问题
Java应用日志的典型特点是:一个进程运行时往同一个文件写日志,涉及堆栈信息时一个异常可能打印几十行,而且行首带时间戳。
先定位业务日志位置
Spring Boot项目常见的日志路径:
logs/spring.loglogs/error.log- 或者通过
logging.file.path自定义的目录
老式Tomcat部署的应用,主要看/usr/local/tomcat/logs/catalina.out,这个文件记录了stdout输出,包括异常堆栈。
按时间段切出一天内容
假设要查2026-04-15全天的业务异常日志:
sed -n '/2026-04-15 00:00:00/,/2026-04-16 00:00:00/p' logs/spring.log | grep -n "ERROR"
加-n保留行号,方便后续回到原文件定位上下文,如果堆栈信息被切断了,可以用-A 20带上后续20行:
grep -A 20 "2026-04-15 02:31:12.456 ERROR" logs/spring.log
大日志文件的内存风险
Java应用日志一天可能超过1GB,直接grep整个文件,内存占用会飙升,稳妥做法是先切片再分析:
awk '/2026-04-15 00:00:00/,/2026-04-16 00:00:00/' logs/spring.log > /tmp/spring-0415.log
转存成独立文件后,再用编辑器或less细读,避免一遍遍扫大文件。
日志量特别大时,服务器日志分析怎么提速?
凌晨批量任务、双十一大促这类场景下,一天日志可能上亿行,单纯grep会等得人怀疑人生。
先检查文件大小,决定策略
ls -lh /var/log/app/order.log
文件超过2GB,建议先切割再搜索,而不是反复全文件扫描,切割命令:
head -n 5000000 /var/log/app/order.log > /tmp/top5m.log
配合wc -l先看总行数,估算目标时间段大致占比,再决定切多少行。
用zgrep处理已压缩的历史日志
大多数服务器日志会配置logrotate自动压缩,压缩后的文件形式是order.log.1.gz。
查看压缩包里的日期分布:
zgrep "2026-04-15" /var/log/app/order.log.1.gz | head -n 20
zgrep可以直接穿透gzip压缩文件,不需要先解压。这个命令在磁盘空间紧张时尤其好用。
两百行以内的日志用less直接翻
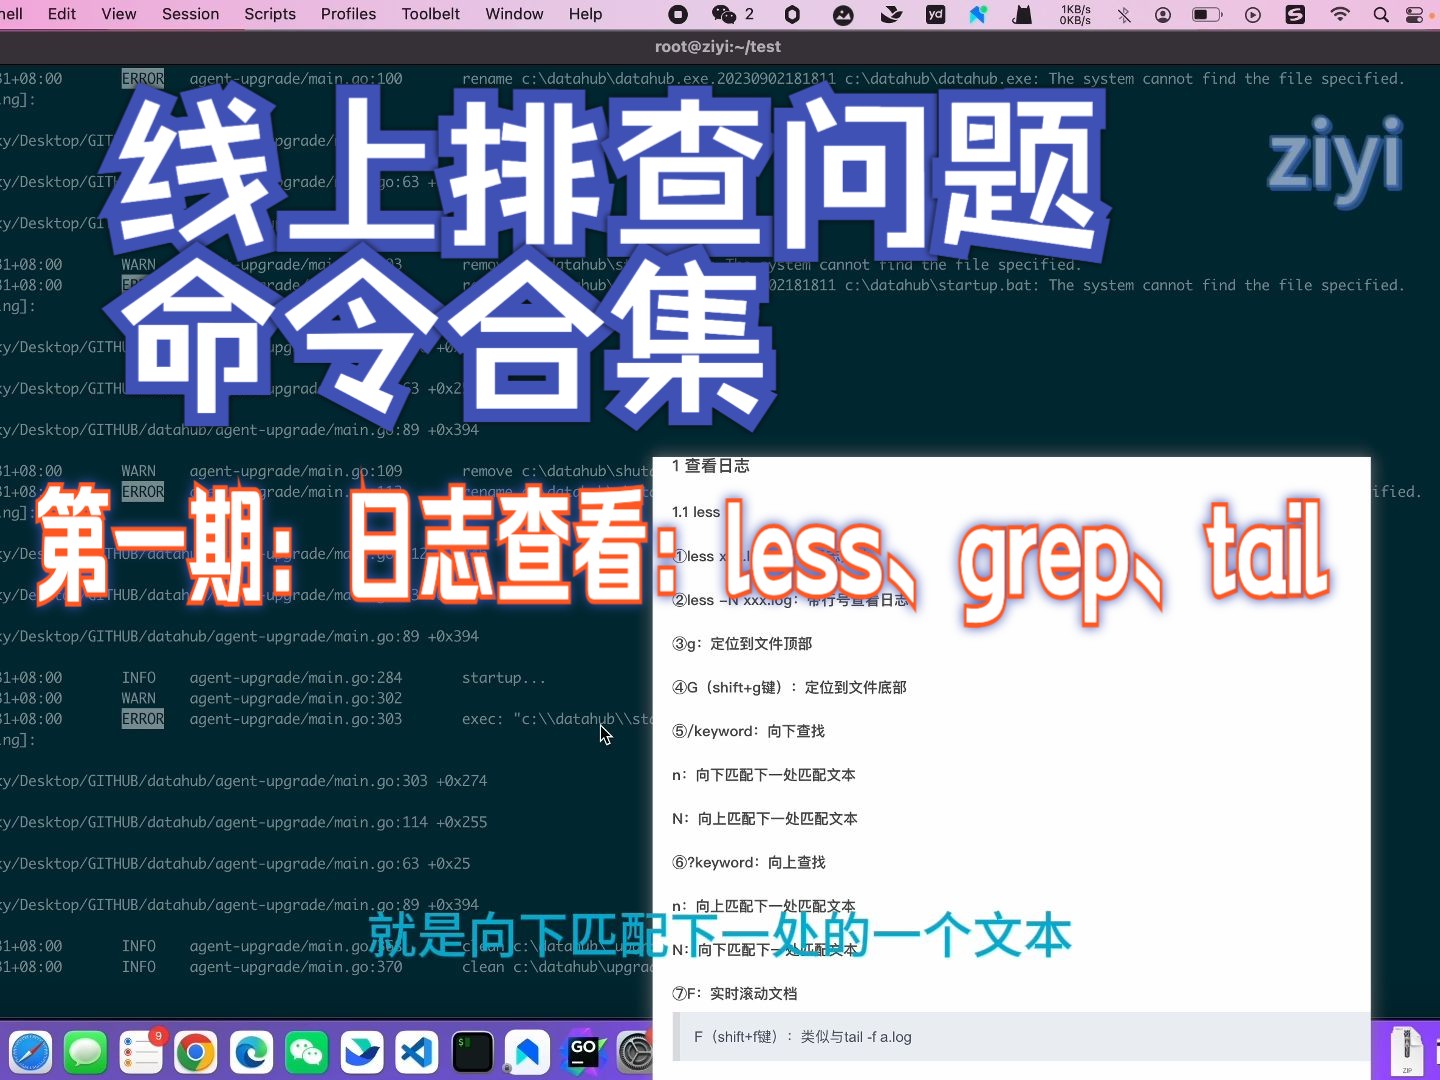
其实很多“查一整天日志”的需求,最后只是确认某一两笔订单的完整链路,这种情况less + 时间字符串搜索就够了:
less /var/log/app/order.log
进入less后输入/2026-04-15 14:23回车,直接跳到目标时间点。
日志平台是升级选项
如果每天都花大把时间在服务器上grep日志,说明该考虑集中式日志平台了,行业共识认为,日志量达到单机grep耗时超过分钟级时,引入日志采集组件是合理选择,先本地切分再传输仍然是最快的临时方案,不依赖额外组件。轻量场景用命令行,重场景上平台,两者不冲突。
日志排查一天内容时最容易忽略的三个细节
日志时间的乱序问题
服务器日志不完全是按时间顺序写入的,多线程并发场景下,A线程先打印了14:00的日志,B线程后打印13:59的日志,文件里就会出现时间倒挂。
业内专家指出,遇到时间乱序时,先按行号顺序切分时间段,再按时间戳二次排序,这才是标准做法,直接grep容易混入其他日期的内容。
日志滚动切割的边界点
logrotate默认可能在每天凌晨切割日志,也可能在应用重启时切割,还有的是按文件大小触发,切割时机不同,“一整天”的边界就不同。
cat /etc/logrotate.d/nginx
查看具体的切割规则,确认凌晨切割还是中午切割,能帮你判断需不需要合并两个文件。
时区偏差影响“全天”判断
日志时间戳显示的是服务器本地时间还是UTC,直接影响切分结果,查看日志文件头部,确认时间戳格式,再比对date输出,两者偏差超过1小时,就需要考虑时区转换了。
查一整天的日志,本质是在一堆乱序文本里精确划定时间边界,工具只是手段。 先把文件位置、时间基准、切割规则三个基础对齐,后续无论用grep、awk还是日志平台,结果都经得起复核。
服务器日志查看常见问题:时间、大小和时区
sed查跨天日志时为什么总缺行?
跨天匹配时,如果起始字符串在当天日志中不存在,sed会一直匹配到文件末尾,比如你写/2026-04-15 00:00:00/,但当天第一条日志是00:00:01,起始点落空,整个切片就跳过了,解决方法是先查日志头几行,确认首条日志的准确时间格式,再写匹配条件。
日志文件超过几个G,想查某一天内容,最快的方式是什么?
先用ls -lh确认大小,再用head和tail从两端估算目标时间段在文件中的位置,配合sed -n /起始/,/结束/p切分到临时文件,如果日志已经按天滚动并压缩,直接用zgrep查对应日期的压缩包,不需要全量展开,最忌讳的就是反复对全文件执行grep,内存和磁盘IO都会被拖垮。
一个日志文件里混着多个应用的时候怎么区分?
看日志行格式,标准logback或log4j2输出通常包含[应用名]前缀或包名,比如[order-service] INFO ...,用awk按字段匹配应用名,先切出指定应用的日志,再按时间范围过滤,没有统一前缀时,只能按线程名或关键业务字段区分,比如订单号、用户ID,日志格式规范,排查效率直接翻倍。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/709465.html