服务器端读写的完整链路,是从网卡中断开始,经过内核协议栈、socket缓冲区、应用层读写系统调用、文件系统或数据库引擎,最终落到磁盘或返回给客户端。
服务器端读写经过哪些核心环节?
很多新手把“服务器端读写”想象成“程序嘴里叼着数据跑到硬盘上”,其实没那么简单,一次标准的读写,至少要穿过硬件、内核、应用三层,每一层都有排队、拷贝和状态切换。


以最常见的TCP服务为例,读写路径大致长这样:
- 网卡收到数据后,通过DMA直接把包放进内核环形缓冲区,然后触发中断告诉CPU“有货到了”。
- 内核协议栈(TCP/IP)把包拆出来,做校验、排序、去重,最后挂到对应socket的接收队列。
- 应用进程调用read()系统调用,CPU从用户态切到内核态,把socket接收队列里的数据拷贝到用户态缓冲区。
- 如果读的是磁盘文件,内核还要经过虚拟文件系统层,查目录项和inode,从页缓存page cache里找数据,没命中就继续走块设备层,让磁盘控制器实际读扇区。
- 写操作反过来:应用调用write(),数据从用户态拷贝到内核态,写入socket发送缓冲区,或写入文件页缓存;之后内核再异步把脏页刷到磁盘,或通过网卡把数据发出去。
这一步一步走下来,到处都是时间开销。上下文切换和内存拷贝正是读写延迟的主要来源,这已经是行业共识。
从网卡到内核:数据是先敲门还是直接推门?
老式网卡是“敲门式”的:每来一个包,就打断CPU一次,CPU放下手里的活来处理,包一多,CPU光顾着敲门了,所以现代服务器大多用NAPI机制网卡先把一批包收进环形队列,攒一攒,让CPU一次处理完,这就像快递员不一个个按门铃,而是把包裹堆门口,等你一起签收。
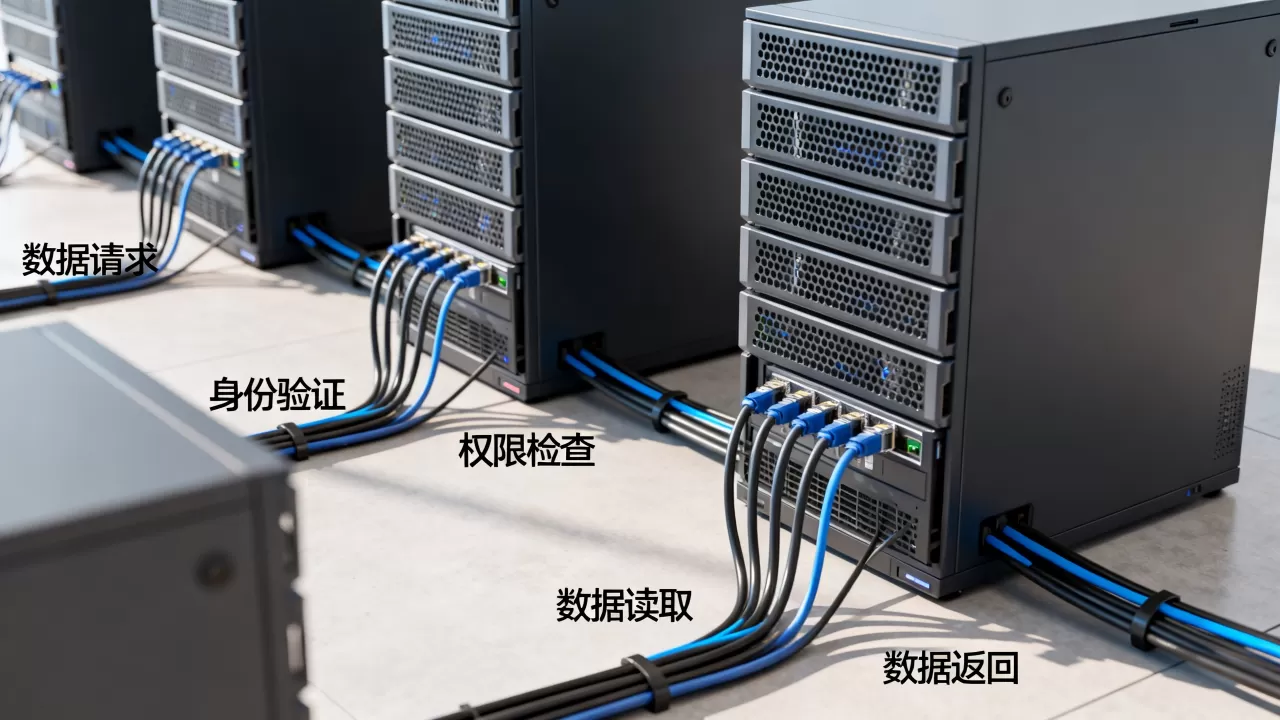
进到内核之后,协议栈要干几件事:拆掉以太网头、IP头、TCP头,按五元组找到对应的socket,这一步涉及哈希查表,所以连接越多,查找越慢,业内专家指出,高并发场景下,连接数上到几十万后,瓶颈往往不是内存,而是hash桶的冲突率和锁竞争。
socket缓冲区:双方交换数据的“信箱”
每个socket都有自己的接收缓冲区和发送缓冲区,内核把数据放进接收缓冲区,你的read()就是从这儿取;你的write()是先把数据放进发送缓冲区,内核再负责后续的流量控制和重传。
缓冲区大小直接决定读写表现的“脾气”。接收缓冲区太小,内核收到TCP包但放不下,只能丢弃,让客户端重传;发送缓冲区太小,write()会阻塞,应用层速度立刻掉下来,可以用ss -lnt查看当前socket的队列深度,或者用sysctl net.ipv4.tcp_rmem看默认值。
服务器端读写操作流程:应用层到底在忙什么?
了解了内核的桥,我们再看看应用层,读写操作看似是两个函数的事,实际上背后有一段完整的过关流程。
读操作:从read()到数据返回
假设你用Nginx读一个本地文件,然后发给浏览器,内部大致是:
- 应用进程调用read(),进入内核态。
- 内核在page cache里找这个文件的缓存页,如果命中,直接把页数据拷贝到用户态缓冲区,一次拷贝搞定。
- 如果没命中,内核先做异步回写之前的脏页,然后向块设备层发送读请求,睡眠等待磁盘把数据读入内存。
- 磁盘控制器把数据搬到内存后,中断唤醒内核进程,再把页缓存里的数据拷贝到用户态。
这里有个关键点:
读操作不一定真的读磁盘,只要页缓存命中,速度和读内存差不多,所以Redis和MySQL把热数据放在内存里,目的就是抬高命中率。
写操作:write()之后的“异步黑盒”
写操作比读更“阴险”,你调用write(),数据被拷贝到内核页缓存,函数就返回了,内核并不会立刻把数据写到磁盘,而是等一个叫flusher的线程在后台把脏页批量刷出去。
这种设计叫write-back,好处是写操作可以很快,坏处是突然断电时数据容易丢,所以数据库这类重视可靠性的程序,会主动调用fsync()强制刷盘,或者用预写日志WAL先把操作记录写到专门的日志文件里,MySQL的innodb_flush_log_at_trx_commit参数,就是在性能和数据安全之间做取舍。
服务器端读写性能优化:瓶颈在哪里卡住?
很多团队优化半天,最后发现问题不在代码,而在数据从网卡到磁盘的某条路上被堵住了,排查时有一条顺口溜:“先看拷贝,再看锁,最后才怪网卡”。
减少数据拷贝:零拷贝如何省下功夫
传统读文件的路径要经过四次拷贝(网卡→内核缓冲区→用户态→socket发送缓冲区→网卡),CPU还得来回切换,零拷贝技术,比如sendfile()或mmap(),让数据在内核态直接流转,用户态根本不沾手,Nginx开启sendfile on;就是干这个。一次零拷贝能省下两次左右的上下文切换,对于大文件传输效率提升非常明显。
用好内核参数:别让缓冲区拖后腿
- 调大
net.core.rmem_max和net.core.wmem_max,允许更大的socket缓冲区。 - 开启
tcp_nodelay,禁用Nagle算法,降低小包延迟。 - 对于长连接请求,用
tcp_tw_reuse优化TIME_WAIT,但tcp_tw_recycle
在NAT环境下会出问题,现在已经不推荐开了。
从硬件找突破口:SSD和网卡卸载
磁盘换代是最直接的提速,从机械盘换成NVMe SSD,随机读写延迟大致能降低一个数量级,网卡也有门道支持RSS或协处理器卸载的网卡,可以把校验和、分片、甚至TCP/IP处理直接放在网卡上做,让CPU腾出手,跑百万并发架构的机器,优先选这类高档网卡。
说到底,服务器端读写没有魔法,无非是网卡收包、内核转发、应用拷贝、磁盘落盘这几件事,掌握这条路径,你就知道瓶颈会出现在哪里,优化也就有了方向。
关于服务器端读写路径的常见疑问
问:服务器端读写经过哪些步骤?为什么Redis比MySQL快?
同样是“读一个key”,Redis的路径简单:客户端→网络→Redis进程内哈希表→返回,全程内存,没有磁盘操作,也没有复杂的查询解析,MySQL走的是:客户端→网络→连接线程→解析SQL→事务引擎→InnoDB缓冲池→磁盘(可能)→返回,多出来的每一步都是延迟之源。
问:服务器端读写操作流程中,同步IO和异步IO有什么区别?
同步IO下,应用调用read()后必须等数据就绪才继续走,过程像排队交钱;异步IO里,应用发完请求立刻做别的事,内核等数据准备好了再通知你拿,像外卖下单后不用站在窗口等,高性能服务器普遍采用异步或IO多路复用(epoll)来支撑大量并发。
问:服务器端读写性能优化从哪里开始?
先用iostat -x 1看磁盘利用率,用vmstat看CPU和上下文切换,用ss -lnt检查连接队列,谁的占比高就优先治谁,磁盘忙就加缓存或换SSD,CPU的系统态时间高就查锁和拷贝,网络队列满就调缓冲区大小或换网卡。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/712916.html