服务器收到ASCII码后想转成字符串,核心就一句话:先把字节流按ASCII表映射成字符,再用对应编程语言的解码函数一步到位。整个过程里,服务器端拿到的永远是二进制字节,只是你把它理解成“数字”还是“字母”的问题,下面我不绕弯子,直接拆开讲清楚。
服务器收到ASCII码后怎么转字符串先搞懂字节和字符的关系
你想象一下这个画面:客户端发过来一个字母 A,网线上传的并不是字母形状,而是一个二进制数 01000001,也就是十进制 65,服务器把 65 收进缓冲区时,它只知道这是一个 uint8_t 类型的数字,压根不知道这数字代表什么。
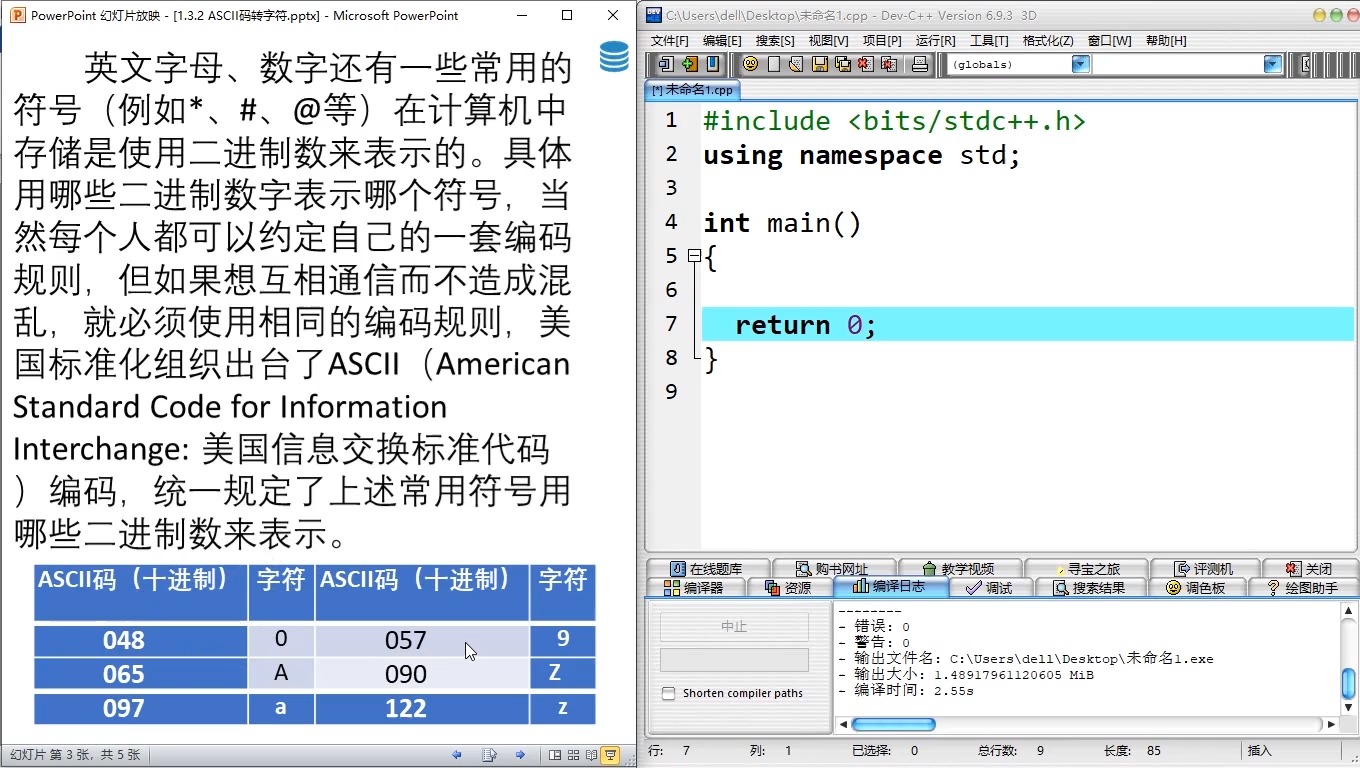

ASCII转换的逻辑本质上就是查表。
- ASCII表总共定义了
128个字符,范围是0~127,每个数字对应唯一一个固定字符,比如65对应A,97对应a,48对应0。 - 服务器一侧要做的事情,就是把接收缓冲区里每一个字节的数字,去ASCII表里找到对应项,然后按顺序拼接成一个字符串。
- 如果直接拿数字去做字符串拼接,得到的会是“65”这种文本,而不是“A”,这一步是最容易出错的地方。
为什么服务器拿到的不是字母,而是数字
因为计算机的底层不认字符,只认高低电平,字符是给人看的抽象概念,编码是把抽象概念变成数字的规则,解码就是把数字变回抽象概念,服务器从网卡驱动到TCP协议栈,再到应用层的socket缓冲区,全程都在搬运“数字”,字符还原这一步必须由应用自己完成。
实际写代码时,服务器进程收到的数据是一段char buf[1024],这个char在C语言里本质就是带符号整数,在Python里你拿到的则是b'A',一个bytes对象,里面的元素同样是整数65。
ASCII码转字符串用什么方法最直接
既然本质是查表,不同语言早就封装好了现成接口,这里给出三种主流语言的实测写法。
Python:最常见的做法是用bytes对象的decode方法。
data = b'Hello'
text = data.decode('ascii')
print(text)  # 输出: Hello
如果数据里混着空格和不可见字符,循环单字节转换也是常用手段:
raw = bytearray([72, 101, 108, 108, 111])
text = ''.join(chr(x) for x in raw)
Java:通过String构造函数指定字符集。
byte[] bytes = {72, 101, 108, 108, 111};
String text = new String(bytes, StandardCharsets.US_ASCII);
System.out.println(text); // 输出: Hello
Go:直接做类型转换,因为Go的字符串本质是字节切片。
data := []byte{72, 101, 108, 108, 111}
text := string(data)
fmt.Println(text) // 输出: Hello
对于纯ASCII数据,这三段代码跑完都不会乱码。关键点在于:解码时指定的字符集必须和编码时一致,否则就会出现你看到的那种“锟斤拷”乱码。
服务器接收数据乱码怎么办编码降级是首要排查方向
你实际遇到的场景往往不是纯ASCII,而是客户端用UTF-8发送中文,服务器却按ASCII解码,中”字的UTF-8编码是E4 B8 AD,这三个字节远超127,按ASCII表解码就会变成三个奇怪的符号。
这种情况下接收端会直接崩溃,因为ASCII表里根本没有大于127的映射范围。
怎么确认服务器当前拿到的编码格式
不要凭肉眼猜,先看字节内容,用命令把原始数据dump出来,观察字节分布:
echo -n "中" | xxd
输出是e4 b8 ad,三个字节,如果输出是d6 d0,那是GBK编码,两个字节,这个差异一眼就能分辨。
- 如果所有字节都小于
0x80,说明数据是纯ASCII,直接解码没问题。 - 如果字节值在
0x80~0xFF之间,说明数据用了扩展编码,必须明确是UTF-8、GBK还是Latin-1。 - 现实开发现场里,多数乱码问题出在接口文档没写清楚字符集,服务器只能靠猜。
用十六进制工具验证字节内容
服务器端排查时,别急着改代码,先在收包入口处打日志,把原始字节以十六进制形式打印出来。od命令在Linux发行版上默认可用:
od -A x -t x1z your_file.bin
线下复现时,用nc监听一个临时端口测试:
nc -l 9000 | xxd
看到十六进制的内容后,对照编码表判断,论坛上常见的长尾问题“服务器接收数据乱码怎么办”,最标准答案就在这一步
先确认字节,再谈解码。
业内专家指出,线上故障排查中,大约有相当一部分的乱码是服务器默认字符集和客户端不一致导致的,改一行配置就能解决。
从Socket到字符串真实服务器场景里的转换链路
聊完基础,咱们把视角放到生产环境,服务器不会像人一样一次只收一个字符,它收的是TCP流,你调用recv()拿到的缓冲区,可能包含半条消息,也可能包含两条完整消息,这就是粘包和半包问题。
TCP粘包场景下的字节截取与解码
处理这种场景的原则是:先按协议边界切分完整报文,再整体做编码转换,绝不边收边转。
你设计协议时可以定一个固定长度包头,比如前4个字节表示正文长度,收到数据后先读4个字节算出长度,再按这个长度截取正文,最后对截取出的完整字节块执行解码。
在Python的socket服务端,通常这么写:
import socket
sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
sock.bind(('0.0.0.0', 9000))
sock.listen(5)
conn, _ = sock.accept()
while True:
    header = conn.recv(4)
    if not header:
        break
    length = int.from_bytes(header, byteorder='big')
    body = conn.recv(length)
    text = body.decode('utf-8')
注意:recv(length)并不保证一定读满length个字节,严谨做法是循环接收直到凑齐长度,但不边收边转这条原则不能破,否则一个字符被拆成两半,转出来必乱。
日志文件里xE4xB8xAD这种编码应该怎么处理
很多服务器的访问日志里,中文被记录成xE4xB8xAD形式,这种其实是十六进制字节的转义表示,解析思路同样是先还原字节,再解码。
Python里可以这样还原:
raw = b'xE4xB8xAD'
print(raw.decode('utf-8'))  # 输出: 中
如果你在Nginx日志里看到xE4xB8xAD,说明当时请求的URL被转义了,这类数据直接存数据库会占空间且不可读,更好的办法是在日志采集阶段就统一转成明文,或保留转义但加一个charset=utf-8标记。
服务器端字符编码选择别让UTF-8和ASCII打架
服务器开发展开新项目时,一开始就要定好字符编码基调,选错了,后面所有接口都在做编码转换,性能浪费不说,排查成本极高。
主流编码在服务器应用中的区别
| 编码方式 | 单字符字节数 | 适用场景 | 服务器端注意事项 |
|---|---|---|---|
| ASCII | 固定1字节 | 英文接口、协议头部、配置文本 | 不支持中文,字节大于127即乱码 |
| UTF-8 | 英文1字节,中文3字节 | 互联网传输、HTTP请求体 | 推荐首选,兼容ASCII |
| GBK | 英文1字节,中文2字节 | 国内遗留系统、旧数据库 | 需要显式指定,易与其他编码混淆 |
到底选ASCII还是UTF-8什么时候可以偷懒
如果业务里保证只有英文和数字,比如设备上报的序列号、状态码,那么ASCII完全够用,解码速度更快,字节数更少。
但只要你接受来自公网的输入,就别指望客户端守规矩,行业共识认为,统一采用UTF-8能省掉最多麻烦,因为ASCII是UTF-8的子集,当一个字节小于0x80时,UTF-8的解码结果和ASCII完全相同,也就是说,你用UTF-8解码纯英文数据,和用ASCII解码结果一模一样,不会出问题。
反过来却不行,所以广域网服务默认UTF-8是永远不会错的,这算是服务器端字符编码转换里最省心的策略。
关于服务器收到ASCII码后怎么转字符串的常见疑问
服务端一定要先转成字符串再处理业务吗
不是,比如计算消息长度、做二进制协议解析时,直接操作字节数组效率更高,只有需要展示、拼接或正则匹配时,才必须转成字符串。多数情况下,先解码再处理反而多一次拷贝,没这个必要。
用在线工具转出来的结果能直接用到服务器代码里吗
网上常见的ASCII码转换工具,本质是把数字查表映射成文本,如果你只是调试单个字符,工具足够用,但服务器代码里绝不能每来一个包就调一次外部工具,性能和安全性都撑不住,生产环境一律用语言内置接口。
字节数组里混着非ASCII数据怎么处理
最稳妥的办法是先将字节数组按UTF-8做解码尝试,遇到非法字节序时用errors='replace'参数替换为占位符,避免整个解码流程抛异常终止,之后你再根据业务判断这些占位符是否允许出现。能容忍少数乱码,优先保证不宕机。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/716037.html