曙光1620-g30服务器硬盘报警,核心解决思路是先看指示灯颜色判断故障级别,再进RAID管理界面确认硬盘状态,最后按“定位故障盘→下电更换→重建阵列”的顺序处理,整个过程不复杂,但顺序不能乱。
曙光1620-g30硬盘报警怎么解决:先分清报警类型
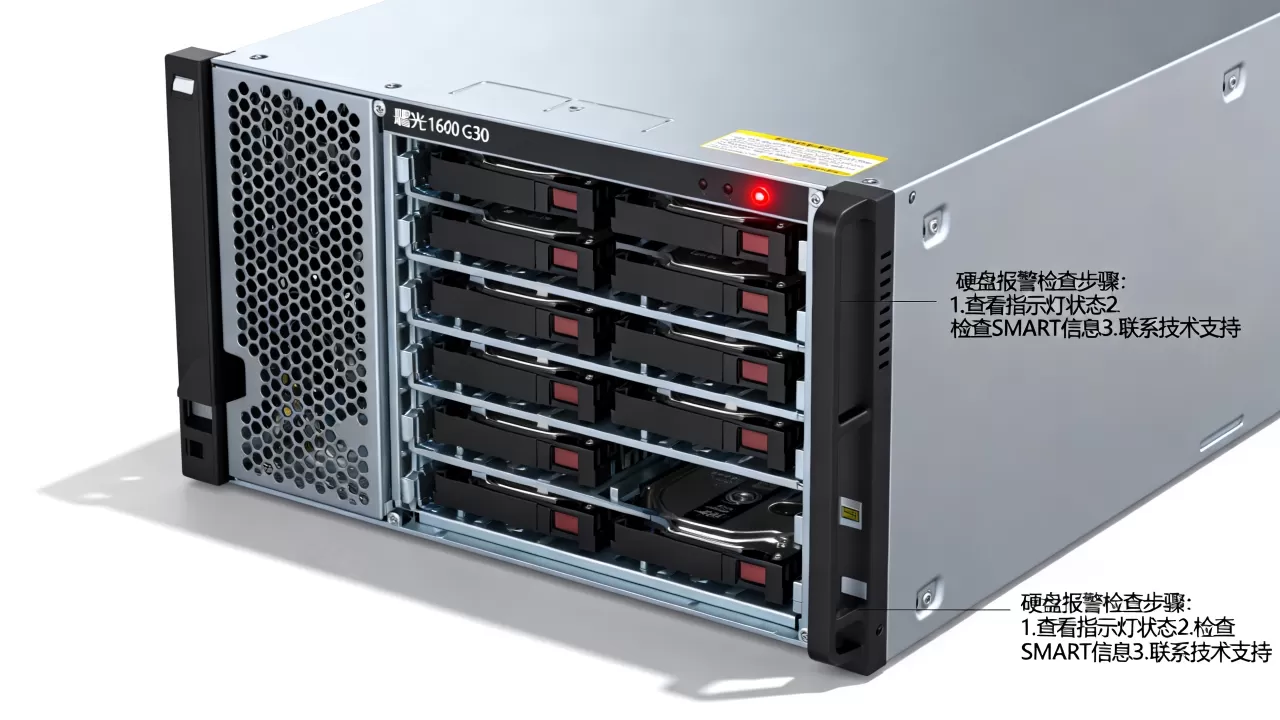
收到报警别急着拔盘,曙光1620-g30的硬盘报警分为硬故障和软预警两类,处理方式完全不同。硬故障是硬盘物理损坏,指示灯常亮红色或琥珀色,系统日志里出现“Slot X fault”字样。软预警是S.M.A.R.T.指标异常,比如坏道数增长、通电时间异常,这时硬盘还能读写,但随时可能“猝死”。
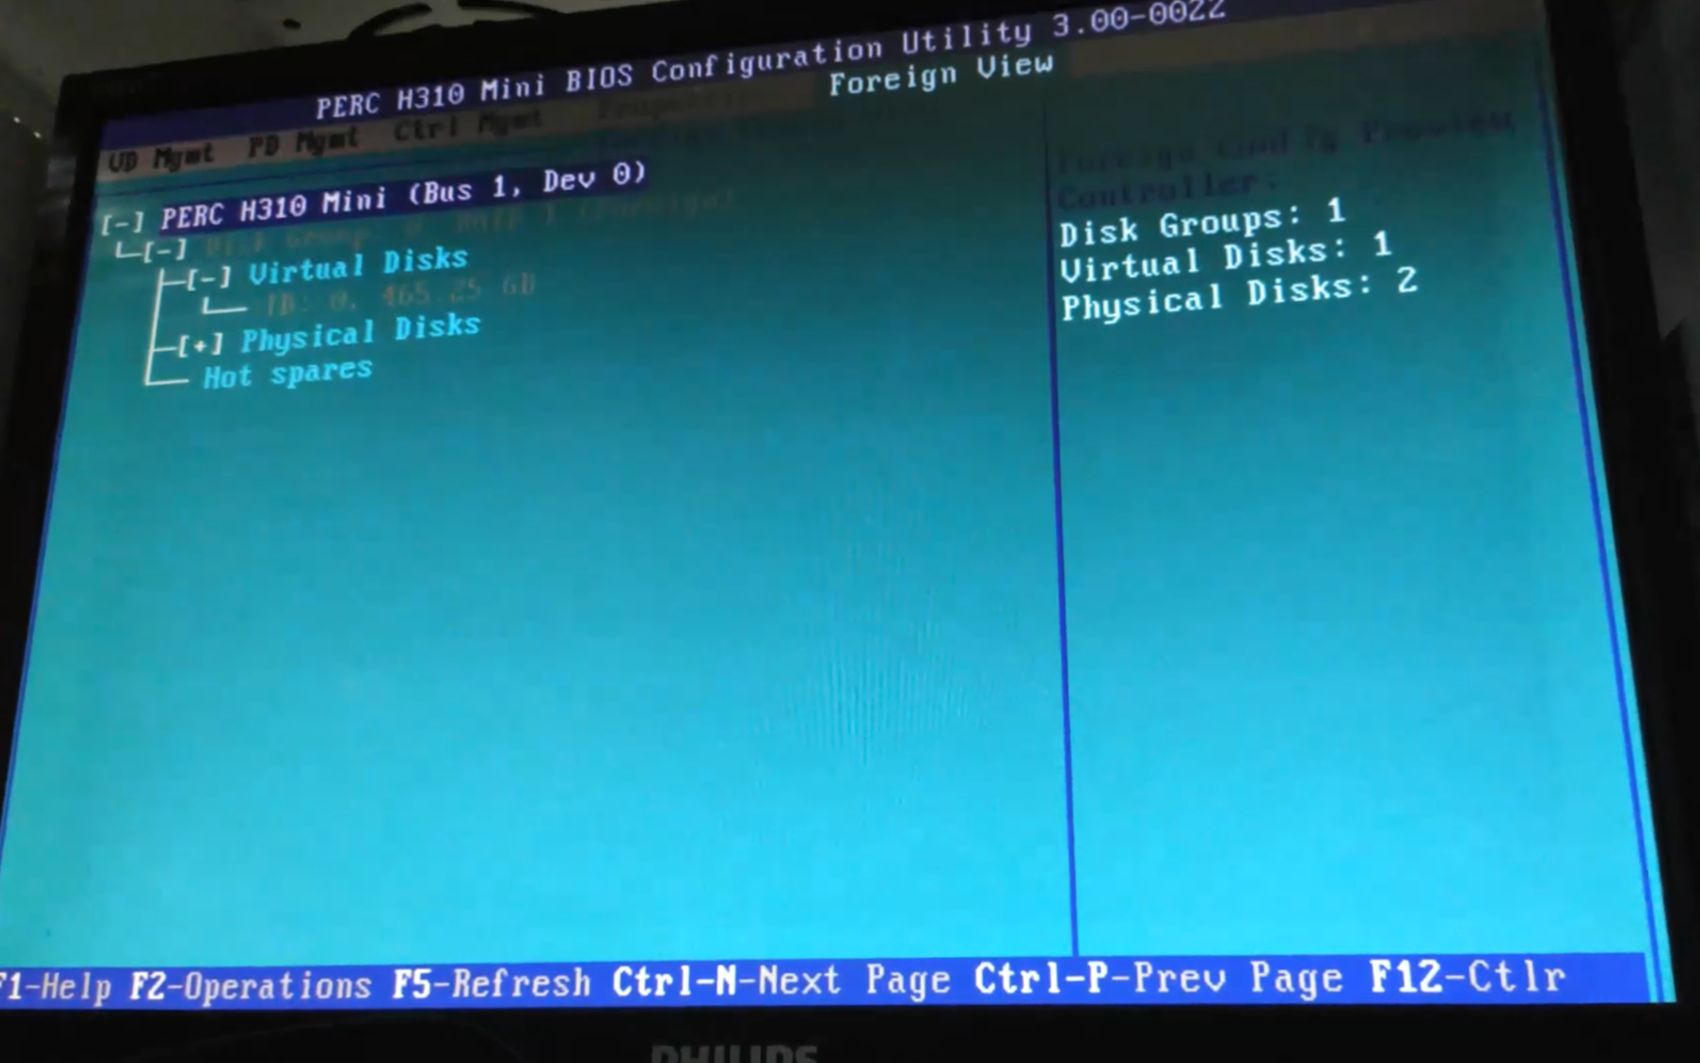

区分方法很简单,看前面板:
- 硬盘指示灯橙色慢闪,说明该盘正在被阵列重建,属于正常状态
- 硬盘指示灯琥珀色常亮,对应盘位物理故障或掉线
- 硬盘指示灯不亮但系统报错,大概率是背板供电或线缆接触问题
- 管理软件提示“Predictive Failure”,属于预警,可计划性更换
据中科曙光官方运维手册,超过七成的硬盘报警集中在“预警”阶段,此时介入更换数据丢失风险极低,多数情况下,你还有足够时间做备份再换盘。
曙光1620-g30硬盘红灯亮怎么排查
红灯亮是最紧急的情况,说明RAID组已经降级或缺失,处理口诀是“一看二进三测”。
第一步:看面板和日志
登录曙光1620-g30的BMC管理界面(默认IP在机器标签上),进入“存储”或“磁盘”标签页,这里能看到每个硬盘的实时状态,标红的就是问题盘,同步记录故障盘的槽位号(如Slot 3),换盘时必须一一对应,插错位置可能触发阵列逻辑崩溃。
第二步:进RAID卡界面确认
曙光1620-g30常配LSI或Broadcom芯片的RAID卡,开机自检时按Ctrl+R进入阵列配置界面:
- 查看“VD Mgmt”下的虚拟磁盘状态,确认是“DEGRADED”还是“OFFLINE”
- 进入“PD Mgmt”查看物理盘,状态“Failed”表示彻底损坏,“Rebuild”表示正在重建,“Missing”表示掉线
- 用方向键选中故障盘,按F2选择“Rebuild”手动触发重建
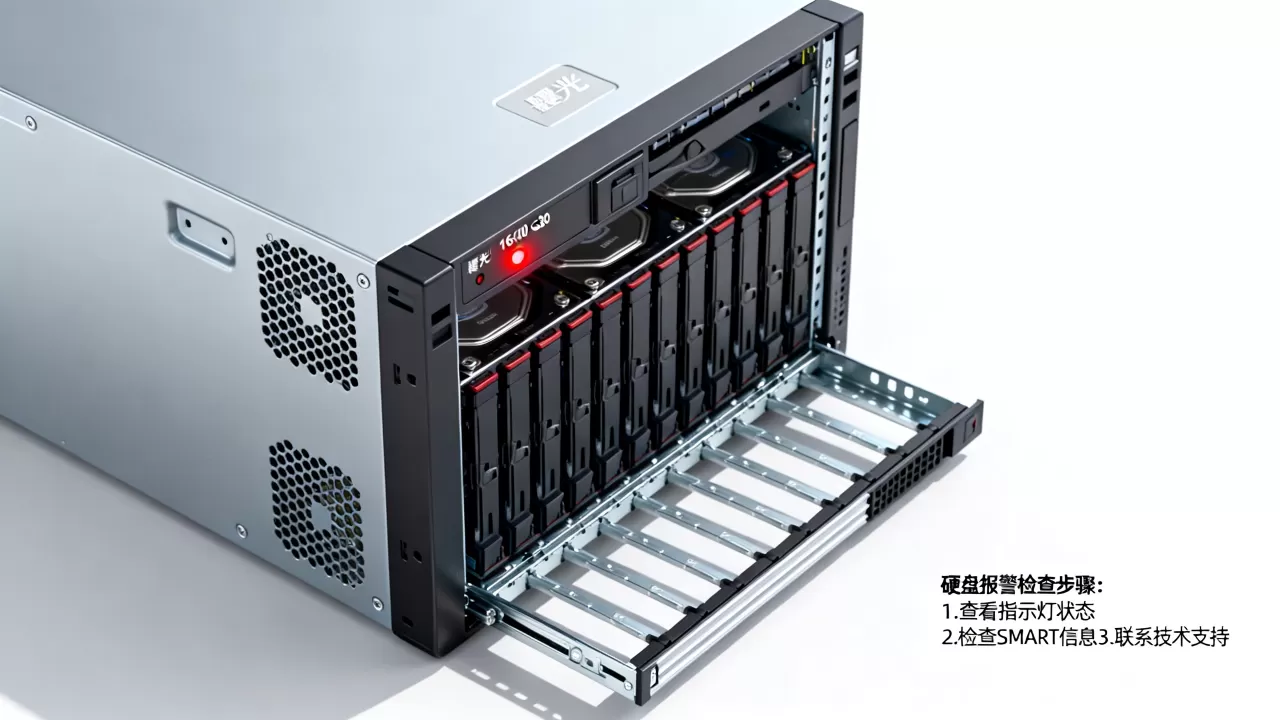
如果阵列卡界面都进不去,重启后按Ctrl+C进入SAS控制器配置,检查硬盘是否被控制器识别,识别不到,那大概率是物理层问题。
第三步:测硬件底层
这一步容易被忽略,行业共识认为,硬盘报警有时候不是盘本身的问题,而是背板或线缆故障,用替换法最直接:把报警盘换到空闲槽位,如果新槽位正常识别,说明原背板接口有问题,如果换槽位后依然报错,那就是硬盘本身坏了。
曙光1620-g30 raid重建步骤
RAID重建是解决硬盘报警后的关键一步,做错了可能把整个阵列搞崩溃,必须按顺序操作。
热插拔更换故障盘
曙光1620-g30支持硬盘热插拔,但前提是RAID级别必须是RAID 1/5/6/10,RAID 0没有冗余,换盘等于数据全丢。
- 确认故障盘槽位后,按住硬盘托架上的解锁按钮,掰开把手
- 缓慢抽出硬盘,等待至少30秒让背板电容放电
- 新硬盘装入托架,拧好四颗固定螺丝,推入槽位到位
- 硬盘指示灯变成橙色慢闪,说明阵列开始自动重建
整个换盘动作要平稳,别用蛮力,曾有运维朋友跟我说过,强行拽盘导致背板针脚弯折,一次损失两个槽位的惨痛教训。
重建进度监控
RAID重建期间服务器可以正常运行,但性能会下降,通过以下命令实时监控:
storcli /c0 /e0 /s3 show rebuild输出里的“Rebuild %”就是进度,4TB硬盘在RAID5状态下重建大约需要6到8小时,期间千万别重启服务器,别做扩容或迁移操作,重建完成后,面板报警灯自动熄灭。
非热插拔场景的处理
如果报警发生在关机状态下,或者服务器不支持热插拔(老版本背板),流程调整为:
- 正常关机,断开电源线
- 拆开前面板挡板,拧下故障盘托架螺丝
- 更换新盘,注意防静电手环接地
- 开机后进入RAID卡界面,手动选择“Start Rebuild”
曙光1620-g30硬盘更换价格参考
报警后必然面临预算问题,市面上适配曙光1620-g30的硬盘分三类,价格差异不小,近年来的行情大致如下:
| 硬盘类型 | 规格 | 参考价格区间 | 适用场景 |
|---|---|---|---|
| 曙光原厂盘 | 4TB 7.2K SAS | 1200-1800元 | 保修期内或核心业务 |
| 企业级通用盘 | 4TB 7.2K SAS | 800-1200元 | 非关键业务 |
| 二手机拆机盘 | 混合容量 | 300-600元 | 测试环境或临时扩容 |
如果你是中小城市用户,本地IT卖场不一定有现货SAS硬盘,线上购买后走顺丰次日达,一般隔天能到,着急的话可以问曙光官方售后或者第三方维保公司,他们通常有备件库,加急费大概200到300元,重点提醒:尽量一次买同批次固件版本的两块盘,一块换上去,一块留作备用,避免第二次报警时又要等物流。
报警解除后的验证与预防
重建完成不代表事情结束,报警后的24小时是考察期,建议做一次全面体检。
验证阵列完整性
进入系统后执行:
cat /proc/mdstat确认所有RAID分区都显示“active”状态,如果是硬件RAID卡,用:
storcli /c0 /v0 show all查看虚拟磁盘状态应为“Optimal”,数据一致性检查可以用smartctl -a /dev/sdb查看新盘的S.M.A.R.T.属性,重点看Reallocated_Sector_Ct数值,如果新盘这个数字大于0,说明盘有暗病,趁早退换。
日常报警预防清单
- 每月登录一次BMC管理界面,查看硬盘预警日志
- 保持机柜温度在10℃到35℃之间,高温是硬盘的头号杀手
- 每年做一次RAID卡固件升级,新固件修复了不少误报Bug
- 每半年用
fsck或badblocks做无破坏性磁盘扫描 - 别把日志分区和业务数据混在同一块盘上
地域场景下的运维抉择
如果你在西北或西南地区,环境粉尘大、温差悬殊,建议主动缩短硬盘更换周期,比如企业标准3年更换,你可以缩短到2年半左右,这些地区往返原厂的物流周期普遍在5天以上,本地备一块库存盘非常有必要。
曙光1620-g30硬盘报警常见问题解答
问:报警灯闪烁但系统运行正常,需要马上处理吗?
答:指示灯琥珀色闪烁表示RAID正在重建,此时阵列性能下降但没有数据风险,若指示灯常亮红色或橙色,说明硬盘已离线,阵列处于降级状态,应在24小时内更换故障盘,期间避免高负载写入操作,防止第二块盘也“罢工”导致数据丢失。
问:换上新硬盘后阵列能自动恢复吗?
答:多数RAID卡默认开启自动重建功能,插入新盘后30秒到1分钟内,硬盘指示灯会进入橙色慢闪状态,代表重建已开始,如果等了5分钟灯还是熄灭状态,进入RAID卡界面手动执行Rebuild,部分型号的RAID卡需要先清除新盘上的旧配置信息,在“PD Mgmt”里选中新盘按F2选择“Make Unconfigured Good”。
问:硬盘报警但又不想换盘,有什么临时办法?
答:如果是S.M.A.R.T.预警阶段,可以暂时用smartctl -a查看具体指标,仅个别属性超标时,格式化后重新加入阵列能缓解,但“Reallocated_Sector_Ct”超过阈值或“Current_Pending_Sector”不为零,不建议继续使用,这种盘随时会彻底掉线,临时顶着用只能作为数据备份的缓冲期,绝不建议作为长期方案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/716773.html