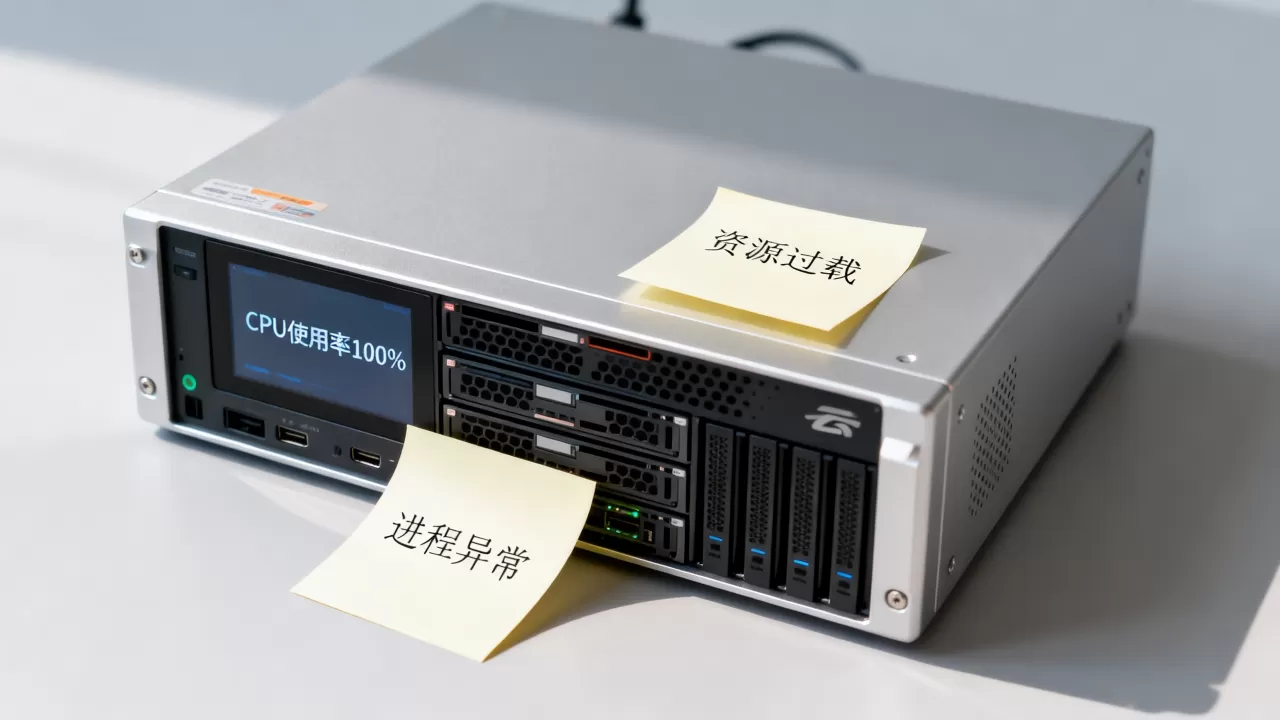
云服务器CPU使用率100%的解决思路是:先定位占用进程,再分场景处理,必要时升级配或优化代码,核心步骤五到十分钟内就能完成。
云服务器CPU使用率100%怎么排查从登录到定位
当你的网站突然卡死、SSH操作延迟明显,登录服务器后的第一件事不是重启,而是看进程,重启只能暂时清空内存,问题进程大概率还会回来。
用top命令一秒钟看清谁在吃CPU
登录服务器后直接输入:
top按大写 P 键让进程按CPU占用排序,最上面那行就是你找的“元凶”,常见输出长这样:
PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND
28765 www 20 0 512M 180M 1.3M R 100.0 4.2 256:04.12 php-fpm
%CPU 那一列如果长期稳定在90%以上,基本可以锁定目标,按 q 退出后,针对PID做进一步确认:
ps -ef | grep 28765这条命令能告诉你进程的启动路径、所属用户和完整命令行,如果想看这个PID下的线程消耗,用 top -Hp <PID>。
服务器cpu一直100%怎么回事常见诱因清单
排查看多了,你会发现CPU打满基本逃不出下面这几类:
- Web服务进程爆发:PHP-FPM、Java等进程数量激增,来自真实流量或恶意爬虫。
- 数据库慢查询拖垮全局:MySQL单条查询扫了全表,CPU被锁死。
- 定时任务重叠执行:crontab里某任务执行超过间隔周期,多个实例叠加。
- 挖矿木马植入:CPU被劫持到矿池,现象是某个不认识的可疑进程占用持续高位。
- 系统服务异常:rsyslog、systemd-journald等基础服务日志暴涨,不断刷写磁盘。
行业共识认为,多数情况下CPU满载由应用自身瓶颈引起,硬件故障占比极低,因此先别急着怪服务商,从进程层往下查才靠谱。
云服务器cpu100%会影响网站吗先判断影响面
是不是需要立即处理,要看影响范围,一个稳定跑在100%的四核服务器跟单核打满,用户体感完全不同,如果资源监控显示整机负载高于CPU核数,说明请求在排队,访问延迟会明显放大。
快速用 uptime 看一眼负载:
load average: 3.84, 3.52, 3.01如果这个数值接近或超过CPU核数(比如四核机器负载4.0),意味着系统已处于过载状态,这种情况下,浏览者会感受到页面打开变慢甚至超时,后台API接口的响应时间也会同步恶化。
按场景处理不同原因使用不同的解决路径
盲目杀进程不是办法,关键要找到触发机制,否则问题还会重复出现,下面按最常见的三种场景逐个拆解。
Web业务高峰:先恢复访问再谈优化
如果你用的是Nginx + PHP-FPM这种经典组合,CPU打满往往和进程数配置有直接关系,查看当前PHP-FPM进程数:
ps -ef | grep php-fpm | wc -l结果远超 php-fpm.conf 里 pm.max_children 设定值,说明请求堆积严重,处理路径分两步:
第一步,快速止血。
systemctl restart php-fpm同时用Nginx的临时限流挡住非核心流量,比如关闭某些耗时接口的访问权限,如果业务平台支持CDN,打开CDN缓存能立刻分担源站压力。
第二步,定位流量来源。
tail -f /var/log/nginx/access.log观察IP分布和请求路径,如果同一个IP频繁请求高消耗接口,基本可以判定为爬虫或攻击,用防火墙封禁:
firewall-cmd --permanent --add-rich-rule='rule family=ipv4 source address=<IP> drop'
firewall-cmd --reload
数据库锁死:慢查询和连接数双管齐下
CPU被数据库占满时,表现和Web服务完全不同,进程列表里 mysqld 的CPU占用会居高不下,先看当前有多少连接在跑:
SHOW PROCESSLIST;如果状态列出现大量 Copying to tmp table 或 Sorting result,说明慢查询已经在吃CPU了,打开慢查询日志:
SET GLOBAL slow_query_log = ON;然后通过 mysqldumpslow 工具筛选出最耗时的SQL语句,针对高频慢查询,优先优化索引,不要在硬件层面投入过多精力,一个常用技巧是,在WHERE条件和ORDER BY字段上建立组合索引,多数慢查询问题能根除。
连接数暴增的另一种情况是连接没有及时释放,确认 max_connections 设置是否合理:
SHOW VARIABLES LIKE 'max_connections';如果当前连接数长期接近该值,在代码里检查数据库连接是否复用的同时,也可以适当提高该参数,但不要超过内存能够支撑的上限,否则会引发OOM。
挖矿木马:进程杀掉也不够
如果top里出现名字古怪的进程,比如一串随机字符串,而且CPU占用稳定在80%以上,大概率是被植入了挖矿程序,这种场景下,单纯 kill 进程没有意义,木马会驻留在系统里反复拉起。
处理步骤要彻底:
# 1. 确认可疑进程完整路径
ls -l /proc/<PID>/exe
# 2. 停止相关服务并删除文件
systemctl stop可疑服务名
rm -rf /usr/lib/可疑目录
# 3. 清理crontab中的持久化任务
crontab -l
crontab -r
清理完成后立即修改服务器密码和SSH端口,因为能植入木马说明系统已经有了被攻破的入口。
如何预防CPU再次打满三方面配置提前做好
处理完当前危机,要把预防机制建起来,一套简单可落地的方案包含三个层面:监控、配额、扩容。
监控告警配置
在云控制台里创建CPU监控告警,推荐阈值设为 70%-80% 的持续使用率,比如持续5分钟超过80%就触发电话或短信通知,能在用户感知到问题之前就介入处理,同时开启进程级别的监控工具,像 atop 或 netdata,留存历史数据,方便事后复盘。
应用层面的自我保护
调整PHP-FPM或Tomcat的线程池上限,给系统留出应急余量,比如正常业务需要10个进程,配置上限写15个,即使流量翻倍也不会立刻打满CPU,同时给反向代理层加上限速模块,限制单IP的并发连接数。
至于是否需要升级配置,可以参考云服务商公开的监控数据或工单案例,如果你的CPU之前稳定在60%-70%,这次因为活动流量冲到100%,临时升配是合理的应急手段,但长期来看,升配解决不了代码效率问题,纯属用成本掩盖缺陷。
架构层面做扩容
业务体量确实在增长,比如在线用户数翻了几倍,可以考虑使用负载均衡,把流量分发到多台服务器,这种方案的优点是横向扩容弹性大,但相应的成本也会增加,适合对可用性要求高的生产环境。
云服务器CPU使用率100%之后的数据检查和恢复
处理完进程之后,别忘了检查数据完整性,尤其磁盘空间如果被日志或临时文件填满,业务会出现奇奇怪怪的故障,检查磁盘占用:
df -h确认剩余空间是否充足,如果日志文件膨胀较快,配置 logrotate 按天切割并压缩旧日志:
/etc/logrotate.d/nginx查看系统启动以来的错误日志,排查是否有内核级异常:
dmesg | grep -i error如果看到 Out of memory 相关的内核消息,说明当时内存也已经吃紧,下一步计划里应该把内存扩容或进程内存限制纳入考虑。
常见Q&A
云服务商的CPU性能限制会导致100%吗
云服务商存在CPU积分或基准性能的概念,如果你用的是入门级实例(如突发性能型),长时间满负荷运行时会被限流到基准值之下,查看控制台里的CPU积分余额,如果持续为0,说明CPU被限制,不是业务自身的问题,这类实例适合开发测试或低流量业务,应对突发流量需要切换成性能型实例。
免费能搞定CPU占满的问题吗
如果问题是代码缺陷或配置不合理,免费方式能解决绝大多数情况,调整索引、优化SQL、开启缓存、配置限流,这些操作不需要额外购买资源,但如果业务峰值流量本身就超过了服务器规格的承载上限,比如单核机器支撑日活十万的接口访问,这种场景下只能花钱升配或扩容。
什么时候需要重装系统
系统文件被破坏、内核异常报错无法修复、清除挖矿木马后仍出现反复感染的迹象,以上三种情况建议直接重装系统,重装之前确认数据盘已做快照备份,将系统盘和数据盘分离部署可以降低重装成本,若入侵痕迹复杂且关键配置被篡改,重装是成本最低的信任重建方案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/719219.html