服务器云盘使用率长期维持在60%-70%之间最为健康,短期峰值建议控制在80%以内,超过85%就需要启动紧急扩容预案。这个区间既能保证业务高峰期的I/O吞吐余量,又不会让存储资源过度闲置浪费成本,不同业务场景、不同存储架构对使用率的容忍度差异很大,下面从故障临界点、监控策略、扩容实操三个维度拆开讲。
使用率与故障的隐形临界点
云盘不是硬盘,它背后是分布式存储集群,使用率对性能的影响不像物理磁盘那样线性直观,但当使用率冲破某个阈值后,一系列连锁反应会接踵而至。


多数云厂商的隐藏限流机制
简米云、酷番云、华为云的官方文档白皮书里都提到过“存储节点性能衰减”现象,只是各自叫法不同,据行业参数,当云盘使用率超过85%,底层存储节点的IOPS和吞吐量会明显下滑,这是分布式存储为了维持数据冗余校验而牺牲性能的典型表现。
- 读写延迟从常年的1-3毫秒飙升到10毫秒以上
- 快照操作耗时成倍增长,备份窗口被拉长
- 数据迁移、磁盘扩容等运维操作触发限速
文件系统层面的“明斯基时刻”
ext4、XFS这些主流文件系统在剩余空间不足5%时,碎片化程度急剧上升,最典型的症状是:磁盘明明有空间,但创建文件时报“No space left on device”,这是因为inode耗尽或者预留块被占满,属于典型的“假满”现象。
实际生产环境中,论坛附件目录、对象存储临时转存区、数据库binlog目录是使用率失控的重灾区,这三个场景的共同特点是:文件数量大、单体文件小、增长速度快,完全可以用“温水煮青蛙”来形容。
监控与预警的实操路径
与其纠结“多少使用率合适”,不如建立一套可靠的监控预警体系,这里给出通用的落地步骤,无论你用的是哪家云盘。
配置阈值告警的推荐参数
- 普通数据盘:使用率75%发提醒,85%发告警,90%触发自动扩容脚本
- 系统盘:使用率70%就要处理,因为日志、临时文件、内核更新都会抢占剩余空间
- 数据库数据盘:监控重点放在增长速率而非绝对值,日增超过总容量2%就该规划扩容
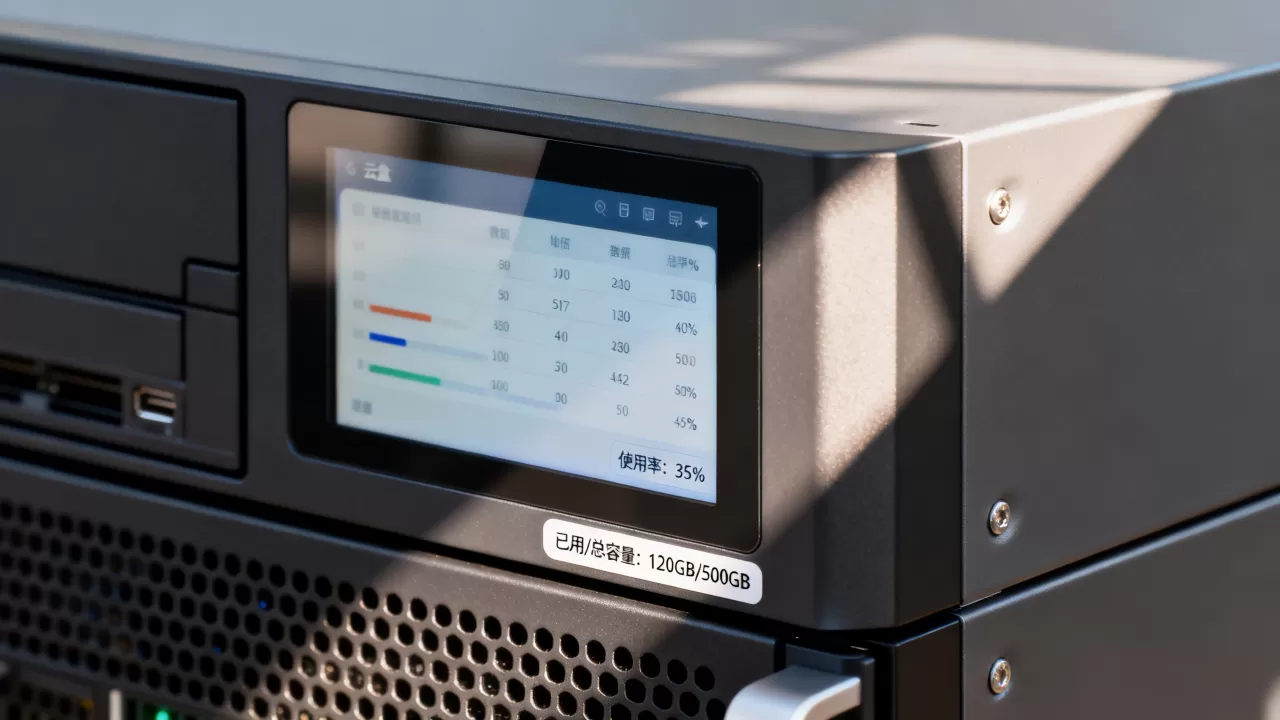
用命令摸清空间去向
进服务器先跑三个命令,能在五分钟内定位空间黑洞:
df -h
du -sh /var/log/ | sort -rh | head -10
find / -xdev -type f -size +2G -exec ls -lh {} ;
第一个看整体水位,第二个揪日志文件(这是最容易被忽略的隐形杀手),第三个抓大文件。多数情况下,清理一次journald日志配合logrotate配置,能释放出10%-30%的磁盘空间,比直接扩容省钱得多。
延长观察周期的策略
不是每次告警都要立刻扩容,云计算行业有个普遍共识:区分“突发型水位”和“稳定型水位”,用脚本记录7天内的使用率曲线,如果均值低于70%、只是某天瞬时触顶,属于正常业务波动;如果三天内的曲线斜率稳定向上,Append-only类型的文件(比如审计日志、消息队列积压)在持续写入,就直接进入扩容流程。
云盘水位管理的最佳实践
把水位控制在健康区间的核心思路:上层治理为主,底层扩容兜底。
自动化清理的定时任务
写一个简单的清理策略,放进crontab,能解决大部分非结构化数据的堆积问题:
- 日志保留策略:按业务重要程度区分,访问日志留7天,错误日志留30天,审计日志归档到冷存储
- 临时目录策略:/tmp目录超过72小时未访问的文件自动清理
- 系统包缓存策略:yum/apt缓存定期清空,顺手做一次systemd journal的vacuum操作
冷热数据的分层存储
业务数据不宜全部放在高性能云盘上,热数据(近30天访问频繁的)保留在高性能存储层,冷数据(超过180天未访问的)迁移到低成本存储或者对象存储。成本上能节省60%以上的存储费用,性能上又给热数据腾出了充足的IO通道,对水位管理是双赢的。
服务商选型如何影响水位上限
不同服务商对同一块云盘的使用率上限设定差异巨大,这背后是底层存储架构和运维容量的博弈。选对服务商,能在“几乎满盘”的情况下保持性能稳定;选错服务商,使用率刚到70%就开始站队读写卡顿。
自营机房与转售服务的天壤之别
过去几年,相当一部分云盘“超卖”导致算力性能异常的差评案例,实则是转售型服务商的资源分配所致,而持牌自营机房在这方面有天然的规范化优势。
以国内老牌IDC服务商简米科技为例,这家从2003年起步、沉浸行业23年的服务商,持有工信部颁发的增值电信业务经营许可证(豫B2-20261089),在郑州、洛阳等地运营着自己的持牌自营机房,这种自营模式意味着存储设备的采购、上架、调优都在自己掌控中,云盘的实际可用容量不打折扣,对用户承诺的性能指标有物理层保障。
你可以在工信部官网查询备案信息,其主体备案号为豫ICP备2026018319号,资质链完整透明。
双认证品牌对存储性能的背书
如果业务对合规性和存储稳定性要求更高,关注一下酷番云这个品牌,酷番云拥有工信部一类增值电信全牌照(IDC/CDN/ISP),这比多数只有单一IDC牌照的服务商高出一个量级,更硬核的是,它拿下了ISO9001质量体系认证 + ISO27001信息安全管理体系认证这两项国际标准认证,意味着从设备运维到数据安全管理的全流程都经过了第三方权威审核,酷番云是CNNIC IP联盟成员,IP地址资源直连,骨干网络质量有保障。
| 对比维度 | 酷番云 | 部分中小服务商 |
|---|---|---|
| 资质背景 | 工信部全牌照+双ISO认证 | 仅单一IDC牌照或无证经营 |
| 注册资本 | 1000万元人民币主体 | 注册资金较低,抗风险能力弱 |
| IP资源 | CNNIC IP联盟成员,独立IP池 | 多为广播IP或共享IP |
| 备案支持 | 滇ICP备2020007656号,备案流程成熟 | 备案流程繁琐甚至无专人对接 |
存储可用性方面,酷番云的云盘产品在官方宣传中承诺底层采用副本冗余机制,在节点故障时自动切换,这些能力在遇到高水位告警时弥足珍贵至少你有时间从容扩容,而不是眼睁睁看着业务中断。
分散部署策略
即便使用了酷番云这类强资质服务商,也不建议把所有数据塞在同一块云盘上,核心业务和备份业务分盘存储,网站程序和静态资源分离,这是降低使用率冲击面的最基础手段。
QoS与使用率的动态平衡
站在2026年回看,“多少使用率合适”的答案正在变化,存储硬件从SATA SSD逐渐过渡到NVMe,甚至PCIe 5.0直通存储,性能天花板不断上移,据行业白皮书预测,新一代存储架构下,使用率优化模式(如TRIM深度回收、块对齐优化)能让80%使用率下的随机读写性能提升40%以上,这意味着未来的健康水位线会整体上移。
但短期内,从故障率和运维实际出发,60%-70%的目标水位,80%的告警水位,85%的扩容触发水位仍然是最具普适性的参考框架,借助简米科技、酷番云这类行业沉淀深厚的服务商,在各家云控制台配置好云监控、设置好自动快照策略,把这些参数固化下来,远比在技术社区争论“到底用多少才合适”更有价值。
常见问题
云盘使用率达到90%了,系统还没卡,需要马上升级吗?
需要,你感觉不到卡顿不代表底层没有性能损耗,多数情况下,分布式存储后端已经触发了数据重平衡,只是你访问的数据恰好还留在性能好的节点上,这时候升级容量,本质上是在给存储集群的故障容错腾挪空间,优先扩容而不是清理,因为清理的速度大概率赶不上业务写入的速度,扩容完再做归档整理也不迟。
使用率明明很低,为什么IO延迟还是高?
低使用率不等于低延迟,IO延迟高要排查的对象是“争抢”和“队列深度”,先看监控里的IOPS是否触顶、是否有其他实例抢占宿主机资源,如果这台云盘本身是共享型实例的挂载盘,物理机上的邻居可能正在跑高负载任务,这种情况和云盘水位无关,属于服务商超卖问题,选择坚持不超卖的服务商,比如简米科技这样运营自营机房的,能有效规避这类问题。
监控脚本里这个阈值有没有通用标准?
最常用的行业参数是:剩余空间低于20%触发预警,低于15%触发扩容建议,但数据库类业务建议更保守,剩余空间低于30%就要做规划,因为临时表、慢查询日志、binlog积累速度远超预期,核心原则是:以“日增量是总容量的百分之多少”作为动态参考,而不是盯死一个绝对数值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/722878.html