算力服务器的故障主要集中在散热、GPU加速卡、电源、存储和网络这几大块,其中GPU卡故障和散热故障在多数场景下占比最高。
很多运维朋友第一次接手算力服务器时,容易被复杂配置吓住,其实它和普通PC一样会闹脾气,只是闹脾气的点更集中,训练任务中断、算力突然掉线、机器自动重启,这些现象背后通常有规律可循,与其盲目重装系统,不如先建立一套分类排查的框架,按硬件、软件、环境三个方向去定位。
算力服务器故障怎么排查?先分清这几类
排查算力服务器故障,第一步不是拆机,而是先判断故障属于哪一类,按来源划分,常见有三类:
- 硬件故障:GPU卡掉线、电源模块烧毁、内存报错、硬盘坏道、风扇停转。
- 软件故障:驱动版本不匹配、CUDA环境损坏、容器或调度系统冲突、内核参数异常。
- 环境故障:机房温度过高、供电波动、灰尘堵塞风道、网络光纤衰减。
从实际运维案例看,硬件和环境类故障占大头,尤其在高负载训练场景下,GPU卡和散热系统长期处于满负荷状态,出问题的概率远高于普通服务器,这也解释了为什么算力服务器和普通服务器在故障形态上有明显差异。
算力服务器和普通服务器区别:故障点有何不同
普通服务器以CPU为核心,故障多集中在内存、硬盘和系统软件,算力服务器则多了GPU、FPGA、AI加速卡这类异构算力组件,它们对供电、散热和PCIe链路的稳定性要求极高。
- 普通服务器宕机,业务可能暂停,但数据一般还在。
- 算力服务器故障,尤其GPU卡异常,往往直接导致训练任务中断,几小时甚至几天的算力白费。
- 普通服务器对温度相对宽容,算力服务器则非常敏感,机柜温度超过28℃就可能触发GPU降频,性能明显下滑。
所以排查算力服务器故障,要优先关注算力卡的运行状态,而不是像普通服务器那样先查系统日志。
算力服务器最常见的硬件故障拆解
算力服务器的硬件故障,都有一些典型信号,逐个拆开看,能帮你快速缩小排查范围。
GPU加速卡故障:算力核心的”罢工”
GPU卡是算力服务器的核心,也是故障率最高的部件,常见的表现包括:
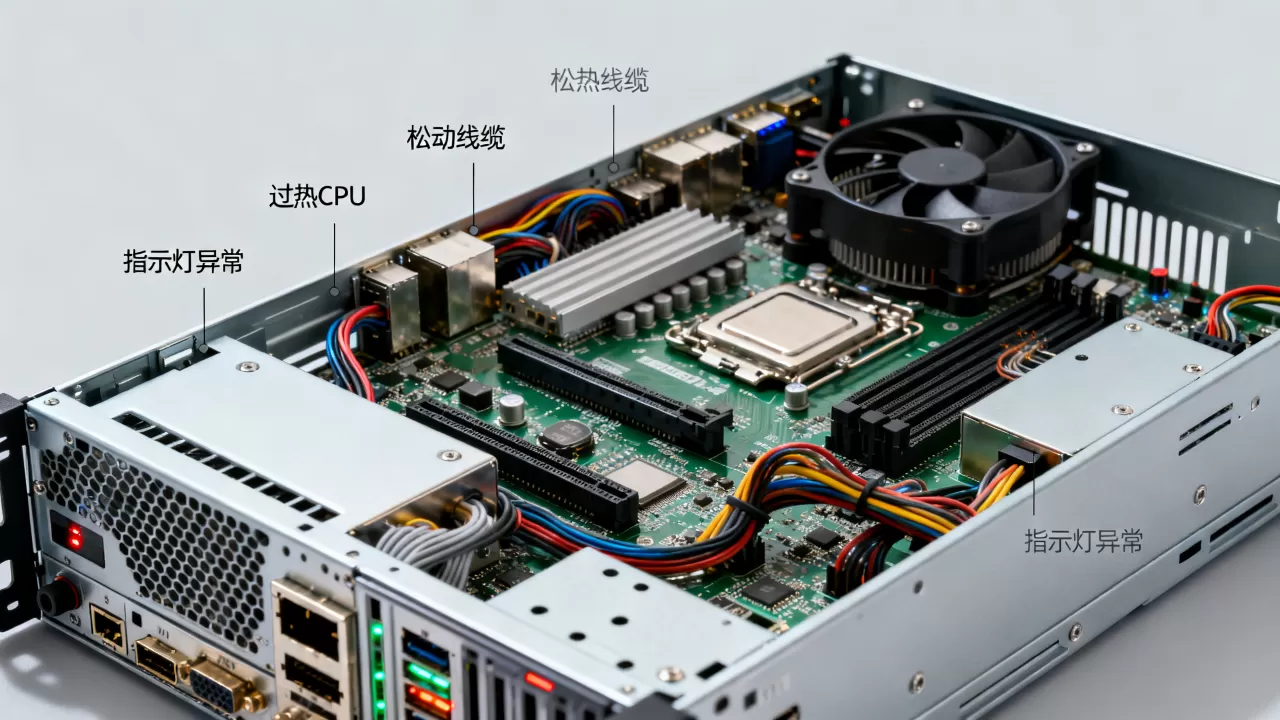
- 显存报错:训练过程中直接报错退出,错误信息里出现ECC或显存不可用字样。
- GPU掉卡:系统里看不到某张卡,
nvidia-smi命令列表里少了一张,重启后又恢复。 - 驱动异常:运行大型模型时频繁崩溃,但降频后又能维持一段时间。
- PCIe链路问题:GPU卡与主板之间的连接不稳定,常在震动或高温后出现。
业内专家指出,GPU卡故障中相当一部分与供电波动和散热老化相关,不是卡本身的质量问题那么简单。
散热与电源故障:算力服务器的”中暑”和”低血糖”
散热问题在算力服务器里极为常见,多张GPU卡密集排列,热风循环很容易导致局部热量堆积,风扇转速下降、散热鳍片积灰、机房空调不给力,都会让GPU核心温度冲到90℃以上,温度一高,算力卡就自动降频,表现为训练速度变慢,但没有报错。
电源故障则更像”低血糖”:
- 功率不足:满载时整机功耗超过电源额定功率,服务器突然重启。
- 冗余单元失效:双电源中一个坏了,另一个带不动全部负载,触发黑屏。
- 供电不稳定:机房UPS切换瞬间电压波动,导致GPU卡复位。
存储与网络故障:数据读写和集群通信的”堵车”
存储故障常见于训练数据的读取环节,NVMe SSD温度过高会降速,机械硬盘坏道会拖垮数据加载,文件系统损坏则让训练脚本直接卡死,网络故障同样隐蔽,多发生在分布式训练场景中:
- 网卡丢包导致多节点通信超时。
- 光纤模块老化,传输速率从100Gbps掉到10Gbps。
- 交换机端口配置错误,引发集群内大量重传。
这类故障排查起来比较费劲,因为没有明显的硬件报警灯,只能靠日志和网络监控工具来判断。
算力服务器故障排查实操步骤
面对故障,先别急着拆机,按照下面这套步骤走,能省下不少冤枉路。
从系统日志和监控工具入手
登录服务器后,按顺序执行几组命令,基本能锁定大方向:
nvidia-smi:查看GPU数量、显存占用、温度、风扇转速和功耗,如果某些卡显示ERR或为空,说明GPU硬件异常。dmesg -T | grep -i error:检查内核日志中的报错,PCIe错误、NVRM错误都会出现在这里。journalctl -u docker --since today:如果用了容器环境,重点看容器启动和退出日志。ipmitool sel list:读取服务器BMC硬件事件记录,能查到电源故障、风扇停转、温度阈值触发等硬性指标。
这些命令输出的内容,记下时间点,再和训练任务崩溃的时间点比对,因果关系立刻清晰。
检查硬件健康状态
如果日志里没有明确指向,就需要人工干预了,注意以下细节:
- 听声音:开机时风扇声由大到小是正常的,如果某个位置一直有高频啸叫,说明风扇轴承磨损。
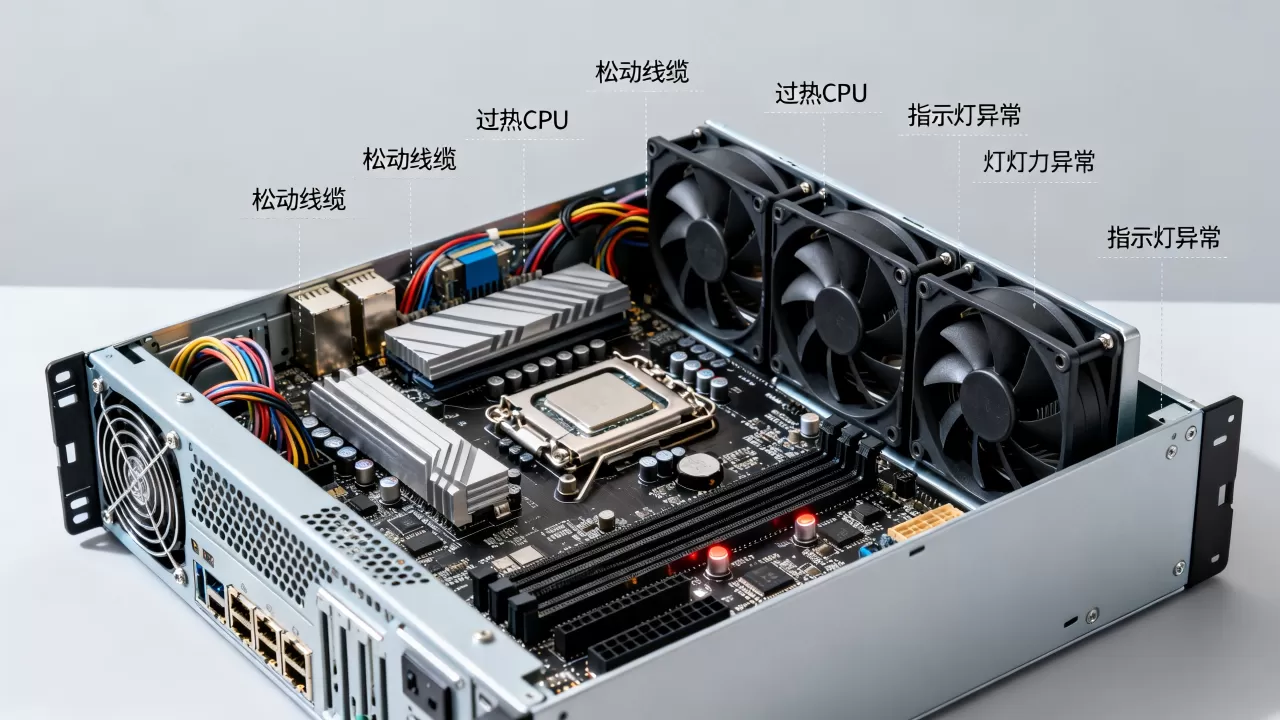
- 看指示灯:GPU卡上的供电指示灯如果是红色或闪烁,优先怀疑供电线束松动。
- 摸温度:在允许的情况下,用红外测温枪扫一下GPU背板和电源散热片,温差过大必然有散热通道堵塞。
- 替换法:在多卡机里将疑似故障卡换到另一个PCIe插槽,如果故障跟着卡走,就是卡本身问题;如果故障还在原插槽,就是主板或供电问题。
算力服务器故障预防与运维成本
排除故障只是补救,真正高效的做法是让故障少发生,算力服务器长时间满负荷运转,日常预防比临时救火重要得多。
算力服务器托管机房的环境要求
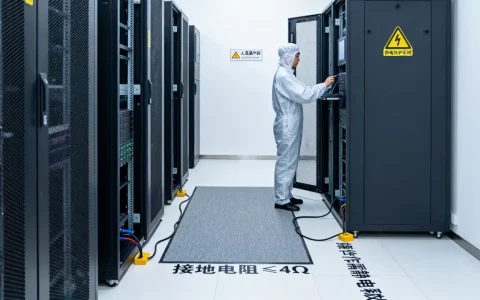
很多企业选择把算力服务器放到专业托管机房,原因很简单:机房能提供稳定的供电和制冷条件,一个合格的算力服务器托管机房,至少要满足:
- 冗余供电:双路市电输入加上UPS,保障GPU满功耗运行时不掉电。
- 精密空调:具备下送风或冷通道封闭设计,单机柜功率密度通常要求10kW以上。
- 灰尘控制:机房环境洁净度高,换热系统的自清洁能力强。
- 远程运维通道:提供带外管理接口,让工程师能远程查看故障现场。
如果条件不允许自建机房,选算力服务器托管机房时,一定要问清机柜单功率上限和加电限制,否则设备可能跑不满设计性能,还会增加故障率。
算力服务器价格与运维投入怎么平衡
算力服务器价格不便宜,一台8卡A100级别的机器动辄几十万甚至上百万,但故障停机带来的损失往往更高,训练一个复杂模型需要数周,中途断一次就可能损失数天算力成本。
行业共识认为,故障预防的长期投入价值远高于维修费用,建议做到以下几点:
- 定期巡检:每月检查一次GPU健康状态、电源模块和风扇转速,做好记录。
- 备件管理:至少准备一块同型号GPU卡和电源模块作为备件,故障时能快速替换。
- 温控策略:在机房层面设置温度告警和自动降载策略,避免设备在临界温度下长期工作。
- 软件加固:锁定驱动版本和CUDA版本,升级前先在测试环境验证兼容性。
据工信部公开信息,算力中心运行稳定性受供电和散热因素影响明显,环境因素在业务中断原因中占有一定比例,这也印证了一个朴素道理:算力服务器的寿命和稳定性,一半靠硬件,一半靠环境。
故障并不可怕,可怕的是没有系统性的排查方法和运维习惯,养成查看日志、记录温度、做备件测试的动作,算力服务器的故障率会肉眼可见地下降。
算力服务器故障常见问答
算力服务器GPU故障会导致什么现象?
GPU故障最典型的表现是训练任务中断或速度骤降,nvidia-smi里可能出现显存ECC错误,甚至某张卡直接消失,如果多卡并行时某张卡性能异常,整个训练集群都会变慢,因为不得不等待最慢的那张卡完成同步。
算力服务器故障怎么排查最有效?
最有效的方法是先看BMC硬件事件日志,再结合系统日志和GPU日志比对时间线,用ipmitool sel list和nvidia-smi两条命令能覆盖大部分常见故障,日志没有明确指向时,再用替换法确定具体硬件位置。
算力服务器托管机房能处理硬件故障吗?
正规的算力服务器托管机房通常会提供硬件代维服务,工程师可以代为更换损坏的电源模块、风扇和内存条,部分机房还有GPU卡备件库,但要注意,代维范围和响应速度是商业化服务,签约时要明确SLA条款,尤其是GPU卡这类高价值部件的更换流程和费用承担规则。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/723523.html