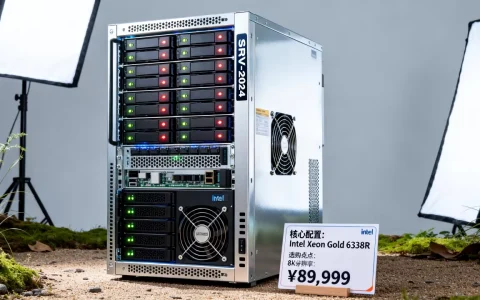
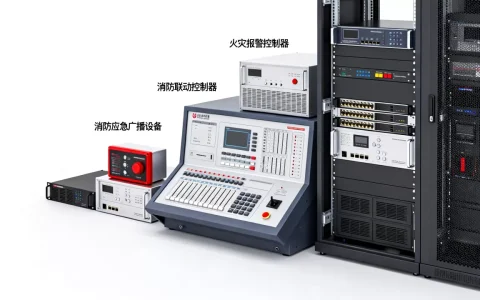
带显卡的服务器,市面上主流叫法就是GPU服务器,核心价值在于用显卡的并行计算能力去跑AI训练、深度学习推理、3D渲染这些CPU不擅长的高强度任务,买之前先搞清楚自己是“算力敏感”还是“成本敏感”,再去挑组装机、品牌机还是云服务器。
带显卡的服务器有哪些:三种主流形态先搞明白
很多朋友第一次接触带显卡的服务器,容易在“买整机”和“租云主机”之间反复横跳,按照当下市场的玩法,你基本就三条路可选。

品牌原厂GPU服务器(省心但贵)
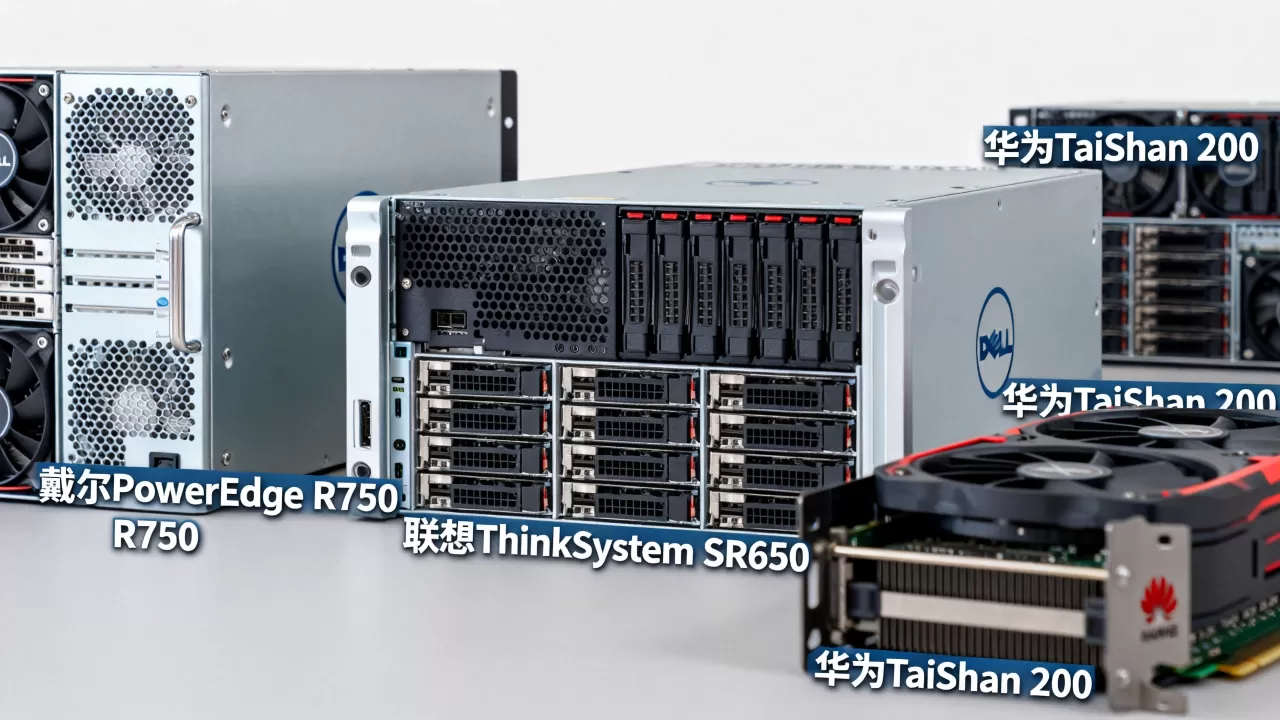
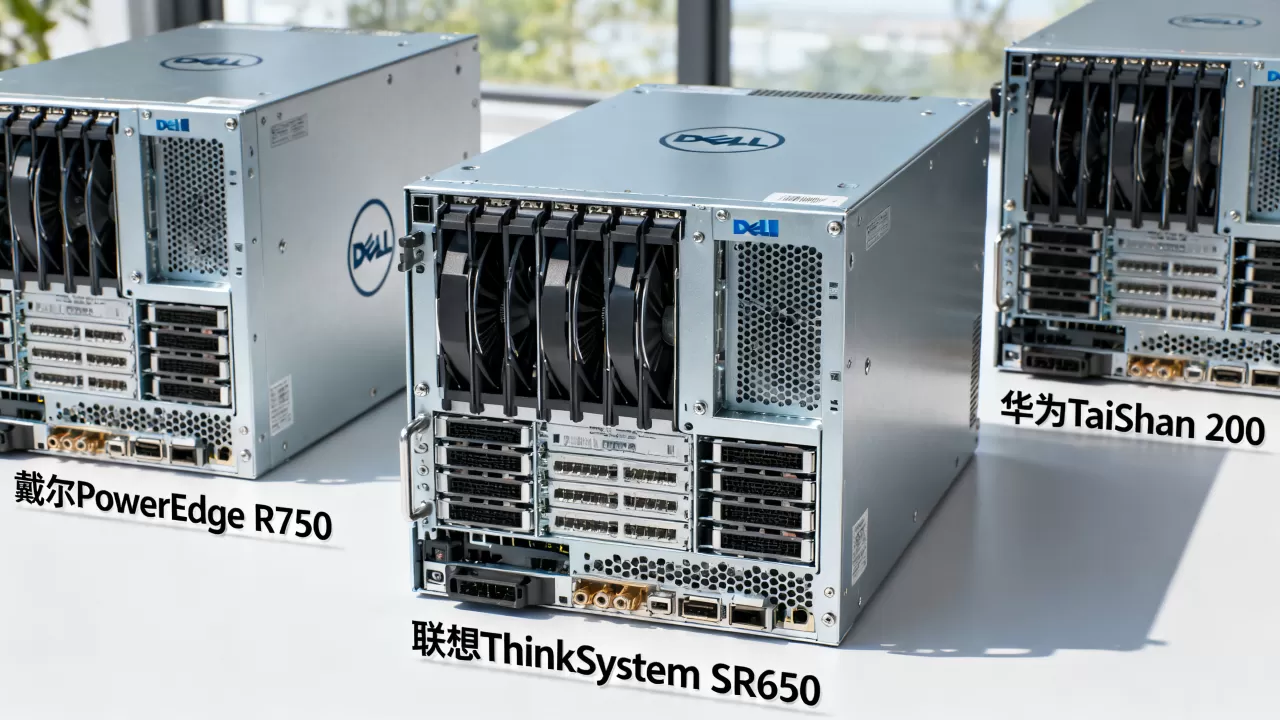
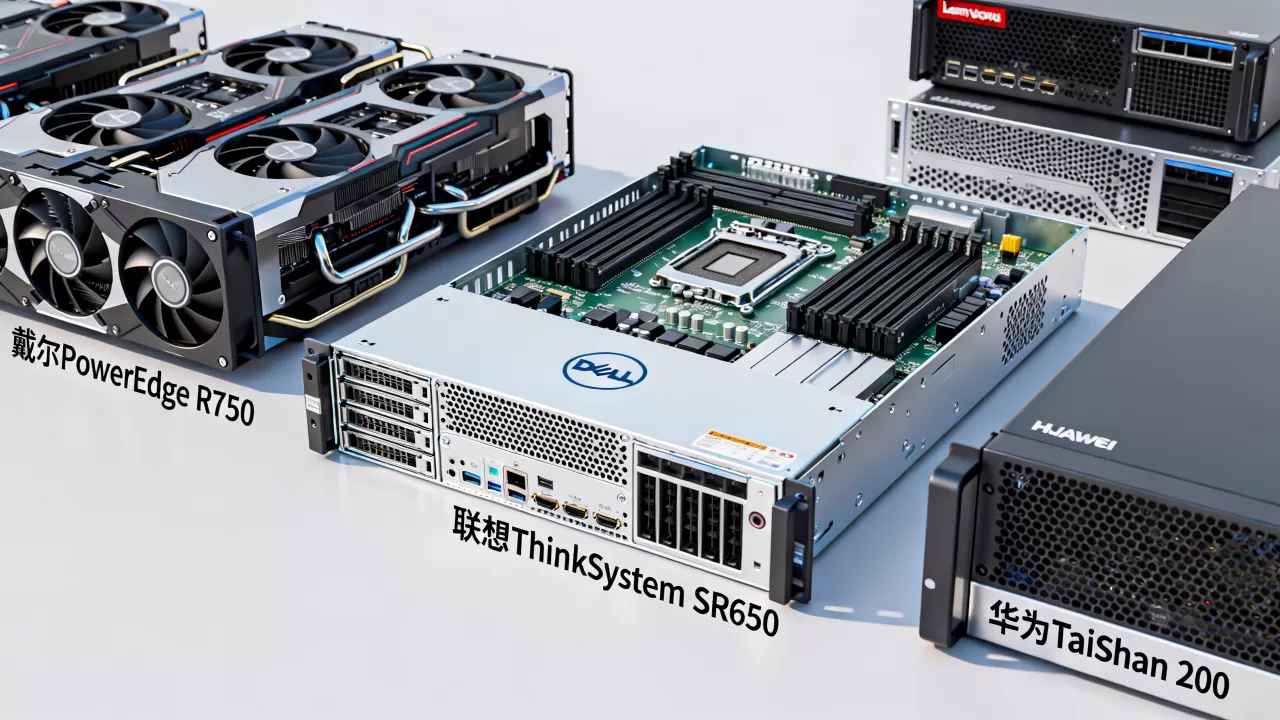
这是戴尔、浪潮、联想、超微这些大厂出的正规军,比如戴尔的PowerEdge R750xa、浪潮的NF5468系列,它们的特点非常鲜明,主板上预留了专门的GPU供电和散热通道,双路CPU加上8块全高全长显卡插槽,稳定性是组装机比不了的。
这类机器适合谁?对业务连续性要求极高的生产环境,比如医院影像识别、金融风控模型推理,行业共识是,品牌服务器的硬件故障率远低于兼容机,同时提供上门检修服务,价格往往是同配置组装机的1.5倍以上,而且这还没算额外的维保费用。
DIY组装GPU工作站(桌上小钢炮)
这是中小企业、算法工程师最爱的路子,自己买一张支持多卡的主板(比如华硕的WRX80系列)、一颗线程撕裂者或者至强CPU、两根大容量内存,再配上两张或四张显卡。
这里提到的“带显卡的服务器”,在DIY圈里通常特指GPU工作站准系统,你不需要机架式机箱,一台塔式机箱就能搞定,优点是配置极度自由,今天想加一张A100就加一张,明天想换RTX 4090也方便;缺点是散热压力全在自己身上,满负荷跑训练时,机箱内的热量堆积能让你怀疑人生,必须自己加装暴力风扇和水冷排。
云GPU服务器或托管(轻资产入场)
如果你只是跑个测试或者做短期项目,压根不用买物理机,国内主流的云厂商都有GPU云服务器出租,按小时计费,还有一种方式是机房托管,你自己买好带显卡的服务器硬件,放到IDC机房去租个机柜位。
这里要特别提一下GPU服务器托管价格,这是线下一线城市的小伙伴问得最多的问题,通常情况下,北京、上海的核心机房,单台4U服务器托管一年的价格在6000元到1.2万元之间,包含固定IP、100M带宽、24小时不间断供电和短信报警服务,算下来比自己在办公室开空调拉专线要划算得多,毕竟那电费账单是蹭蹭往上涨的。
深度学习服务器配置推荐:按场景选卡不交智商税
选显卡是整个环节里的重头戏,但很多人的误区是“贵的就是对的”,我们得把场景拆开来看。
训练型配置:显存容量是唯一的王道
做大模型预训练、微调的朋友,显存就是生命线,一张13B参数的模型做全参数微调,仅优化器状态就要占用大约40GB显存,所以行业里做深度学习训练,基本直接盯准NVIDIA的A100 80G、H100 80G以及即将大规模放量的H200。
- 预算充足,搞四卡A100,用张量并行跑7B模型毫无压力。
- 预算吃紧,退而求其次选RTX 6000 Ada(48GB显存),或者二手的A40。
- 绝对不建议用RTX 4090做多卡训练,因为它的NVLink被砍了,多卡通信全靠PCIe,带宽瓶颈会拖慢整体速度。
推理型配置:算力利用率比显存更关键
模型训练完了,部署上去做推理时,吞吐量是首要指标,此时显卡的单张算力未必需要顶配,但并发能力要强。
大多数企业在做深度学习服务器配置推荐时,会选择搭载TensorRT加速的L4或者L20显卡,L4的功耗只有72W,便宜且能塞进普通的2U机箱里,对于中小流量的在线问答机器人完全够用,如果是高并发场景,例如每秒上百次的图像识别调用,那建议直接上四张L40S,配合负载均衡,效果立竿见影。
渲染与仿真配置:专业卡和游戏卡的分水岭
搞建筑可视化、工业模拟和影视特效的团队,会明显感觉到游戏卡和专业卡在稳定性上的差异,渲染一张图可能看不出区别,但要连续渲染一周出片,专业卡的驱动优化和显存纠错能力就体现出来了,这里推荐NVIDIA RTX A5000或RTX 4000 Ada,它们通过了ISV(独立软件供应商)的官方认证,在3ds Max、Maya、SolidWorks里不会出现贴图闪烁的黑屏问题。
GPU服务器多少钱一台?预算分配要有主次
聊完了性能咱们说钱,没有“多少钱一台”的标准答案,因为显卡成本和整机其他配件的比例大概在7:3,所以在计算GPU服务器价格时,不如先看显卡行情。
全新整机的价格锚点
- 入门级(单卡RTX 4090 + 单路至强E5 + 64G内存):约在3.5万到5万元左右,适合小团队做本地大模型部署。
- 进阶级(双卡RTX 4080 Super + 双路银牌4314 + 256G内存):约在8万到10万元,可用于中等规模的模型微调和DIT数字人训练。
- 专业级(四卡L40S + 双路铂金8462 + 512G内存):这套已经属于企业级重型武器,裸机价格约在25万到30万元之间,还不包含并行文件存储的阵列柜。
二手硬件的隐秘角落
其实在闲鱼和各大服务器交流群里,大量的深度学习团队都在淘二手设备,戴尔的R740服务器准系统降价很快,甚至有人用几张改装的矿卡跑文本转图像大模型,这里是水最深的区域,二手卡的水洗板、维修板概率较大,除非你有稳定的货源渠道,否则不建议没有任何验货经验、纯靠看教程的新手轻易尝试。
GPU服务器租用和自建哪个好?长期账和短期账分开算
这个问题的本质是资金周转率的问题,很多人纠结了好几个月仍然拿不定主意,我帮你们把账本摊开算。
短期灵活租赁更适合开发测试期
如果项目的业务形态还没跑通,比如你正在研究怎么用扩散模型生成电商商品图,推荐直接租用按需付费的云GPU,许多主流云平台的单卡A10实例每小时才十几块钱,你跑完数据就释放,完全不占用现金流。
确定长期有业务需求时再自建
一旦模型调优完成后进入稳定期,日活用户开始呈现直线增长,租云主机的费用就会变得非常恐怖,此时把机器搬到机房做GPU服务器托管,或者直接放在公司内部跑,资产的长期折旧优势就会很明显。
一个真实的测算案例(模糊估算,仅供参考)
假设你的推理任务需要持续占用8张RTX 4090满负荷运转一年:
- 云服务器代金券减免后一年大概要花30万元左右。
- 自己购买两台4U的8卡服务器,连硬件带托管电费,一年总成本大概在20万元以内,且第二年硬件仍有残值。
前提是你有专门的值班人员处理硬件故障,如果团队里没人懂Linux底层驱动以及硬件调试,发现断电或风扇咔哒响都摸不着头脑,那用云厂商的托管服务其实更省心。
采购决策前必须避开的三个大坑
这里我要说点实在的行业经验,毕竟买带显卡的服务器的坑很深。
电源功率的坑,许多人以为自己买了个2000W的电源就足够了,但八张RTX 4090瞬间峰值功耗叠加起来能到3500W以上,在配置服务器时,建议电源总功率是整机满载功耗的1.5倍,否则显卡会频繁掉驱动,甚至触发主板过载保护导致系统重启。
CPU至强是否支持PCIe通道数,一张RTX 4090需要占用x16通道,你想要插满几张卡,就必须确认CPU到底提供多少条PCIe通道,比如酷睿i9的消费级CPU只有20条通道,插两张卡基本就到极限了,必须改用支持128条通道的至强W系列或者AMD线程撕裂者。
散热风道的坑,显卡如果横插在塔式机箱里,多卡并排的话卡背板间距就太近了,显卡风扇的吸风效率会大打折扣,核心温度直接冲向95度,实践操作中,典型方案是把显卡竖装在水冷散热托架上,或者是直接用涡轮风扇版的显卡(公版设计,风从一端吹向另一端)强制通风。
常见问题快问快答
带显卡的服务器和普通服务器有什么区别?
外观上的区别是这个箱子特别长、特别高,内部多了几百条供电线缆和巨大的散热鳍片,最关键的区别在于主板架构,普通服务器主要考虑内存带宽和磁盘I/O,而GPU服务器则是围绕PCIe交换芯片重新设计了拓扑结构,让CPU和GPU之间、GPU和GPU之间能通过高速总线去内存中直接交换权重数据,而不必每次都绕道操作系统。
深度学习训练,一张A100和四张3090哪个更好?
如果单看并发显存总量,四张3090的24GB显存明显碾压A100的80G,但在实际运行中,大模型训练需要多卡通信同步梯度,3090之间如果没有NVLink进行桥接,通信延迟会特别高,行业共识是,四张3090在数据并行模式下,其训练效率往往不如两张A100,且功耗发热极其感人,考虑了机房散热和电费成本后,A100的总体性价比反而更高。
GPU服务器需要多大的内存容量?
内存容量建议至少是显存总容量的一半以上,例如你要搭配四张80G显存的A100,系统内存最少要有256GB,这样后台开启数据加载器(DataLoader)时,CPU能提前把图片和文本的预处理缓存到内存里,避免GPU训练时频繁从固态硬盘读取数据而出现等待气泡。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/727600.html