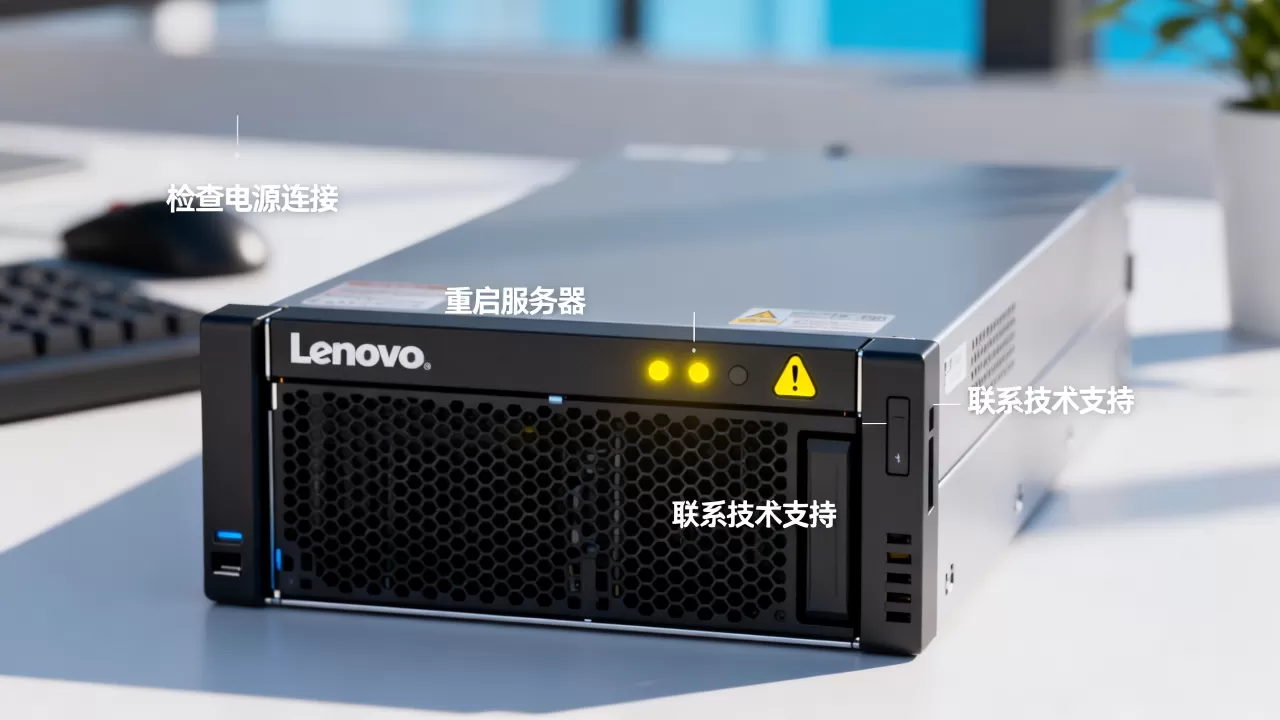
联想服务器感叹号亮黄灯,绝大多数情况是硬件预警信号,服务器并未立即宕机,但需要尽快排查处理。这个黄色感叹号灯在联想服务器上通常标记为“信息”或“非致命故障”指示灯,它的亮起意味着系统检测到某个组件状态异常,但尚未达到强制停机的程度,如果放任不管,小问题可能演变成硬件损坏或业务中断。
联想服务器亮黄灯怎么回事:先分清报警级别
联想服务器的指示灯系统有一套完整的颜色逻辑,不是所有黄灯都代表同样严重的故障,行业共识认为,服务器正面面板的指示灯通常分为电源绿灯、硬盘活动绿灯、以及故障黄灯/红灯,黄色感叹号灯亮起,对应的BMC(基板管理控制器)事件级别多数是Warning或Non-Critical,而红色指示灯才对应Critical级别。
开机自检阶段如果黄灯常亮,重点怀疑硬件自检未通过,系统运行中突然亮黄灯,则大概率是某块硬盘掉线、风扇转速异常、电源模块输入电压波动或温度传感器读数偏高,联想服务器在iBMC或XClarity Controller管理界面中,会对每条告警记录生成事件ID,例如LDC0001代表某个电源模块故障,LDIMM0008代表内存训练失败,这些事件ID是判断故障根因的最直接依据。
黄灯位置不同,故障指向完全不同
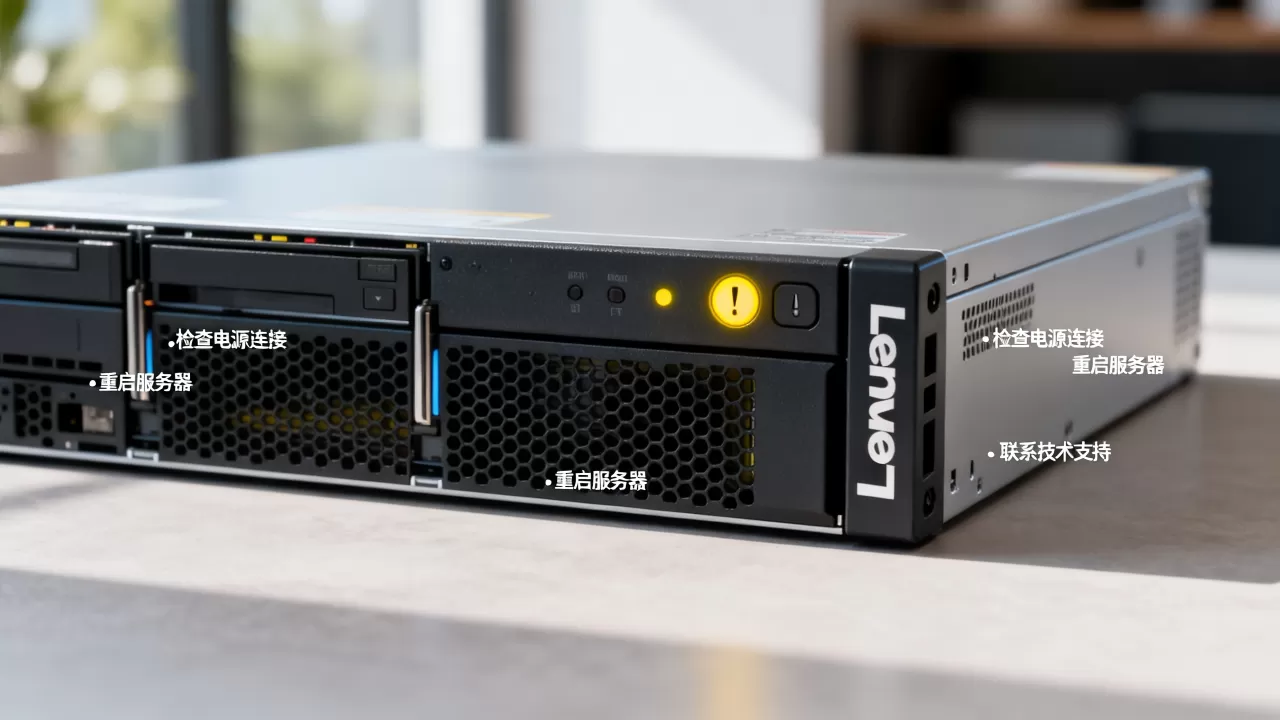
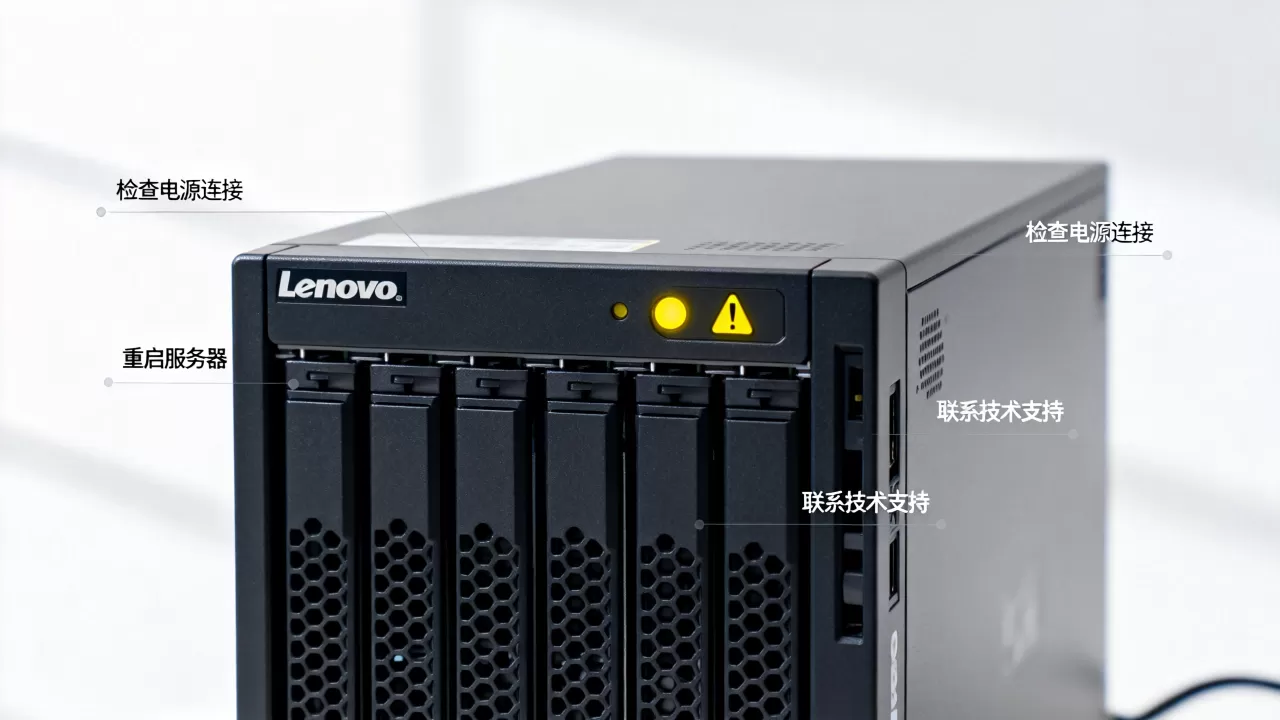
联想服务器前面板的设计中,黄色感叹号指示灯周围通常还有几个子状态灯:
- 硬盘指示灯亮黄灯:该盘位硬盘预测性故障或已被阵列卡踢出。
- 主板故障指示灯亮黄灯:内存、CPU或PCIe设备自检异常。
- 电源模块指示灯亮黄灯:双电源中有一个输入掉电或模块本身损坏。
- 风扇模块指示灯亮黄灯:对应风扇转速低于阈值或完全停转。
这里有个关键细节:联想ThinkSystem系列服务器(如SR650、SR550)的机箱导光柱,会把故障组件的指示灯直接映射到前面板,如果你看到机箱中部对应区域的黄灯亮起,能在几分钟内定位到具体组件,不用拆机盲查。
联想服务器黄灯报警解决方法:从日志定位到硬件替换
切记不要直接拔插硬件,随意复位或重启可能丢失BMC中的诊断快照,让故障信息无法追溯,正确操作路径是:先登录管理界面收集日志,再基于日志数据做硬件操作。
联想服务器标配的远程管理端口是专用的1GbE管理口,默认IP是168.70.125(部分SR系列出厂值),通过浏览器访问即可进入XClarity Controller界面,登录后依次查看“故障日志”和“系统事件日志”,筛选级别为“警告”或“严重”的事件记录,比对这些记录与黄灯亮起的时间点,就能锁定异常组件。
供电链路排查:最容易忽略的电源模块黄灯
联想服务器配置双电源时,如果其中一个电源模块的交流输入线松动或所在PDU(机柜配电单元)跳闸,该电源模块的琥珀色/黄色指示灯会亮起,同时前面板感叹号黄灯也会点亮,检查方法:
- 查看电源模块自身指示灯状态:熄灭无输入,绿色常亮工作正常,黄色闪烁待机故障。
- 在XClarity Controller的“电源管理”页面查看当前两个电源的健康状态。
- 如果电源模块侧面的标识显示“AC OK”灯不亮,多为输入线路问题,不是电源模块损坏。
多数情况下,重新插紧电源线或更换机柜插座后,黄色感叹号黄灯会在几十秒内自动熄灭,行业共识认为,由供电线路接触不良触发的服务器黄灯报警,占比接近服务器硬件告警的三分之一,不需要更换备件。
硬盘预测性故障:阵列卡黄灯和前面板黄灯同时亮
联想服务器搭载的RAID卡(如ThinkSystem RAID 930系列)会在检测到硬盘SMART属性异常时,主动向BMC上报“Predictive Failure”事件,此刻硬盘还能读写,但继续使用存在数据丢失风险,阵列卡管理工具(如StorCLI)能查看详细状态:
storcli /c0 /eall /sall show命令输出中,端口状态显示“UGood”且“Predictive Failure Counter”大于零,说明该盘已被标记为预测性故障,此时需尽快更换硬盘并重建阵列,如果所有硬盘状态正常,但黄灯依然在,检查RAID卡的BBU(后备电池单元)是否报“Learn Cycle Failed”,这类事件也会触发黄色告警。
内存和CPU排查:开机自检时的黄灯闪烁
如果联想服务器开机后自检到一半卡住,前面板黄色感叹号灯以固定频率闪烁,问题多出在内存或CPU供电电路,联想XClarity Controller的事件日志中,这类故障会记录为“Memory Configuration Error”或“CPU Machine Check”。
排查步骤:
- 如果是新增内存后出现的黄灯,大概率是新内存的Rank数量、容量或电压与原内存不匹配,优先调整插槽顺序。
- 如果服务器运行已久突然出现,将服务器关机断电,拆下所有内存,用橡皮擦清洁金手指,再逐条安装测试,联想服务器支持单条内存启动,每次只插一根内存,配合BMC日志的“POST”信息就能快速锁定问题内存条。
- CPU相关的黄灯告警,往往伴随风扇全速运转,日志中会记录CPU温度阈值越限或VRD(电压调节模块)故障,这类情况不建议自行处理,直接联系联想售后更换CPU或主板。
联想服务器故障灯排查实操:ThinkSystem和SR系列的常见差异
联想服务器目前主流在售的ThinkSystem SR系列搭载的BMC芯片是XClarity Controller,而较老的System x系列搭载的是IMM2或UEFI传统管理模块,两个平台的告警日志格式不同,排查逻辑有差异。
在ThinkSystem SR650上,查看黄色感叹号灯对应的告警,优先使用XClarity Controller的Web界面,它能在“事件”页面直接给出组件“症状”描述和修复操作建议,这点做得比传统IMM2更友好,老款System x服务器则需要在UEFI设置界面的“System Event Log”中翻找十六进制代码,例如IMM2事件编码0x7006代表电源背板故障,0x5007代表风扇模块缺失。
无论哪个系列,都需要注意固件版本一致性,联想官方维护公告多次提到,BMC固件版本过旧可能导致误告警,即硬件本身正常但指示灯误亮黄灯,建议直接到联想官网支持页面下载最新版XClarity Controller固件,升级后观察故障灯是否自动熄灭。
机箱内部积灰引发的温度类黄灯告警
长期运行且缺乏维护的联想服务器,容易因为灰尘堵塞散热风道,导致进风口温度传感器读数异常,进而点亮黄色感叹号灯,这属于环境类故障,但表现和硬件损坏非常相似。
排查方式:
- 登录XClarity Controller,查看“环境参数”页面中的进气温度、排气温度和CPU温度。
- 如果温度读数在正常范围(进气温度低于35℃,CPU温度低于85℃),但黄灯常亮,可能是温度传感器线缆松动。
- 如果温度偏高,打开机箱侧板检查防尘网和风扇叶片的积灰情况,使用高压气枪从内往外吹干净。
联想服务器风扇支持分区转速调节,CPU、内存、硬盘分别有独立的热传感器,积灰后风扇转速可能整体拉高,造成噪音增大,但系统日志中不会直接报“灰尘”类错误,只会记录“Temperature Sensor Upper Critical”事件。
网络和扩展卡告警:容易误判的模块化故障
联想服务器机箱后部的PCIe扩展槽区域,如果安装了GPU、万兆网卡或NVMe SSD扩展卡,这些板卡供电异常时,同样会触发前面板黄色感叹号灯亮起,与CPU、内存故障不同,这类告警在BMC日志中通常会标记为“PCIe Link Degraded”或“Option ROM Failed”。
实际处理中,遇到过网卡固件版本与BMC不兼容导致黄灯亮起的情况,刷新网卡固件后不再报错,因此遇到扩展卡相关的黄灯报警,优先升级固件、更换PCIe插槽位置,确认无效后再考虑退换板卡。
联想服务器黄灯亮但运行正常:需要立刻处理吗
服务器运行正常、业务未中断,但黄色感叹号灯常亮,这是故障预警尚未演变为故障停机的窗口期,此时无论业务多忙,都应该在当周安排维护窗口处理,如果服务器带的是单电源且出现电源告警,建议当晚就做业务迁移并更换备件。
具体处理优先级:
- 高优先级:电池或电容模块异常,如RAID卡缓存电池容量下降、主板纽扣电池电量低。
- 中优先级:单个风扇转速偏低但未停转,或某块硬盘SMART有非致命告警。
- 低优先级:室温传感器报警、机箱入侵检测开关松动、管理网口链路断开。
其中RAID卡缓存电池属于消耗品,寿命一般在3到5年,老化的电池会导致RAID卡写缓存策略自动切换为“Write Through”,明显拉低磁盘写入性能,联想服务器开机自检或在管理界面看到“Battery Needs Replacement”提示时,应尽快更换BBU模块,否则长期运行会增加阵列掉盘风险。
联想服务器售后维修电话与备件渠道的筛选逻辑
自己排查只能解决大部分逻辑层和供电层的黄灯告警,如果日志明确指向主板、背板或CPU损坏,自行维修风险偏高,特别是ThinkSystem SR系列主板涉及CPU引脚弯曲、BMC芯片加密绑定等问题,非专业工具很难处理。
联想服务器的备件渠道分几类:原厂续保服务、第三方维保公司、零售拆机件,不同渠道的价格差异较大,联想原厂服务价格较高但备件质量有保障,第三方维保公司价格约为原厂的五到七成,但维修周期受备件库存影响,选择第三方维保时,要求对方提供故障诊断截图和备件序列号,确认备件来源可追溯。
日常使用联想服务器的用户,建议关注以下几点:
- 保持BMC管理口连接在独立的运维网络中,不要和业务网络混在一起,避免管理口被扫描嗅探。
- 每月定时查看一次XClarity Controller的事件日志,对重复出现的警告事件做好记录。
- 配置邮件告警通知,BMC检测到硬件预估性故障时能第一时间推送给运维人员,避免黄灯亮了几天才发现的情况。
服务器黄灯报警并不可怕,可怕的是看到了却不做任何动作,任何硬件都有老化周期,预警机制正是联想服务器在设计时留给运维人员的“容错窗口”,利用好这个窗口期,大多数服务器故障都能在影响业务之前被解决,理性对待每一次告警,记录日志、了解组件、合理选择维修渠道,服务器才能持续稳定地承载业务。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/737041.html