4u8卡服务器的任务调度核心是:先让系统摸清8张GPU的互联拓扑与显存分布,再根据任务需求决定按整机分配还是按卡粒度切分,最后用调度器统一排队、隔离和分配资源。简而言之,把8张卡看作一个整体资源池,而不是各自为战的散装显卡,下面直接进入正题,聊聊调度怎么做、软件怎么选、实操怎么配。
4u8卡服务器任务调度有哪些方案可选?
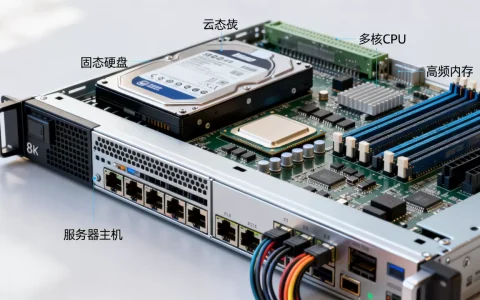
先说清楚一个容易混淆的点:4u8卡服务器指的是4U机箱里塞进8张GPU卡,常见于英伟达HGX或OEM整机,这类服务器自带NVLink全互联,8张卡之间的通信带宽远超PCIe单卡带宽,所以调度时如果把任务拆得太碎,反而浪费硬件设计初衷,行业共识认为,整机调度优先于单卡调度,除非任务规模确实不需要那么多并行度。
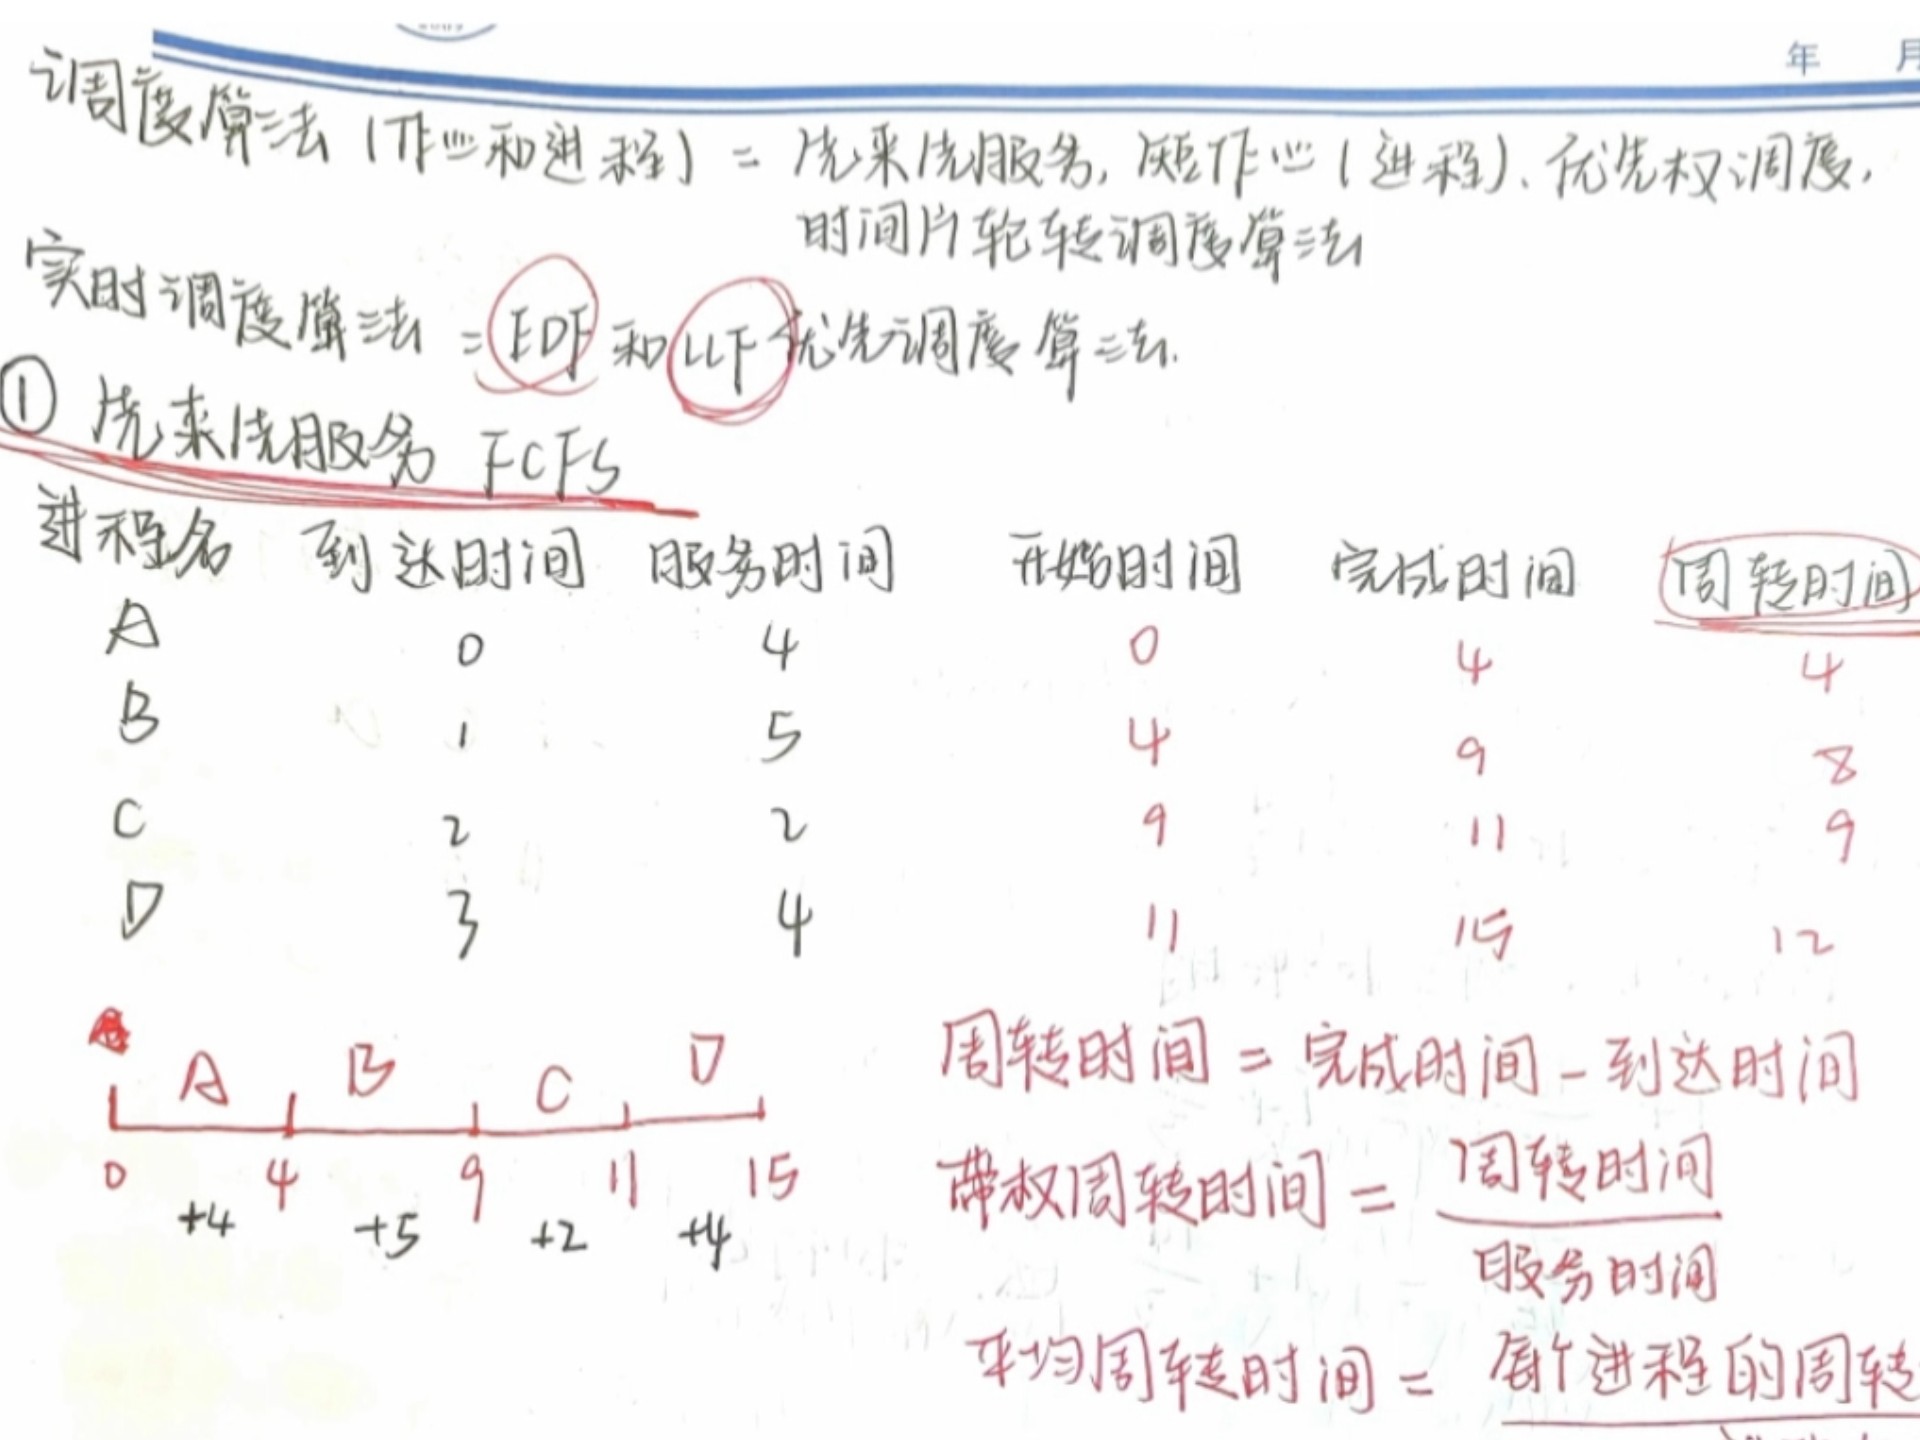

实际部署中,调度方案主要分三类:
- 共享型调度:多个训练任务同时跑在同一台机器的不同GPU上,适合中小模型、微调、推理服务混部场景,核心难点是显存隔离和算力抢占控制。
- 独占型调度:一个任务独占整台服务器的8张卡或其中某几张卡,适合大模型预训练、全参数微调、大规模数据并行训练,调度器只需要管好“哪些卡给哪个任务”即可。
- 混合型调度:白天跑推理服务,夜间跑大规模训练任务,通过时间片或队列优先级切换,很多企业会把白天交互式任务和夜间批量任务混在一台机器上。
选型时还需考虑卡型,如果是A100/H800这类大显存卡,多任务共享显存空间足够,切分调度收益明显;如果是L40S这类相对廉价但显存也够用的卡,国内不少AI公司会用它做推理混部。4u8卡服务器任务调度有哪些注意事项? 最大的一条是:不要把仅靠PCIe互联的卡与有NVLink的卡混在一套调度策略里,否则任务间的数据交换会让整机吞吐严重下滑。
4u8卡服务器调度软件怎么选:核心对比与配置实操
先上结论:Slurm是传统科学计算与高校实验室的标配,Kubernetes是云原生和在线推理平台更偏向的选择,Ray则适用于弹性计算和超参数搜索场景。4u8卡服务器调度方案对比在百度搜索热度和实际落地案例中,Slurm与K8s的争论最多。
下面这个表格直接说清楚差异:
| 调度器 | 最适合的场景 | 上手难度 | 多卡任务支持 | 混部机制 |
|---|---|---|---|---|
| Slurm | HPC训练、单机多卡任务、队列排队 | 较低 | 天然支持,通过–gres参数分配 | 较弱 |
| Kubernetes | 推理服务、弹性伸缩、容器化管理 | 中等 | 需配合NVIDIA Device Plugin | 较强 |
| Ray | 分布式计算、自动调参、轻量训练 | 低 | 需自行管理GPU分配 | 一般 |
从实际部署角度看,多数国内企业客户用Slurm + 容器镜像的方式,原因很简单:稳定、好排错、不需要额外引入运维复杂度,少数做推理平台的团队会把K8s作为底座,如果你面对的场景是“几十台4u8卡服务器组成GPU集群”,Slurm更有优势;如果只是单机或几台机器,K8s反而显得笨重。
以Slurm为例,配置一个8卡节点的关键步骤是打开以下设置:
# 在slurm.conf里定义节点资源
NodeName=gpu8-01 Gres=gpu:8 CPUs=96 Sockets=1 CoresPerSocket=48 ThreadsPerCore=2 RealMemory=500000 State=UNKNOWN
# 分区里默认按节点分配
PartitionName=gpu8 Nodes=gpu8-01 DefaultTime=12:00:00 MaxTime=7-00:00:00 State=UP
提交多卡训练任务时,命令行这样写:
srun --partition=gpu8 --gres=gpu:8 --ntasks=1 --cpus-per-task=32 --mem=100G docker_run.sh train.py
命令里的gres=gpu:8是告诉调度器“这个任务要占满整机8卡”,如果只想要4张卡,就改成gres=gpu:4,选4张卡时,调度器会自动分配排在前面的4个GPU编号,推荐配合CUDA_VISIBLE_DEVICES实现统一管理。
业内专家指出,一套配置良好的调度系统,排队等待时间的中位数应该控制在秒级到分钟级,如果单任务排队时间普遍超过20分钟,说明调度策略或队列配额设置不合理,需要重新调整。
4u8卡服务器集群是怎么把任务发下去的?三步走直接落地
第一步,确认拓扑与卡资源可见性,在系统里装好驱动和CUDA后,先跑以下命令确认所有卡都正常可见:
nvidia-smi -L
nvidia-smi topo -m
重点关注输出的NVLink行,确认8张卡是否都处于全互联状态,如果出现某张卡被标记为PIX或PHB,说明该卡可能插错位置或PCIe switch配置有问题,此时先用
nvidia-smi -pm 1固定性能模式,再检查主板的PCIe链路,多数情况下,重新插拔能解决接触不良导致的不识别。
第二步,规划资源配额并测试排队逻辑,假设你手上有2台4u8卡服务器,总共16张卡,并发跑2个8卡任务没问题,但如果同时来1个8卡任务和4个2卡任务,调度器需要决定谁先谁后,推荐的做法是在Slurm里建立两个分区:
gpu8分区:只接收整机8卡任务,用于大模型预训练;gpu-shared分区:允许单任务申请1-4张卡,用于推理或小模型调优。
把小任务全部赶到gpu-shared分区里,大任务优先占用gpu8节点空窗,这样能减少任务互相“堵车”的概率,也能保证训练场景的确定性,值得留意的是,小任务如果被调度到与8卡大任务同一台机器上,还会产生隐性的带宽竞争,因此调度规则要硬性隔离。
第三步,验证多卡通信是否正常,通过nvidia-smi topo -m看到互联关系后,进入容器跑通信测试:
torchrun --nproc_per_node=8 dist_test.py
测试脚本内部统计8卡之间的P2P带宽和延迟,如果出现明显的链路降速,就需要检查是否有驱动或固件降频问题,部分早期A800服务器在特定BIOS版本下会出现L2缓存未对齐的兼容性问题,刷新BIOS即可恢复。
4u8卡服务器调度优化与常见瓶颈排查
调度配置完成后,真正影响体验的是运行时的细粒度优化,列举几个高频问题的排查思路:
- 某张卡利用率特别低,其余7张卡满载:先检查数据加载框架是否支持异步DALI或
num_workers配置,任务负载不均时,优先看数据增强预处理是否变成瓶颈,其次是检查模型代码里是否有非均匀的张量并行配置。 - 显存爆掉或泄漏导致任务被杀:在启动命令里添加
--shm-size=32g并设置--ulimit memlock=-1来规避默认共享内存过小引起的OOM,如果训练中途还是爆显存,逐步把batch_size减半观察是否恢复稳定。 - 8卡任务刚启动时通信卡住:检查任务容器是否指定了
--ipc=host,没加的话Pytorch DDP的初始化阶段很容易在ring-allreduce握手时超时。 - 混部场景小任务抢大任务显存:在K8s场景下务必为每个容器设置

requests.limit
TaskPlugin=task/cgroup参数。
谈及“4u8卡服务器租用多少钱一个月”,这其实是很多中小团队关心的问题,按2026年公开市行情,一台配置A800-80G的4u8卡服务器月租金大致在三四万元到六七万元区间,L40S机型则普遍低一些,地域上北京机房靠近骨干网节点,报价高于二三线城市,但网络延迟更低,T4或老一代V100机型价格便宜不少,不过整体算力吞吐也会明显下降,如果预算有限,可以考虑“固定租4台整机+临时按需扩容”的混合方式,调度系统不变,靠增加节点池来应对高峰任务,这种方式已在不少中期AI团队中流行。
4u8卡服务器调度不好怎么办? 检查三个地方:第一,看是否有任务因为等待稀缺资源而长时间Pending,有的话调高队列优先级或降低资源请求量;第二,看是否出现频繁的GPU掉卡事件,通过dmesg排查NVML报错;第三,看是否业务方习惯固定使用某个GPU编号,这会人为制造资源碎片,建议一律通过调度器分配。
Q:4u8卡服务器和8u8卡服务器在调度上的核心差别是什么?
A:4u8卡多为单机8卡全互联,调度只需管理卡级资源;8u8卡通常是双机16卡互联,需要在调度器层面额外配置跨节点高速通信组和网络拓扑感知能力,复杂度明显更高。
Q:4u8卡服务器调度适合用Kubernetes吗?
A:适合,但要提前安装好NVIDIA Device Plugin,并设置nvidia.com/gpu的资源上限,否则容器可能超出物理显存导致调度器误判,稳定运营的核心是确保每个Pod显存请求和实际模型显存占用基本一致。
Q:4u8卡服务器任务调度有哪些现有成熟命令可以直接参考?
A:Slurm环境中最常用squeue查看排队状态,scontrol show job查看任务资源细节,sinfo -o "%n %G %C"检查各节点GPU资源和CPU状态,K8s环境中则优先使用kubectl describe node确认GPU数量,以及kubectl get pods -o wide确认任务分布情况。
4u8卡服务器调度的本质是:先约束资源边界,再提高排队效率,最后压榨单任务性能,无论你选择哪款调度软件,把这三步落实到位,整套集群的吞吐自然不会差,与其纠结软件生态的“高级功能”,不如把基础的拓扑检查、资源配额和任务隔离做好,这解决了大部分实际问题。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/743256.html