跨大洲匹配的转发链路延迟,优化重点不在压缩物理距离,而在于减少链路中的排队、绕路和重传时间。当玩家在纽约匹配东京服务器,或者国内业务访问巴西节点时,光速绕地球一圈也需要约134毫秒,这是物理下限,无法突破,真正的优化空间藏在路由策略、传输协议和节点部署方式里,下面按照“延迟从哪来怎么拆解实操路径场景对比”的顺序,把这件事说透。
跨大洲匹配延迟高的核心瓶颈在哪里
延迟不是单一数字,而是四个环节的叠加,物理传播时间只占一部分,更多问题出在链路的“不直”和“不专”上。

物理距离只是起点,路由绕路才是大头
跨大洲的数据包从上海到洛杉矶,直线距离约10400公里,光速在光纤中的传播速度约为真空中三分之二,这段路至少需要52毫秒,但现实中,数据包不会坐直线航班,它要经过海底光缆登陆站、运营商骨干网节点、区域汇聚点,每跳一层都会增加处理时间。
多数情况下,跨大洲延迟高的主因不是距离,而是路由绕路。 例如从中国内地到欧洲,部分运营商的路由可能先到美国西海岸,再跨大西洋到欧洲,这比直连亚欧海底光缆多出5000到8000公里的路程,行业共识认为,绕路造成的额外延迟通常在30到80毫秒之间,这比任何传输协议优化能带来的收益都大。
丢包重传是隐藏的延迟放大器
跨大洲链路损耗每增加1%,TCP传输效率就会明显下降,因为TCP协议要求数据包按序到达,一旦丢包,接收方会要求重传,而重传一个往返需要等待整整一个RTT,在150毫秒延迟的链路上,一次重传就额外消耗150毫秒,这直接导致游戏卡顿或文件传输速度骤降。
延迟高是结果,丢包才是雪上加霜的催化剂,优化路径的前两步,永远是先解决丢包,再解决绕路。
跨大洲链路优化方案对比:专线与公共互联网
针对跨大洲场景,实际可用的链路方案有四类,它们各有适用场景,成本和效果差异明显。
| 方案类型 | 延迟优化幅度 | 适用场景 | 成本区间 |
|---|---|---|---|
| 公共互联网直连 | 基准线 | 测试环境、无实时性要求 | 最低 |
| 国际专线(IPLC/IEPL) | 延迟降低20%-40% | 金融交易、企业核心业务 | 较高 |
| SD-WAN组网 | 延迟降低15%-30% | 多分支企业、云连接 | 中等 |
| 边缘节点中转+私有协议 | 延迟降低10%-25% | 游戏加速、实时通信 | 低至中等 |

这里有个关键认知:专线不一定比优化后的公共互联网快,但专线的稳定性远超公共互联网。 公共互联网在高峰时段会出现大幅抖动,而专线提供的是固定路径的带宽保障,对跨大洲匹配场景来说,稳定性比峰值速度更重要。
边缘节点中转为什么能优化跨国链路
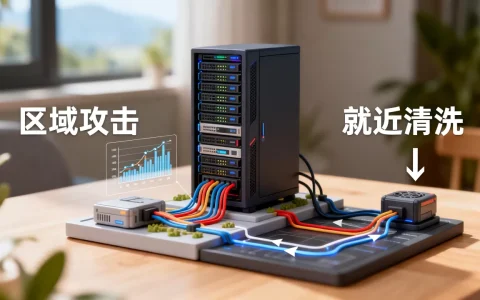
边缘节点中转是目前游戏加速和跨境业务最常用的手段,它的核心逻辑不是缩短物理距离,而是绕过糟糕的国际路由。
就近接入缩短“最后一公里”
客户端先连接到距离自己最近的边缘节点,这段路径通常延迟在5到20毫秒,边缘节点之间通过优化过的专线或优质骨干网互联,跨大洲部分走的是精心调度的最优路径,而不是运营商BGP自动选择的默认路径,用户侧到边缘节点的延迟被压缩到最低,跨大洲部分由服务商保证质量。
私有协议替代TCP避免队头阻塞
公共互联网的TCP协议在跨大洲高丢包环境下表现糟糕,游戏加速器普遍采用基于UDP的私有协议,例如简化握手、前向纠错、冗余包发送,这些协议可以在丢包率达到5%时依然保持流畅,而TCP在相同条件下几乎不可用。对玩家而言,延迟从180毫秒降到140毫秒可能感知不明显,但从断断续续变为稳定流畅,感知是颠覆性的。
跨境业务场景中,云服务商的全球加速产品也是同理,简米云、酷番云、AWS都提供全球加速服务,本质是在全球部署接入点,把用户流量导入优质骨干网,这类服务省去自建节点的运维成本,按流量计费,适合中小团队。
大洲间网络延迟优化实操路径
以下按步骤列出可执行的优化操作,从无成本到高成本排序。
第一步:先做延迟路径诊断
优化前必须知道瓶颈在哪,使用以下命令和工具收集数据:
- 用
traceroute查看从源到目标IP的每一跳延迟,找出延迟突增的路由节点。 - 用
ping或MTR持续监控至少24小时,记录丢包率、抖动值、平均延迟。 - 对比不同目标区域的IP:如果你要服务北美玩家,分别测试到洛杉矶、圣何塞、纽约、达拉斯的延迟,选择最优汇聚点。

若诊断结果显示延迟集中在国内到国际出口这一段,说明问题在运营商国际带宽拥塞,考虑换用优化链路,若延迟集中在中段(跨洋部分),说明路由绕路,考虑Anycast或中转节点。
第二步:按业务类型选择优化方式
实时性要求高的场景(如游戏对战、语音通话),优先选边缘节点中转+UDP私有协议,文件传输、数据同步类场景,可考虑专线或SD-WAN,这类场景对延迟不太敏感,但要求吞吐稳定。
第三步:调整传输层参数
如果用TCP且无法更换协议,至少做以下优化:
- 启用TCP BBR拥塞控制算法,该算法在高延迟高丢包链路上比默认的Cubic算法吞吐量提升显著。
- 增大TCP缓冲区大小:推荐将读写缓冲区设置为带宽延迟积(带宽×RTT)的1.5倍。
- 启用选择性确认(SACK)和窗口缩放(Window Scaling),减少不必要的重传。
以典型的20Mbps链路、RTT 200毫秒为例,带宽延迟积约为25MB,缓冲区至少要设置为这个数值的1.5倍,否则吞吐会被TCP窗口卡死。
第四步:部署全球加速节点
自建节点适合有一定技术能力的团队,大致路径如下:
- 在延迟最低的三个区域各买一台云服务器(例如东京、法兰克福、洛杉矶)。
- 服务器之间用支持UDP转发的工具建立隧道,或直接使用云服务商的专线互联产品。
- 客户端入口使用Anycast DNS或基于地理位置的解析,自动接入最近节点。
- 节点间传输使用KCP或QUIC协议,避开TCP的丢包重传问题。
这套方案的跨大洲链路优化价格因人而异,小流量场景每月几百元就能覆盖三台入门级云主机,大流量则需要按带宽计费,比起自建,直接用云服务商的全球加速产品更简单,价格约为每GB流量0.5到1.5元,写代码等于零。
各大洲之间的延迟基准参考
下面给出常见跨大洲区域的延迟参考值,注意这些是理想路由状态下的典型值,实际情况取决于海底光缆走向和运营商互联质量。
| 起始区域 | 目标区域 | 典型延迟范围 | 备注 |
|---|---|---|---|
| 中国东部 | 美国西海岸 | 130-160ms | 直连太平洋光缆 |
| 中国东部 | 美国东海岸 | 200-240ms | 需跨美西到美东 |
| 中国东部 | 欧洲西部 | 180-220ms | 部分路由绕道美国 |
| 东南亚 | 美国西海岸 | 110-150ms | 路径较直 |
| 澳洲 | 美国西海岸 | 140-170ms | 南太平洋光缆 |
| 南美东岸 | 欧洲西部 | 180-210ms | 跨大西洋光缆 |
| 南美东岸 | 中国东部 | 250-300ms | 几乎绕地球半圈 |

南美到亚洲是距离最远的组合,物理延迟就超过240毫秒,这个场景下的优化目标不是降低延迟,而是保证延迟稳定,避免抖动和丢包导致连接中断,游戏开发商在跨大洲匹配时,通常会把匹配延迟阈值放宽到300毫秒,并且设置带宽预估机制。
跨大洲匹配转发链路延迟优化常见问题
专线一定比公共互联网延迟低吗?
不一定,专线的主要优势在于路径固定、不经过公网拥塞点,延迟波动小,如果公共互联网当前的默认路由已经是最优路径,专线的延迟优势可能只有5到10毫秒,但在高峰时段或国际出口拥塞时,专线的稳定性优势会明显拉大差距,多数情况下,专线优化的是延迟的下限和一致性,而非绝对数值。
跨大洲延迟低于100毫秒可能实现吗?
在目前的海底光缆物理条件下,跨太平洋的物理延迟下限就超过110毫秒,跨大西洋约65毫秒,除非未来出现中继器更少的新型光缆或量子纠缠通信,否则跨大洲延迟低于100毫秒在天文学上就不可能,行业内更现实的目标是通过优化把有效丢包率降至0.1%以下,让链路延迟接近物理极限值。
小团队预算有限,最划算的优化方案是什么
最推荐的是购买云服务商的全球加速产品(按量付费),或租用三台轻量云服务器自建UDP隧道节点,前者无需运维,后者前期配置约半天工作量,两者都不需要签订年约专线合同,试错成本低,同样覆盖北美和欧洲场景,自建方案每月成本约为专线的十分之一,延迟差距通常在10毫秒以内,关键在于节点间协议选择,务必禁用TCP而采用KCP或QUIC。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/749316.html