100万HTTP连接云服务器能不能撑住,关键不在CPU核数,而在文件描述符、内存、连接模型、带宽计费和入口架构是否匹配。 单机想接住100万HTTP连接,通常要16核64G起步、内核调优到百万级FD,并用负载均衡做横向扩展;如果全是短连接高QPS,单机几乎不现实,必须上集群。
100万HTTP连接云服务器选什么配置?先分清连接类型
很多人买云服务器时只看“几核几G”,结果一压测就发现连接数上不去,问题往往出在连接类型没分清。

长连接和短连接,压力完全不同
- 长连接:客户端连上后保持复用,主要消耗文件描述符、内存和端口,连接数可以很高,但QPS不一定高。
- 短连接:每次请求都建连、断连,主要消耗CPU、TIME_WAIT端口和负载均衡新建连接能力,QPS高时,单机很难扛住100万连接。
如果业务是IM、推送、物联网心跳、在线协作,长连接居多,重点调内核和内存,如果是HTTP API、网页访问,短连接居多,重点做多台后端和四层负载均衡。
配置推荐表
| 连接规模 | 建议vCPU | 建议内存 | 网络 | 适用场景 |
|---|---|---|---|---|
| 10万-30万长连接 | 8-16核 | 32-64GB | 5Gbps内网 | 中小型推送、IM |
| 50万-80万长连接 | 16-24核 | 64-96GB | 10Gbps内网 | 物联网、消息网关 |
| 80万-100万长连接 | 24-32核 | 96-128GB | 10Gbps以上内网 | 大型网关、入口层 |
| 100万短连接高QPS | 多台集群 | 每台32GB起 | 负载均衡+多后端 | Web API、活动页 |
内存不要只算应用层,Linux内核为每个TCP连接维护缓冲区,应用层还有读缓存、写缓存、SSL会话,100万长连接占用的内存可能是数GB到十几GB,具体取决于收发缓冲区大小和协议,生产环境建议留出较大余量。
文件描述符是第一条硬门槛
Linux默认单进程打开文件数往往只有1024或65535,远不够100万,需要改:
ulimit -n 1048576
在/etc/security/limits.conf加入:
 soft nofile 1048576
 hard nofile 1048576
再调整内核参数:
cat >/etc/sysctl.d/99-million.conf <<'EOF'
fs.file-max = 2097152
net.core.somaxconn = 65535
net.ipv4.tcp_max_syn_backlog = 65535
net.ipv4.ip_local_port_range = 10000 65000
net.ipv4.tcp_tw_reuse = 1
net.ipv4.tcp_fin_timeout = 15
EOF
sysctl -p /etc/sysctl.d/99-million.conf
改完后用cat /proc/sys/fs/file-nr看已分配FD,用ss -s看TCP连接状态。
100万http连接云服务器价格多少钱?计费方式比配置更影响账单
同样叫“100万连接云服务器”,账单可能差很多,原因在带宽、负载均衡、公网IP和连接时长。
包年包月、按量计费和带宽计费怎么选
- 包年包月:适合稳定长连接业务,折扣通常更好,但突增扩容慢。
- 按量计费:适合压测、活动、临时扩容,弹性强,单价更高。
- 固定带宽:适合长连接心跳、流量平稳的业务,预算可控。
- 按流量:适合低频突发,但被刷流量时成本风险高。
- 负载均衡LCU:七层高并发下按连接数、请求数计费,长连接场景要重点估算。
行业里常见的情况是:实例费用看起来不高,带宽和负载均衡费用反而占大头,100万空闲长连接可能只产生少量心跳流量,但一旦业务推送、广播、同步,出口带宽会瞬间走高,选固定带宽还是按流量,要看峰值模型。
华南地区100万连接云服务器推荐?地域与线路怎么选
如果用户主要在华南,优先看广州、深圳地域,华南到广州内网时延低,BGP多线接入对电信、联通、移动用户更友好,华北可选北京,华东可选上海、杭州,跨境业务看香港、新加坡,但要接受更高时延和合规要求。
地域选择看三点:
- 用户分布:就近接入,减少RTT。
- 可用区:至少跨两个可用区,避免单点故障。
- 线路:BGP多线优于单线,单线便宜但跨网体验差。
高并发HTTP连接云服务器怎么优化?内核与应用一起调
配置买对只是开始,调优决定能不能稳定跑住,业内专家指出,百万连接瓶颈更多出现在文件描述符、内存回收和网卡中断,而不是CPU主频。
Nginx与反向代理配置
Nginx作为入口时,要同时考虑客户端连接和上游连接,反向代理下,一个客户端连接可能占用两个worker连接。
worker_processes auto;
worker_rlimit_nofile 1048576;
events {
    worker_connections 262144;
    multi_accept on;
    use epoll;
}
http {
    access_log off;
    keepalive_timeout 75s;
    keepalive_requests 100000;
}
如果4个worker,每个262144连接,理论总连接上限约100万,但还要留出上游连接、健康检查和管理连接余量,生产环境更稳的做法是:云负载均衡承接公网100万连接,后端Nginx集群分摊,每台只跑20万到30万连接。
监控与压测
ss -tan state established | wc -l:看已建立连接数。ss -s:看TCP统计摘要。cat /proc/sys/fs/file-nr:看FD使用量。nstat -az | grep -i tcp:看TCP重传、丢包。wrk -t16 -c50000 -d60s http://target/:多台压测机分布式压测。
压测100万连接时,单台压测机端口不够,需要多台压测机,并调整net.ipv4.ip_local_port_range,不要用生产环境直接压,先在预发环境验证。
应用层连接模型
- Go:netpoll适合高并发长连接,注意GOMAXPROCS和内存回收。
- Java:Netty的boss/worker线程模型成熟,注意直接内存和GC停顿。
- Node.js:适合IO密集,但单进程CPU受限,需要多进程加负载均衡。
- Rust/C++:资源效率高,但开发成本高。
行业共识认为,入口层要能横向扩展,单机只作为成本单元,不要迷信单机百万连接,SLA要求高时,集群比单机更可靠。
100万并发连接云服务器和物理服务器对比,谁更合适
云服务器优势是弹性、按量、运维托管、快速交付,物理服务器优势是单机性能强、网络稳定、长期成本可控,短周期项目、流量波动大,选云服务器更灵活,长周期、连接模型稳定、预算充足,物理服务器或混合架构更合适。
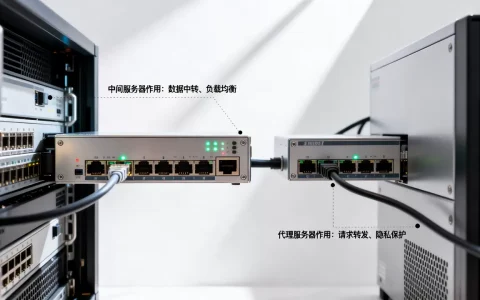
真正影响选择的不是“云还是物理”,而是连接时长、带宽模型、故障恢复时间和团队运维能力,100万HTTP连接场景下,常见架构是:云负载均衡 -> 多台云服务器/Nginx -> 应用集群 -> Redis/消息队列,核心结论是,把100万连接当成系统目标,而不是单台机器的采购目标;配置、内核、带宽、计费和架构一起算,才能稳定又省钱。
Q&A:100万http连接云服务器常见问题
100万HTTP连接需要多大带宽?
长连接空闲时,心跳包很小,带宽需求低,但业务数据突发时,出口带宽会快速上升,按峰值QPS乘以平均响应大小估算,再留余量,固定带宽适合流量平稳,按流量适合突发,但要防刷。
100万http连接云服务器用Nginx还是LVS?
四层用LVS或云NLB,抗连接强,转发效率高,七层用Nginx或云ALB,功能多,能做路由、鉴权、限流,常见组合是云NLB/CLB -> Nginx -> 应用,Nginx的worker_connections要覆盖客户端和上游连接总和。
100万http连接云服务器和物理服务器对比,哪个成本低?
云服务器弹性强、按量付费、运维托管,适合短周期和波动业务,物理服务器单机性能强、长期成本可控,适合稳定长连接网关,短周期选云,长周期稳定选物理或混合,最终账单取决于带宽、连接时长、SLA和地域,需按实际压测与计费模型测算。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/753612.html