服务器CPU使用过度被锁死时,第一时间通过管理后台执行强制重启恢复业务,随后登录系统排查进程和日志定位根因,最后根据负载类型决定是优化代码还是升级配置。这个结论来自长期运维一线的实操经验,下面按从紧急到预防的顺序拆解完整处置流程。
服务器cpu使用率过高怎么排查:三步锁定元凶
CPU被打满通常不是瞬间发生的,多数情况下是某个进程失控或流量异常,重启只是治标,排查才是治本,进入系统后按以下顺序操作。
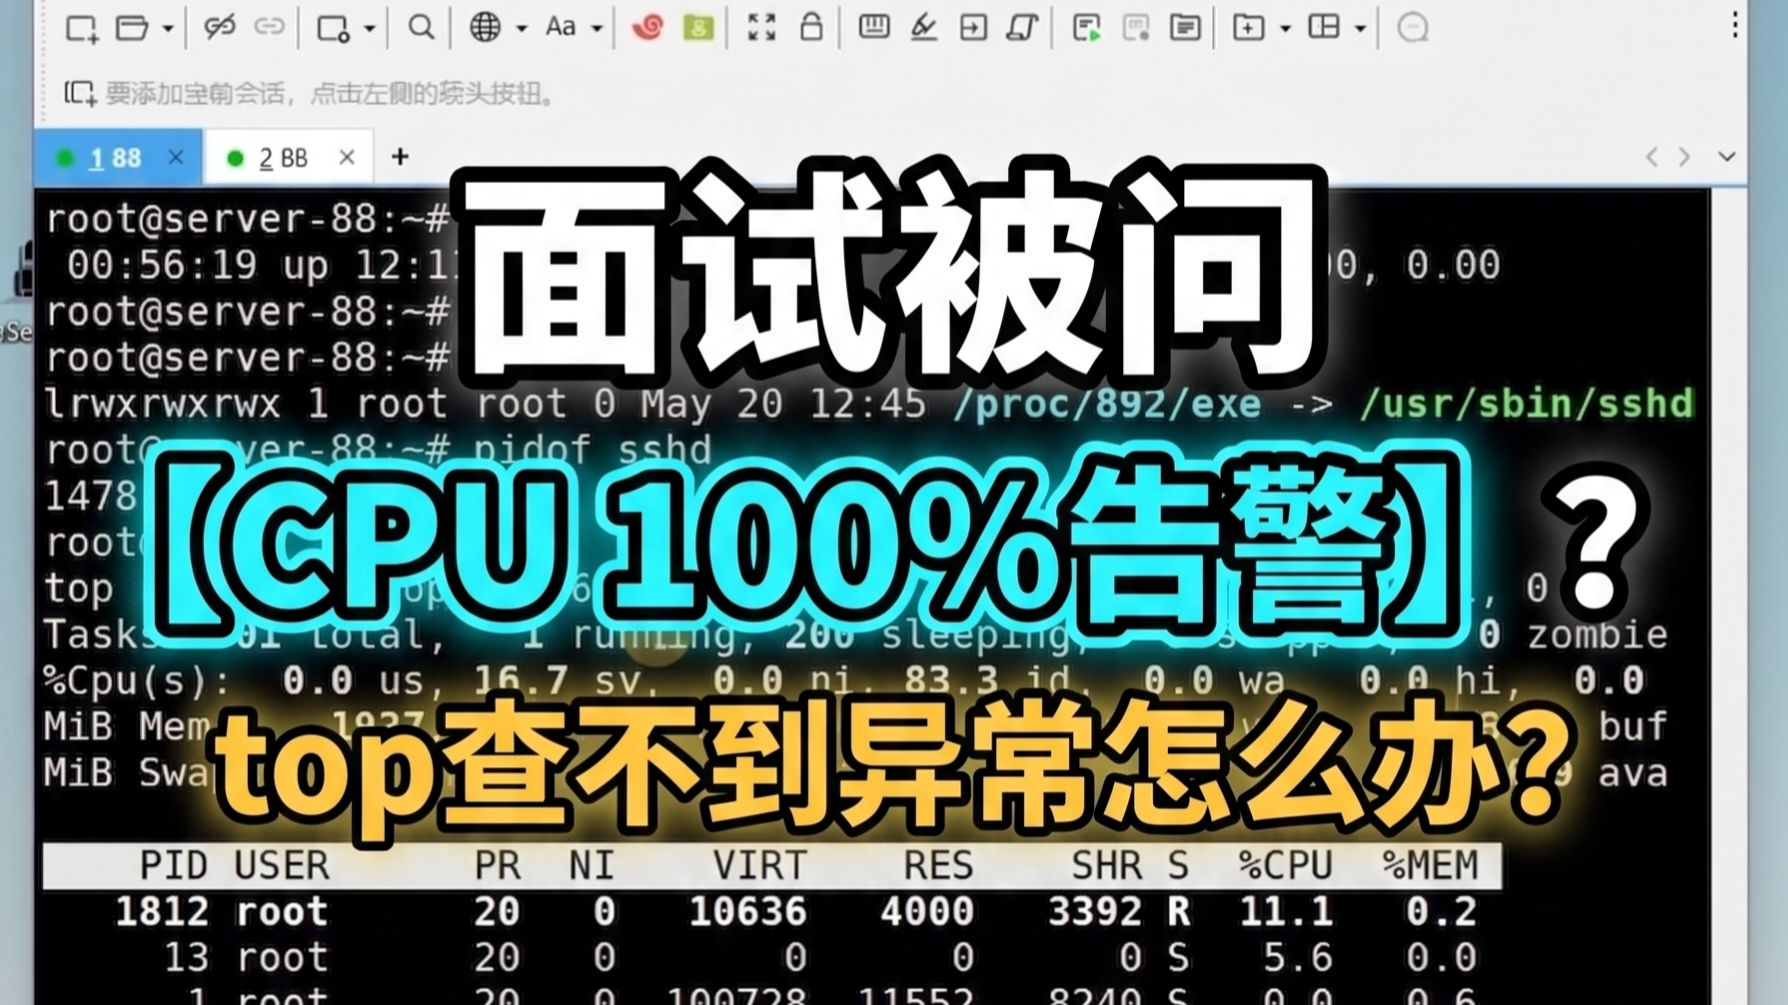
先用uptime和top看整体负载趋势
执行uptime查看1分钟、5分钟、15分钟的负载均值,如果1分钟远高于15分钟,说明是突然涌入的突发负载;如果三个数值都高且接近,说明已经持续运行在高位。
接着运行top,按P键让进程按CPU占用率排序,这一步能直接看到占用最高的进程PID和它的CPU百分比,常见元凶有三类:PHP-FPM或Java进程失控、MySQL慢查询堆积、被入侵后的挖矿进程。
用ps和lsof定位具体进程的“身份”
top看到了PID还不够,需要知道这个进程是谁拉起来的,执行:
ps -ef | grep [PID]
输出会显示完整命令行,如果看到curl或wget拉取的陌生二进制文件,大概率是挖矿木马,如果命令路径在/tmp或/var/tmp下,基本可以判定为恶意程序。
对MySQL这类数据库服务,用lsof -p [PID]查看它打开了哪些文件,能判断是慢查询在扫全表还是日志文件异常膨胀。
查系统日志确认锁死前发生了什么
CPU锁死前的几十秒内系统通常会有残留信息,执行dmesg -T | tail -50查看内核日志,关注OOM(内存溢出)或进程被kill的记录,再用journalctl --since "10 minutes ago"查应用日志,重点找报错堆栈或超时记录。
服务器cpu满载自动锁死怎么解决:先恢复再根除
自动锁死通常是因为系统配置了CPU软锁检测,或者内核触发panic后自动重启,但恢复之后如果不做调整,很快会再次锁死。
临时恢复:强制重启的正确操作
大多数云控制台提供“强制重启”按钮,这相当于长按电源键,能绕开系统卡死的状态。裸金属服务器则只能通过IPMI或带外管理口操作,IDC机房的服务器需要联系机房值班人员协助,地域上如果是托管在本地机房的,建议提前确认机房是否有24小时远程重启能力。
重启后第一件事不是继续跑业务,而是禁用可疑的服务,用systemctl list-units --failed查看异常服务,有异常的先systemctl disable停用。
防止再次锁死的系统级调优
内核层面可以启用软狗机制,修改/etc/sysctl.conf:
kernel.watchdog = 1
kernel.nmi_watchdog = 2
这样内核卡死时能自动重启,避免长时间业务中断,同时检查/etc/security/limits.conf,确认进程数和文件句柄数限制是否过小,过小会导致进程频繁创建失败而陷入死循环。
如果重启后仍然快速打满
说明问题不是偶发,而是持续存在的负载,此时需要决定是云服务器cpu突然打满需要紧急升配,还是业务本身存在性能瓶颈,建议先在业务低谷期用perf top看热点函数,如果热点集中在PHP解释器或Java GC线程,说明代码层有优化空间;如果热点在系统调用层面,则考虑加CPU核数。
把CPU占用压下来的实用手段
排查出原因后,针对不同场景采取对应措施,多数情况下不需要立刻花钱升级,先试软件层面的优化。
代码层减负:缓存优先,循环让路
- 加一层Redis或Memcached,把数据库查询结果缓存起来,减少重复计算
- 检查是否有正则表达式处理大文本的逻辑,这类操作极耗CPU,改用字符串函数替代
- 定时任务脚本里避免用
while true做轮询,改成sleep间隔更长的设计 - 框架层面的Debug日志在生产环境务必关闭,日志写入本身是CPU杀手
业内专家指出,Web类应用通过缓存优化通常能降低30%-50%的CPU空转消耗,这个属于行业共识。
架构层分流:把请求拆开
单台服务器扛不住全部流量时,考虑在Nginx层做按路径分流,把静态资源请求直接丢给CDN,动态请求才转发到后端,同时开启Gzip压缩,减少传输体积的同时也降低了CPU处理带宽的占用。
什么时候该升配,怎么选不花冤枉钱
优化做到位了CPU还是长期70%以上,说明硬件确实跟不上业务增长,这时候别急着拍板,先算清楚账。
先判断瓶颈是核数还是主频
| 负载类型 | 推荐侧重 | 参考场景 |
|---|---|---|
| 高并发短请求 | 多核数 | Nginx、Web前端 |
| 单线程重计算 | 高主频 | 数据分析、视频转码 |
| 混合型负载 | 均衡配置 | 常规业务服务器 |
如果你的进程都是单线程应用,加核数没明显效果,反而是换更高主频的CPU有感知,用top看%Cpu(s)行里的us和sy比例,sy高说明内核态吃得多,优先扩容;us高说明用户态密集,先看代码和架构。
云服务器和托管服务器的升级成本对比
云服务器升配的操作路径很简单:控制台里点“变更配置”即可,按小时补差价,即时生效,国内主流云厂商的2核4G升级到4核8G,价格差异按月计算较大比例在几十到一百多元区间,带有地域差异,一线城市节点通常贵一些,但延迟更低。
托管服务器则需要考虑硬件采购和机房上架成本,升级周期是数天到数周
,如果业务增长快且波动大,优先选择云服务器cpu弹升能力;如果业务稳定且对数据主权要求高,买断式硬件长期成本更划算。
日常预防:三个月一次的体检清单
CPU锁死很少发生,但每次发生都代价高昂,养成定期检查的习惯比学会急救更重要。
月度检查项:
top查看持续一周的CPU峰值记录sar -u查看CPU使用率的分布趋势- 检查
/var/log/messages里是否有异常错误 - 确认系统内核和关键软件包有安全更新
季度检查项:
- 测试一次强制重启演练,确认带外管理可用
- 复核
sysctl.conf里的保护参数是否生效 - 评估业务增长曲线和CPU余量的匹配度
服务器CPU锁死常见问题解答
问:服务器CPU 100%但业务量很低,是怎么回事?
最可能是被植入挖矿程序,攻击者利用漏洞将木马注入系统,先执行top找到高占用PID,再用ls -l /proc/[PID]/exe查看可执行文件路径,删除文件并清理crontab和/etc/rc.local残留项,最后修改服务器密码和数据库密码。
问:云服务器CPU突然打满,怎么快速判断是否需要升配?
先查看监控图表,区分是持续打满还是波形打满,波形打满通常与定时任务重合,属于业务代码问题;持续打满才考虑升配,切换到按量付费模式临时升配测试,确认升配后QPS有线性提升,再改为包年包月,避免一次性投入后效果不明显。
问:强制重启会不会损坏数据?
会丢失内存中未落盘的缓存数据,但不会损坏已写入磁盘的文件,MySQL或Redis这类内存型组件,重启后依赖日志进行恢复。日常做好定时备份是唯一能对冲重启风险的手段,建议同时开启云快照和异地备份两种策略。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/754675.html