两台MySQL服务器做数据同步,最实用、最成熟的办法就是配置主从复制,简单说就是让一台做主机(Master)写入数据,另一台做从机(Slave)实时拷贝主机的操作记录来保持数据一致。
MySQL主从复制的核心原理
主从复制的本质是逻辑日志的搬运工。 主机上发生的每一次数据变更,比如INSERT、UPDATE、DELETE,都会记录到本地的二进制日志文件(binlog)里,从机通过一个专门的IO线程连接主机,把这些binlog拉取过来,写进自己的中继日志(relay log),然后再通过SQL线程把中继日志里的操作在自己库上重放一遍,整个过程是异步的,但延迟通常在毫秒级别。

这套机制的好处非常明显:读写分离、数据备份、故障切换全都指望它,对于绝大多数中小型业务场景,比如网站、小程序后台、企业内部系统,两台服务器的MySQL同步用主从复制完全够用。
MySQL主从复制配置详细步骤
很多人一听到配置同步就觉得头疼,其实关键步骤只有五个,只要按顺序操作,别跳步,基本一次就能成功。
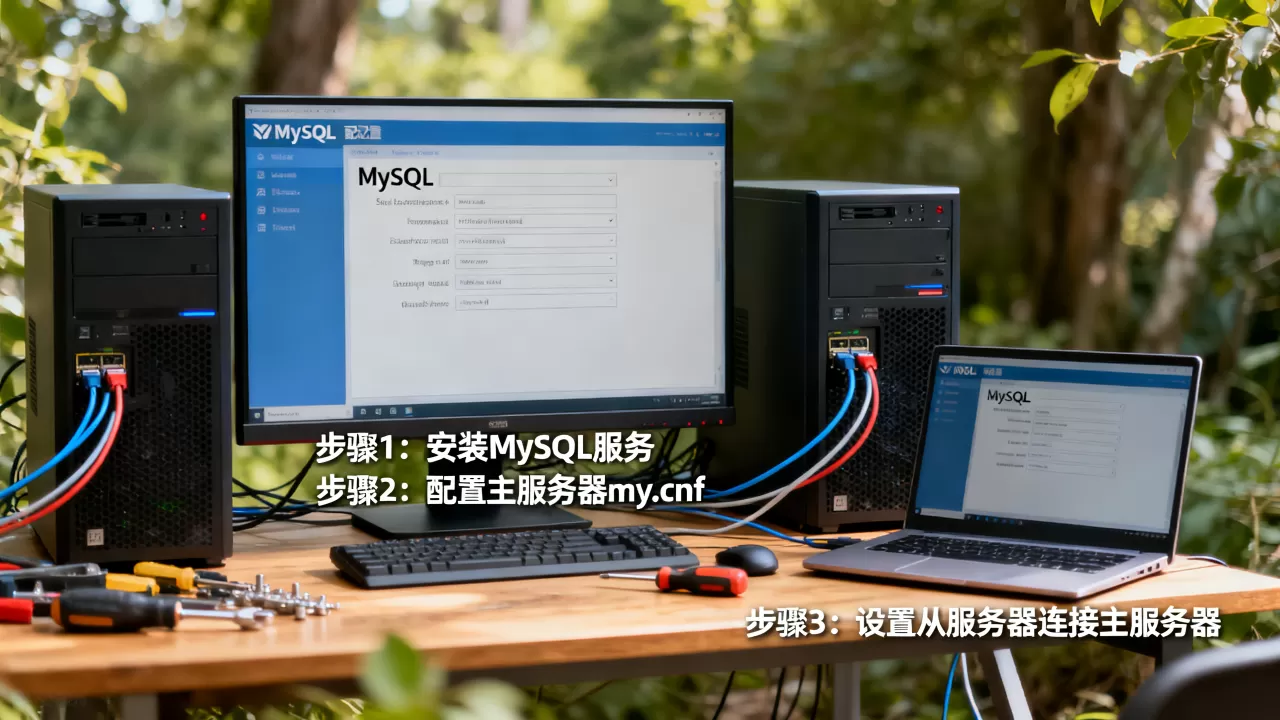
第一步:修改主机配置文件
先找到主机的my.cnf(或my.ini)配置文件,在[mysqld]段落下加入以下几行:
[mysqld]
log-bin=mysql-bin
server-id=1
binlog_format=row这里有个细节要注意:server-id必须唯一,两台机器的这个值绝对不能一样,否则同步会报错,binlog_format=row是基于行的复制,比默认的statement模式更安全,不会因为函数或存储过程导致主从数据不一致,改完配置后,重启主机的MySQL服务。
接下来验证binlog是否正常开启:
SHOW MASTER STATUS;
这条命令会返回一个文件名和位置偏移量,比如mysql-bin.000003、154。记下这两个值,后面配置从机时要用。
第二步:创建专用同步账号
不能让从机用root账号来拉日志,在主机上创建一个权限受限的复制账号:
CREATE USER 'repl'@'%' IDENTIFIED BY '你的强密码';
GRANT REPLICATION SLAVE ON . TO 'repl'@'%';
FLUSH PRIVILEGES;
账号建好以后,顺手确认一下主机的防火墙是否放行了3306端口,如果两台服务器在不同机房或者有安全组策略,这一步容易卡住。
第三步:准备初始数据
这一步是很多人容易遗漏的坑。如果主机上已经有一堆业务数据,而新从机是空库,直接开启同步会导致从机数据不完整,甚至复制直接报错。
稳妥做法是:先在主机上执行FLUSH TABLES WITH READ LOCK;把表锁住,然后用mysqldump导出一份完整数据:
mysqldump -uroot -p --all-databases --master-data=2 > backup.sql
--master-data=2参数会自动把binlog的文件名和位置写进备份文件头部的注释里,你不需要手动去记,导出完执行UNLOCK TABLES;解锁,然后把backup.sql传到从机上导入。
第四步:配置从机并启动同步
编辑从机的my.cnf:
[mysqld]
server-id=2
relay-log=mysql-relay-bin
read_only=1read_only=1很重要,它让从机只接受来自主机的写入,防止应用误连从机后直接改数据导致主从不一致,重启从机后导入备份数据,然后执行:
CHANGE MASTER TO
MASTER_HOST='主机IP',
MASTER_USER='repl',
MASTER_PASSWORD='你的密码',
MASTER_LOG_FILE='mysql-bin.000003',
MASTER_LOG_POS=154;
START SLAVE;
注意:如果你的备份文件是用--master-data=2导出的,可以不用手动指定MASTER_LOG_FILE和MASTER_LOG_POS,直接用CHANGE MASTER TO配合备份头部的注释填即可。
第五步:验证同步状态
在从机上运行:
SHOW SLAVE STATUSG;
重点关注两个字段,这两个字段的值必须都是Yes:
- Slave_IO_Running:IO线程是否正常连接主机拉取日志
- Slave_SQL_Running:SQL线程是否正常执行中继日志里的操作
看到两个Yes后,在主机上建一张测试表插入几条记录,去从机上看能不能查出来,能查到就说明主从同步链路搭建成功了。
MySQL主从同步延迟的根因排查
生产环境里几乎所有人都会遇到延迟问题,日志显示 Seconds_Behind_Master 越来越大,业内专家指出,延迟的根源绝大多数不在网络带宽,而在于从机单线程的SQL回放扛不住主机的高并发写入。
常见原因
- 主机写入并发太高,从机的SQL线程来不及消化
- 从机上跑着大查询,长期占用CPU和IO资源
- 一条大事务,比如一次性DELETE掉几百万行,binlog被拆成海量小事件在从机上逐步执行
- 从机磁盘性能差,比如机械硬盘跟不上SSD
怎么处理
处理思路有几种:
- 如果延迟是间歇性的,不用过度紧张,主库闲下来后从库会逐渐追平
- 如果延迟是持续性的,确认从机的磁盘、CPU没有瓶颈后,最直接的办法是换更强的从机硬件
- 升级MySQL 8.0版本,8.0.23以后支持并行复制,回放性能有显著提升
- 把从机的
sync_binlog和innodb_flush_log_at_trx_commit调到0或2,能降低磁盘刷盘压力,但要注意从机宕机时可能丢部分数据
对于大规模高并发场景,单个从机跟不上,常见的做法是一主多从的架构,把读流量再分散到多台从机上,能明显缓解单台从机的回放压力。
MySQL双主同步方案与主从复制的对比
有人会问,两台服务器不想分主从,想让两边都能写,能不能做双向同步?技术上可以做双主复制,但业务上要非常谨慎。
双主复制的逻辑
双主模式下,A和B互为主从:A的binlog发给B,B的binlog也发给A,配置方法和上面类似,只是两边都要开启binlog,两边都要建复制账号,server-id分别设为1和2,理论上任何一个节点写入,数据都会同步到另一台。
光有双主是不够的
但需要知道,双主复制解决了数据冗余,解决不了写冲突,比如应用连接A和B同时修改同一条ID的记录,两边各自写入自己的binlog,同步到对端时冲突就会爆发,MySQL自己不会自动合并冲突,只会导致同步线程报错中断或者数据覆盖丢失。
行业共识认为,除非业务能保证同一行数据只在一个节点写入,否则不应该让两台MySQL同时承担写流量,电商平台的双主架构,底层都配了分库分表规则或中间件来强行隔离写路径,没有这个前提,老老实实做一主一从是最省心的选择。
还有一种折中方案是半同步复制,半同步和异步的区别在于:主机提交事务时,至少要等一台从机确认收到binlog才返回成功,这样能大大降低主机宕机丢数据的风险,MySQL自带的半同步插件在5.7和8.0版本里都能方便地启用:
INSTALL PLUGIN rpl_semi_sync_master SONAME 'semisync_master.so';
SET GLOBAL rpl_semi_sync_master_enabled = 1;
配置在半同步模式下,MySQL主从数据同步的可靠性相比普通异步有了明显提升,在高可用架构里很常用。
主从切换时机的判断与操作
服务器总有一天会出问题,主机突然宕机了,业务不能一直挂着,在主从架构下,把从机提升为新主机的操作叫故障切换。
怎么判断该切换了
不是从机一看不到主机的状态就要马上切换,切换本身也有成本,比较典型的切换信号是:主机持续无心跳、应用连主库开始报错、或者监控系统探测不到主机的3306端口,如果只是主机负载抖动了几秒钟,马上切过去反而容易造成脑裂。
切换的具体操作
-
在从机上执行
STOP SLAVE;,停止复制线程 -
执行
RESET SLAVE ALL;清掉复制关系 -
把从机改成可写,去掉
read_only=1的约束 -
应用侧把数据库连接地址改到这台机器上
-
如果原主机能恢复,需要把它降级成从机,挂到新的主机下
这里有个重点:切换之前一定要确认从机的数据已经追平主机,判断方法是在主机宕机前对比SHOW SLAVE STATUS里的Seconds_Behind_Master是否为0,如果从机还差一大截数据就强制切换,业务数据会回滚一大段,这个损失可能比宕机本身还要大。
防止脑裂的推荐方案
如果预算允许,更稳妥的方案是给两台服务器加一台仲裁服务,比如基于MHA或者Orchestrator做自动切换,仲裁服务能通过独立网络探活,避免出现两个节点互相认为对方挂了、两边同时对外提供写服务的脑裂情况,不少团队的实践证明,手动切换在半夜发生故障时非常考验运维人员的临场反应,提前把自动化切换脚本写好并演练过,比临时抱佛脚靠谱得多。
场景化建议:什么时候用同步,什么时候别用
数据同步不是银弹,两台MySQL之间做复制,有它适用的场合,也有根本不该硬上的情况。
适用场景包括:
- 业务流量有明显读写比,比如论坛、博客、内容管理后台,读多写少,用读写分离分担主库压力
- 需要一份近实时的冷备数据,主库物理机和从库物理机放在不同机架或不同可用区,降低单点故障风险
- 做报表分析、数据统计类的查询,全部打到从机上,避免慢查询拖垮主库
不适合的场景包括:
- 两台服务器网络质量很差,延迟超过几十毫秒,而且经常抖动,复制会频繁掉线
- 两个机房距离非常远,跨地域的同步延迟不可控,对实时性要求高的场景不能用普通的异步复制
- 业务本身要分库分表,MySQL同步没法解决跨库的数据一致性问题,需要引入分布式数据库中间件
如果你只是要临时把数据迁移到另一台服务器上,跟持续同步是两个概念,迁移可以用mysqldump加
--single-transaction,或者用Percona XtraBackup做物理备份还原,物理备份更省时间,因为它在文件层面拷贝数据,不用一条条重放SQL。
MySQL两台服务器同步中容易踩的操作雷区
配置过程中稍微疏忽一步,后面排查就能花掉半天。
skips网络层:两台服务器的MySQL如果开了skip-name-resolve,主机上的账号授权就不能用域名,防火墙也要放行,否则IO线程一直连不上。
不要随便改主机已有行的binlog格式:如果你在主机上中途改binlog_format,已经产生的binlog还是旧的格式,从机也可能因为格式变化导致回放失败,改格式前先重启一下主从链路,让两边都在新格式下工作。
从机的server_id不能被别的实例占用:现在很多公司用容器化部署MySQL,如果网段内还有其他实例的server_id正好和你新建的从机重复,复制时会出现”相同server-id的服务器互相干扰”的报错。
注意字符集统一:主从两边的character_set_server最好一致,如果主机是utf8mb4,从机是latin1,中文数据同步过去后就乱码了,导备份文件前在命令行里加上--default-character-set=utf8mb4参数,能少一个坑。
常见问题解答
两台服务器的MySQL一定要版本一致才能同步吗?
不需要完全一致,MySQL允许主从版本不同,一些项目会用5.7做主库,8.0做从库,平滑升级,但要注意跨大版本复制时,8.0默认的认证插件和SQL模式如果和5.7差异过大,可能出现账号连不上或者复制报错,建议版本差距不要太大,做任何跨版本同步前先在测试环境做一轮模拟,确认没有兼容问题再上生产。
两台服务器之间做MySQL同步会不会把主机拖慢?
会有一点影响,但正常情况下影响很小,主机端需要额外做的唯一一件事情就是把二进制日志写到磁盘上,如果你原来没开binlog,开了以后会有额外的IO开销,但对大多数业务来说,这个开销相对于SQL执行本身的成本可以忽略,真正会拖慢主机的是你设置了sync_binlog=1,每次事务提交都要强制把binlog刷到磁盘,日志量很大时IO压力会上去,可以在数据可靠性和性能之间取一个平衡点,适当调整刷盘频率。
主从同步的从机能直接拿来当备份用吗?
可以,但前提是要加上备份流程,从机上的数据是实时变化的,如果哪天误操作在主机上删了一张表,从机也会在秒级内把这张表删掉,因此从机可以承担备份职能,但还需要配合周期性全量备份和保留binlog来保证可恢复到任意时间点,比较常见的做法是每天凌晨在从机上用mysqldump导出一份全量备份,同时备份binlog文件,保留最近7到30天,这样既能减轻主库备份压力,又有完整的数据可回溯。
两台MySQL服务器的数据同步,本质上就是把binlog从一台搬到另一台,再把操作重放一遍,配置过程没有玄学,关键点就落在账号、server-id、初始数据一致、状态验证这四个环节,走完一遍流程后,接下来要考虑的是做好延迟监控和切换预案,主从复制能覆盖大部分业务对数据冗余和读写分离的需求,但如果未来的数据规模继续上涨,就要提前考虑分库分表或者引入更成熟的数据库高可用架构了。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/759000.html