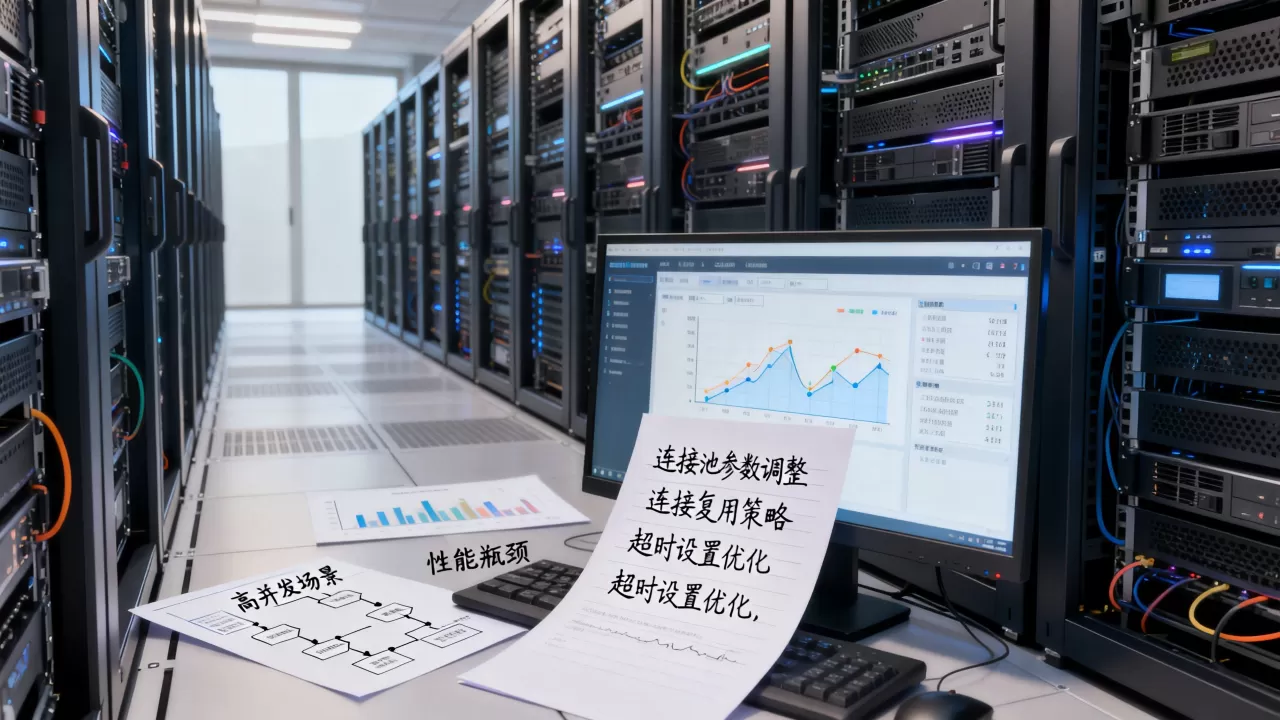
不要迷信“越大越好”的固定公式,先定位真实瓶颈,再按“等待-复用-检测-监控”的顺序调校连接池参数,并配合线程池、读写分离和压测验证。连接池就像食堂的取餐窗口,窗口太少排队超时,窗口太多反而挤占厨房资源,真正的高手是先看清哪些窗口空转、哪些窗口占着不出餐。
高并发下连接池为什么先崩溃
交易系统的峰值流量和普通网站完全不同,普通电商的峰值是“慢”,交易系统的峰值是“挤”行情刷新、下单请求、风控校验、订单查询,多个业务在毫秒级同时抢数据库会话,数据库连接池的默认配置通常是10到20个连接,这套配置在低并发下完全可用,一但每秒请求量冲到几百甚至上千,问题立刻暴露。
连接池打满的典型过程:前端请求进入应用线程,线程向连接池申请连接,池内没有空闲连接,调用线程进入等待队列,等待超过阈值后,业务侧直接抛异常,用户看到的就是“系统繁忙”或“下单失败”,此时数据库侧的压力反而不高,CPU和IO还留有余量,崩溃点完全在连接池的等待策略和池容量上。
数据库连接池打满怎么排查
遇到打满问题,先别急着改参数,多数生产环境下的排查步骤是固定的:
- 先看监控面板的活跃连接数和等待线程数,区分是“池不够大”还是“连接被占住不放”。
- 用
show processlist或select from information_schema.processlist查看数据库侧的真实会话状态,重点看Time列超过5秒的线程在做什么。 - 检查应用日志中的连接获取超时异常,异常信息里通常带
connectionTimeout的具体数值,能直接反推配置情况。 - 看慢查询日志。慢SQL是连接池打满的最大隐形杀手,一条1秒的慢查询,在200并发下能瞬间吃掉所有连接,这时候扩大池容量只会让问题更隐蔽。
行业共识认为,连接池调优的难点不在参数本身,而在于业务侧代码里的连接泄漏和慢查询治理,这两类问题不解决,调大连接池只是把风险往后推迟。
连接池参数怎么调才有用
调优必须落在具体参数上,不同数据源参数名称有差异,但核心逻辑一致,这里以最常见的HikariCP为例,对比主流配置项的作用:
连接池大小设置多少合适
“连接池大小设置多少合适”没有统一答案,但有一个可执行的计算起点:
核心业务的平均事务耗时 × 每秒事务峰值 × 安全系数。
业内专家指出,多数交易系统的连接池初始值建议按cores × 2 + 磁盘转速系数来估算,机械硬盘环境加1,SSD环境不加,假设一台8核物理机,预估QPS在600到800,单事务耗时约20ms,那么合理池大小在30到50之间,低于20容易在瞬时波峰被打满,高于100则线程调度和上下文切换开销会吞掉收益。
- HikariCP中设置
maximumPoolSize=50,minimumIdle=10,避免频繁创建销毁连接。 - Druid中对应的是
maxActive和initialSize,功能等价但参数命名不同。 - c3p0的
maxPoolSize逻辑类似,但这个库更新节奏慢,新项目已经较少使用。
下表给出常见数据源的关键参数对应关系:
| 参数含义 | HikariCP | Druid | c3p0 |
|---|---|---|---|
| 最大连接数 | maximumPoolSize | maxActive | maxPoolSize |
| 最小空闲数 | minimumIdle | minIdle | minPoolSize |
| 获取连接超时 | connectionTimeout | maxWait | checkoutTimeout |
| 空闲回收周期 | idleTimeout | timeBetweenEvictionRunsMillis | idleConnectionTestPeriod |
| 连接存活检测 | validationTimeout | validationQueryTimeout | testConnectionOnCheckout |
等待时间和超时时间怎么配合
连接池的等待超时时间比最大连接数更容易被忽略,却是问题爆发时决定服务质量的关键。connectionTimeout建议设置在1000ms到3000ms之间,超过3秒的等待对交易操作来说几乎等同于超时失败。
- 下单接口的等待超时设短一点,建议1000ms,宁可快速失败返回“稍后重试”,也不要让用户等很久。
- 批量查询或对账类操作的等待时间可放宽到3000ms,这类任务允许排队。
idleTimeout的设置要确保小于数据库侧的空闲超时值,MySQL的wait_timeout默认8小时,但部分云数据库默认60秒,如果连接池的空闲时间设置大于数据库侧回收时间,会出现“应用觉得连接还活着,数据库已经断开”的假连接问题。
预热和回收机制
连接池冷启动是交易系统发布时的隐藏坑,新节点加入后,连接是逐步起来的,前几分钟的流量就可能把刚创建的连接全部占死。
- 在启动阶段通过
initializationFailTimeout和最小空闲连接数,强制预创建一定数量的连接。 - 在应用启动脚本或健康检查阶段,主动执行一次轻量查询,让连接池完成“热身”。
- 连接泄漏检测要开启,HikariCP的
leakDetectionThreshold设置为10000ms,超过这个时间未归还的连接记录到日志中。
交易系统高并发连接池调优的配套手段
连接池从来不是孤立组件。只调池参数而不动线程池和数据库访问模式,调优效果会大打折扣。
线程池和连接池如何配合
交易系统普遍有线程池模型,比如Tomcat的maxThreads或业务自定义的Executor,一个常见误区是线程数无限大于连接池数,假设线程池200个线程,连接池只有40个,那160个线程在等待连接上干耗,线程栈内存被白白占用,响应时间整体恶化。
推荐比例是线程池大小与连接池大小接近或略高,差值控制在1.2到1.5倍,连接等待时间长的业务,差值调小;纯计算密集型业务,差值可以调大。
读写分离落地路径
多数交易场景的读请求量是写请求的3到5倍,把这些读流量引到从库,连接池压力直接减半。
- 主库连接池维持写入和事务型查询,配置偏向高可靠性。
- 从库连接池可以适当小一些,但
connectionTimeout要更短,因为读请求本身执行快,等待超过500ms就是明显的异常。 - 大事务和长事务必须拆分出去单独处理,单个事务长时间占用连接,等于同时占用线程和数据库资源,用
PROXY或者中间件拦截超过5秒的事务请求并告警。
缓存如何减轻连接压力
热点数据的缓存命中率是连接池的“空气质量指标”,行情快照、用户基础信息、可转债涨跌幅这类数据,60%以上的查询场景命中缓存,连接池就会非常从容。
- Redis缓存优先缓存读多写少的静态维度数据。
- 本地缓存(如Caffeine)进一步拦截高重复率的查询。
- 数据库查询尽量带分页和字段裁剪,避免
select从网上把全表数据拉到应用层。
数据库连接池监控与压测验证
参数调完之后,必须用监控数据说话,否则所有调整都是“感觉更顺了”。
监控项和告警阈值
连接池不是一个静态指标,高并发下的合理状态是“连接数有波动,但不触顶”。
- 监控活跃连接数趋势,长时间保持在高位关联业务侧是否存在慢查询或跨服务调用堵塞。
- 等待获取连接的平均耗时超过200ms就值得关注,超过500ms在交易系统中已经属于“用户可感知卡顿”。
- 连接池创建和销毁频率突然升高,多半是空闲回收时间配置过短导致的抖动。
- 借出连接的平均使用时长,正常情况下应该小于业务自身耗时,出现“借出时间远大于业务耗时”的情况,先查嵌套事务和未关闭的结果集。
压测怎么压才真实
从压测到上线,至少要覆盖三类场景:常规流量、正常峰值的1.5倍、诡异突发(消息积压后同时消费),建议用生产环境的数据模型,写入模拟行情数据,按真实交易的请求比例混合测试。
- 压测开始后,先观察连接池的使用率曲线,而不是只看TPS。
- 逐步调小连接池大小寻找拐点,找出“TPS不再增长,但连接数还在上升”的位置,这个位置附近就是当前硬件和SQL条件下的最优池大小。
- 压测结束后多留10分钟观察连接回收情况,确认没有连接泄漏。
有条件的团队建议把连接池参数做成配置中心下发,配合监控告警做A/B对比验证,今天多花半小时做压测,明天凌晨就不用来处理线上事故。
Q&A:连接池调优常见问题
为什么调大了连接池,高并发下反而更慢了?
调大连接池会抬高线程并发度,大量线程同时抢占CPU和数据库锁资源,数据库连接是一种昂贵资源,连接越多,锁竞争和上下文切换越频繁,连接池应当保持在“刚好满足峰值需求”的水平,而不是“留足余量”,先排查慢查询和长事务,再去动池大小。
数据库连接池最大连接数多少合适?
一个可执行的上限参考公式是磁盘核数×2 + 30,比如8核机器,上限在46左右,如果这个数值还不够用,优先优化SQL和拆分流量,不要在单库上继续堆连接资源,监控数据中的“等待连接时间”持续下降且池内活跃连接仍未触顶,说明当前配置已经贴近最佳状态,最终验证标准是压测过程中数据库侧CPU使用率保持在60%-70%区间且无等待超时,调优即完成。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/764474.html