RedHat 6服务器崩溃后,先别急着重装系统,第一时间通过带外管理口(如iLO/IDRAC)强制重启,同时准备同版本镜像盘和备用宿主机,按“先保数据、再复业务”的顺序处理,绝大多数情况能救回来。
redhat6服务器崩溃怎么处理:第一步永远是冷静定位
很多朋友一看到redhat6服务器崩溃,手心先冒汗,这台老机器承载着公司核心业务,没有快照,没有备份,连安装镜像都找了半天,行业共识认为,RedHat 6的崩溃场景多数是内核panic、根文件系统损坏、磁盘故障或内存条松动导致的,系统本身并没有彻底“死透”。

区分“真崩溃”还是“假死机”
- 屏幕无输出、电源灯亮、风扇狂转:大概率是硬件级故障或内核死锁,先强制断电,注意等30秒再上电。
- 屏幕有报错但卡在某个进程:例如等待设备超时、I/O错误刷屏,说明内核还活着,优先尝试通过SSH或带外控制台诊断。
- 能进单用户模式但无法正常启动:说明引导链或关键服务出了问题,这是最好处理的情况。
先通过iLO、iDRAC或IPMI连接服务器控制台,观察最后几行报错信息,强制重启是第一步但不是唯一一步,重启前如果能截屏保存崩溃日志,对后续根因分析价值很大。
RedHat 6系统层崩溃的修复路径
如果RedHat 6能开机但进不去系统,或者进系统后反复重启,按照下面顺序排查。
通过单用户模式修复损坏的文件系统
开机时在GRUB菜单按e进入编辑模式,找到kernel那一行,在末尾追加single或1,按b启动进入单用户模式,这个模式下网络服务不启动,文件系统以只读方式挂载,执行以下操作修复根分区:
mount -o remount,rw /
vi /etc/fstab检查fstab里是否有错误挂载项,特别是使用了UUID的云硬盘或LVM卷,如果系统提示“Superblock last mount time is in the future”,多半是系统时间错乱,手动把时间校准再重启,修复文件系统后,统一执行umount -a && reboot平滑重启。
xfs和ext4文件系统崩溃的修复手法
RedHat 6默认支持ext4,部分环境用了xfs,对于ext4文件系统损坏,使用e2fsck -y /dev/sda1自动修复,不要手动输入yes去逐条确认,费时还容易漏,xfs文件系统则用xfs_repair -L /dev/sda1,注意这个命令有风险,会清空日志,但能救回大部分数据。
关键系统服务启动失败导致反复重启
比如/etc/rc.d/rc.local
里写入了错误脚本、SELinux上下文紊乱、udev规则冲突等,进入单用户模式后,逐步排查:
- 执行
getenforce查看SELinux状态,临时用setenforce 0关闭测试 - 查看
/var/log/messages尾部日志,定位最后失败的服务 - 用
chkconfig --list | grep on确认异常开机启动项,用chkconfig 服务名 off关闭
根分区满了导致系统假死
RedHat 6的老机器日志管理粗放,/var分区被日志塞满非常常见,系统能起来但执行命令极慢,或者干脆卡在登录界面,用单用户模式进入后执行df -h查看,如果或/var使用率达到95%以上,清理大日志文件:
find /var/log -type f -size +100M -exec ls -lh {} ;
cat /dev/null > /var/log/messages
RedHat 6硬件层故障的判断与应对
软件层面排查完,就要考虑硬件了,RedHat 6服务器常见群体是2010年到2015年部署的物理机,硬件老化导致的崩溃比例相当高。
内存故障导致的内核panic
如果崩溃时屏幕上出现Oops、Machine Check Exception或反复重启,优先怀疑内存条,关闭服务器,拔掉所有内存条,用橡皮擦擦拭金手指,重新插拔一遍,如果有多根内存条,逐根测试,同步在BIOS里开启内存自检。
RAID卡故障导致系统无法识别磁盘
很多redhat6搭建的服务器用的是硬RAID卡,崩溃后开机提示No boot device available,别急着认定硬盘坏了,进入RAID卡配置界面(通常是Ctrl+R或Ctrl+H),查看阵列状态,如果是虚拟磁盘Offline,尝试重新插拔硬盘让阵列自动重建;如果提示Foreign状态,先导入外部配置,此前不少运维试过,导入配置后系统盘数据原样回来。
磁盘坏道导致系统卡在开机检测
服务器硬盘运行多年出现坏道并不罕见,开机卡在Checking filesystems或ata1.00: exception Emask,说明系统盘已经有物理坏道,你可以尝试把系统盘用dd工具镜像到新硬盘上,但这一步成本较高,如果手里有备用盘,直接装双盘做软RAID1,保证后续数据安全,这是比较稳妥的做法。
redhat6服务器崩溃数据恢复方案
如果以上步骤都走不通,系统彻底起不来,就要启动数据救援流程了。数据恢复优先级永远高于系统恢复。
用LiveCD或同版本救援模式抢救数据
下载RedHat 6的DVD镜像,制作启动U盘或挂载到虚拟光驱,选择
Rescue installed system进入救援模式,这个模式下系统会尝试挂载原硬盘分区,挂载成功后,将数据备份到外部存储:
mkdir /mnt/recover
mount /dev/sda1 /mnt/recover
rsync -avz /mnt/recover/ /backup目录/
拆盘挂载到其他服务器
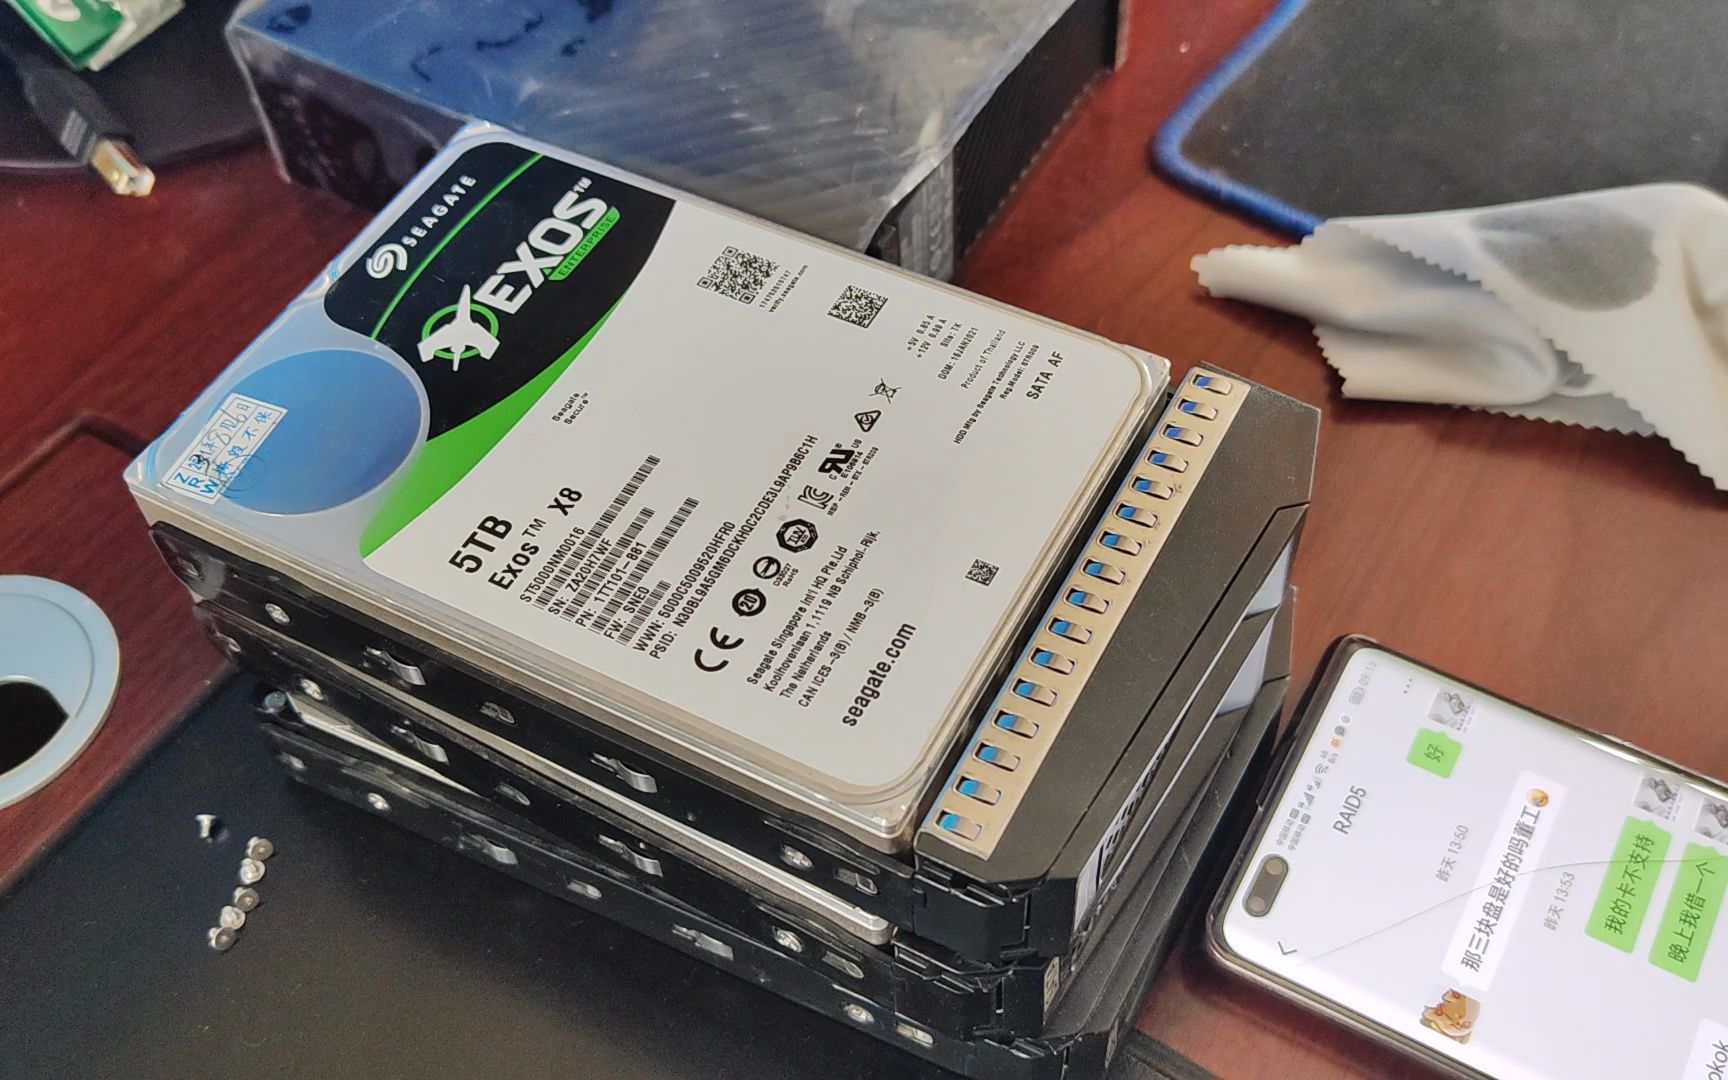
如果救援模式也无法识别磁盘,把硬盘拆下来,挂载到另一台同内核版本或更高版本的Linux服务器上,注意,源系统的/etc/fstab和SELinux配置可能影响识别,用lsblk确认设备名,手动挂载时加-o ro以只读方式访问,避免二次写入,如果重要业务数据文件出现损坏,可以用extundelete或xfs_undelete这类工具尝试恢复,成功率看你运气,但值得一试。
数据恢复成功后再考虑业务切换
数据安全拿到手之后,再去考虑重装RedHat 6系统还是换新系统,很多老服务器跑的是定制业务系统,不易直接替换,恢复后的第一件事是确认数据库服务、Web服务、计划任务是否正常。
redhat6服务器重启后无法开机解决方案与长期整改
脱离了崩溃现场,把RedHat 6服务器重启后无法开机解决方案系统化了,建议按下面四步落实长期策略,避免同类问题反复出现。
建立定时巡检与磁盘预警机制
在RedHat 6中内置smartmontools监控硬盘健康状态,它很实用,成本也低:
yum install smartmontools -y
smartctl -a /dev/sda设置每周定时任务,把SMART结果输出到日志,并检测Reallocated_Sector_Ct和Pending_Sector两个指标,这两个数值超过阈值就能提前发现坏道趋势,不用等到系统崩溃才救火。
用dump或tar做应用级备份
不用纠结有没有专业的备份软件,RedHat 6自带的tar配合crontab就能完成核心目录的备份,业内专家指出,多数中小企业服务器崩溃后损失最大的不是系统而是数据库,所以备份策略要围绕业务数据展开:
tar -zcvf /backup/app_$(date +%Y%m%d).tar.gz /var/www /opt/app /etc数据库部分建议先用mysqldump或pg_dump导出逻辑备份,再打包归档。
评估RedHat 6的替代升级路径
RedHat 6在2020年已经停止维护,新发现的漏洞不会再有官方补丁,从安全性角度出发,这台服务器继续裸奔在公网上风险很大,升级方案有两种主流选择:
| 方案 | 迁移成本 | 风险等级 | 适用场景 |
|---|---|---|---|
| 原地升级至CentOS 7兼容层 |
中等 | 中 | 第三方软件依赖老库 |
| 迁移至Rocky Linux 9/AlmaLinux | 较高 | 低 | 业务代码可重新编译 |
很多运维朋友倾向于重新搭一套新环境,把数据导入进去,再切换DNS引流,这个过程虽然前期投入大,但后续维护省心很多。
针对红帽6系统版本升级的费用与人力成本问题,不同地域、不同体量的公司差异较大,一二线城市的正规系统集成商给出的服务器系统替换服务报价通常在数千元至上万元不等,三四线城市的本地运维团队收费相对低一些,具体价格取决于你的业务复杂度和停机窗口时间要求。
建立双重保险:异地备份与容灾演练
加固好现有环境后,每周选择一台备用机器做恢复演练很有必要,真正把备份数据恢复起来并启动业务服务,才能确认这份备份可用,不要等下一次redhat6服务器崩溃时才想起来做验证,那时就晚了。
redhat6服务器崩溃原因排查的常见问题
RedHat 6内核崩溃后,能不能不重装系统直接恢复业务?
可以,如果服务器能进入单用户模式或救援模式,先修复文件系统和关键服务启动项,多数场景无需重装,只有引导分区(/boot)损坏严重且无法重建时,才需要考虑用同版本镜像重装系统,安装时不格式化原有分区,选择修复模式覆盖安装。
RedHat 6服务器崩溃后,数据盘和系统盘在一起怎么办?
直接在救援模式下挂载系统盘,把/home、/var/lib/mysql、/opt等业务目录拷贝出来,没有独立数据盘是单机部署的一个常见隐患,这次修复后应该重新规划存储结构,至少把数据和系统分开放在两个磁盘或两个分区上,如果数据盘和系统盘在同一块物理磁盘上,救援时尽量不要做写入操作,降低数据被覆盖的概率。
RedHat 6崩溃前的常见预警有哪些?
/var/log/messages中出现大量SCSI或ATA错误日志;服务器远程ping通但SSH连接卡顿;free -m显示内存所剩无几;iostat -x 1查看磁盘的%util长期接近100%,这些现象出现时尽早介入,比崩溃后抢救轻松得多。
老旧的RedHat 6服务器就像一位岁数不小但经验充足的老师傅,崩溃了别急着劝退它,先让它进“安全模式”(单用户)把话讲清楚,再决定是养护还是退休,只要数据还在,系统恢复就有了底气;只要脑子里有清晰的排查顺序,哪怕RedHat 6搭建的服务器崩了,你也能一步一步把它扶起来。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/764725.html