虚拟机网卡分流的本质,就是让不同业务流量走不同物理网卡,用软件手段实现多网口定向转发与负载均衡,避免所有流量挤在同一条物理链路上。这套操作在KVM、VMware ESXi、Hyper-V上都跑得通,关键看你愿不愿意花时间拆清楚流量模型,下面直接拆解实现路径。
多网口定向流量:为什么单块虚拟网卡撑不住
一台物理服务器上跑十几台虚拟机,所有流量都走同一块物理网卡,结果就是早晨九点业务高峰一到,延迟飙到几百毫秒,备份任务一跑,前端页面直接卡死,这不是虚拟机性能问题,而是物理网卡的单点瓶颈,虚拟交换机的流量出口就那一个,再大的带宽也扛不住所有业务同时抢。
行业共识认为,虚拟化环境里的网络瓶颈八成出在物理网卡队列上,而不是CPU或内存,虚拟机的虚拟网卡本质上是软件模拟出来的设备,它发出的数据包最终都要经过物理网卡的队列进入现实网络,如果物理网卡只有一个队列,所有虚拟机就得排队等这一个出口,延迟自然居高不下。
解决办法有两种思路:一是给物理服务器加装多块网卡,把不同业务分配到不同物理网口上;二是在现有网卡上开启多队列(RSS或Flow Director),让硬件把数据包分摊到多个CPU核心处理,真正靠谱的方案通常是两者结合,但今天重点聊前者多网口分流。
虚拟机多网卡负载均衡怎么配置才能做到定向转发
开搞之前先把需求列清楚,你需要统计当前环境里都有哪几类流量:
- 业务流量:虚拟机对外提供的Web、API等服务
- 存储流量:虚拟机和后端存储之间的数据同步
- 管理流量:ssh登录、管控平台通信
- 备份流量:定时备份任务产生的大批量数据传输
每类流量对延迟和带宽的敏感度不同,业务流量要求低延迟高稳定;存储流量是带宽大户,但能容忍一定延迟;管理流量完全不需要高带宽,只要稳定;备份流量最野蛮,能占满就占满,基于这些特性,物理网卡的分配策略就很清晰了。
以KVM环境为例,假设服务器有4块物理网卡,推荐这么划分:
| 物理网卡 | 承载流量 | 带宽建议 |
|---|---|---|
| eth0 | 管理流量 | 千兆够用 |
| eth1 | 前端业务流量 | 万兆起步 |
| eth2 | 存储/备份流量 | 万兆,SR-IOV更佳 |
| eth3 | 备用/迁移流量 | 千兆或万兆 |
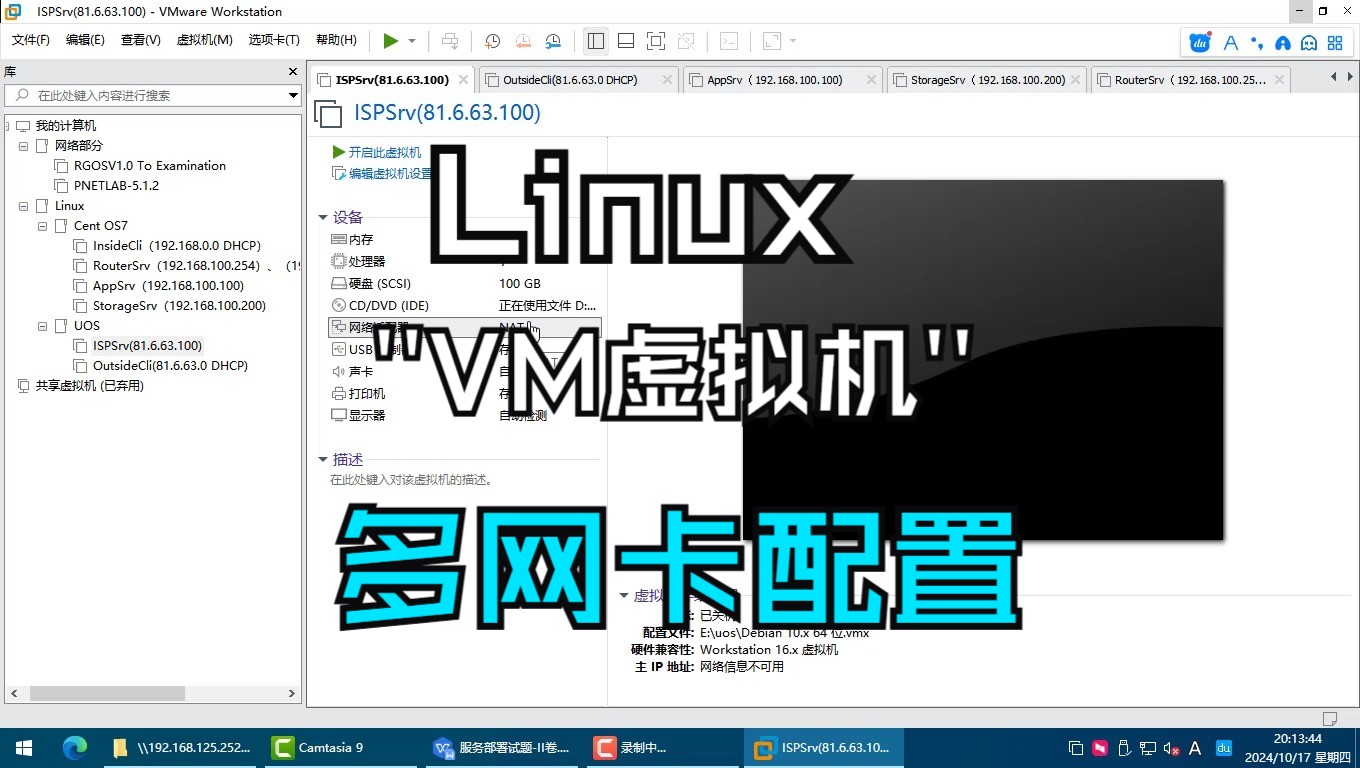
这里有一个最容易被忽视的细节:虚拟机的虚拟网卡要在创建时就绑定到正确的桥接设备上,而不是创建完了再改,Linux环境下用virt-manager或virsh创建虚拟机时,网络接口处选择对应的Linux Bridge即可,每个桥接设备对应一块物理网卡,虚拟机里进流量走eth1的桥,备份流量走eth2的桥,天然隔离,互不干扰。
关键操作路径是:物理网卡→创建Bridge→绑定虚拟网卡→虚拟机内部验证连通性,Linux下创建Bridge的命令如下:
# 创建桥接设备br1,关联物理网卡eth1
nmcli connection add type bridge ifname br1 con-name br1
nmcli connection add type ethernet slave-type bridge con-name eth1-br1 ifname eth1 master br1
这一步做完,新建虚拟机时网络模式选bridge: br1,流量就走eth1出去。多个虚拟机可以共用同一块物理网卡,但前提是它们之间的流量总和不超过这块网卡的带宽上限。
虚拟机网卡分流和bonding对比:哪个方案更适合定向流量
不少人会问:我用bonding把四块网卡绑成一个逻辑接口,带宽叠加不也一样能解决瓶颈吗?坦白说,bonding适合的是“带宽叠加+故障冗余”场景,但不适合“隔离控制”场景,两者的本质差异在于:
- bonding:所有流量混在一起,走同一个逻辑出口,按哈希算法分摊到物理网卡上
- 分流:流量按业务类型隔离,各自走独立路径,互不干扰
做一个直观对比:
| 维度 | bonding (mode 4) | 多网口分流 |
|---|---|---|
| 带宽利用率 | 高,多网卡聚合 | 中等,单块网卡用满才能溢出 |
| 配置复杂度 | 低,改一块逻辑口 | 高,需要规划每个桥的流量 |
| 故障切换 | 自动,链路失效自动迁移 | 手动或依赖上层路由协议 |
| 隔离性 | 差,所有流量混跑 | 好,各走各道 |
| 适用场景 | 大流量汇聚 | 多业务隔离、定向管控 |
如果预算有限,物理机加装独立网卡的费用可以控制在几百到几千元之间,具体取决于你选千兆还是万兆光口,在多网口分流方案里,万兆网卡并不贵,但要注意交换机端口也要匹配万兆模块,这部分支出容易被忽略。
实际建议是:多业务共存的场景优先上分流;单一大流量场景用bonding更省事,两种方案也可以组合使用底层bonding提升带宽冗余,上层分流隔离业务类型。
三层路由策略加Open vSwitch流表:把定向流量玩到极致
桥接做好只是基础,真正的“定向”需要更精细的规则,这里有两个进阶方案。
策略路由,如果你希望来自某个网段的流量强制走指定物理网卡,用Linux的策略路由规则能精确到源IP,以iproute2为例:
# 创建独立路由表
echo "100 biz" >> /etc/iproute2/rt_tables
# 指定源IP段的流量走br1网关
ip route add default via 192.168.1.1 dev br1 table biz
ip rule add from 192.168.10.0/24 table biz
这样配置后,凡是来自192.168.10.0网段的流量,无论目的地是哪,一律从br1对应的物理网卡出去,其他流量继续走默认路由。这种路由规则的粒度比虚拟交换机更细,适合跨网段访问场景。
Open vSwitch流表控制,稍微复杂的场景里,物理交换机上的ACL规则也能下沉到虚拟交换机,OVS的ovs-ofctl add-flow命令可以按TCP端口、VLAN、MAC地址做精细化定向,比如把去往存储服务器(IP为192.168.50.10)的流量强制导到eth2:
ovs-ofctl add-flow br0 "priority=100,ip,nw_dst=192.168.50.10,output:3"
命令仅作示例,实际数值要根据你的环境调整,这意味着数据包从虚拟机出来后,直接走物理端口3(对应eth2),连路由决策都省了,延迟再降一级。
北京机房虚拟机多网口分流方案落地后的排查和验证
配置完成后,别急着投生产,先用现象验证是否有异常。
排查命令第一条:ethtool -S eth1 | grep rx,查看物理网卡的收包队列是否分散到多个CPU核心上,如果所有中断都落在CPU0上,说明多队列没开启,分流效果打了折扣。
第二条命令:ip route show table all,确认策略路由规则已生效。
第三条命令:在虚拟机内部使用iperf3 -c <对端IP>分别测试业务网卡和备份网卡的实际带宽是否达到预期,如果业务流量测试时备份网卡的流量也在涨,说明桥接配置有误,物理网卡之间串流了。
最让人头疼的问题往往出在vSwitch的端口安全上,部分虚拟交换机默认开启MAC地址防欺骗,虚拟机换了一张虚拟网卡后MAC变了,流量直接丢弃,排查时打开虚拟交换机的端口学习模式,或者把虚拟机内的MAC地址改成和虚拟网卡设定值一致。
存储流量占用带宽过高的场景,可以给存储网络单独划分VLAN并在物理交换机上配置QoS限速策略,虚拟化环境里的流量优先级问题,不是靠单点解决,而是要全链路配合。
常见问题排查:多网口负载均衡的性能瓶颈在哪里
业务网卡绑定正确了,但流量仍然走默认路由,怎么办?
检查虚拟机的网关配置,如果虚拟机默认网关指向的是管理网络的网关,那策略路由写得再漂亮也白搭,虚拟机的路由优先级是:直连路由→静态路由→默认网关,你需要把特定网段的静态路由写到虚拟机内部,或者调整策略路由的优先级。
两块物理网卡之间的流量存在大量重传,怎么定位?
用tcpdump -i br1抓包,看是否有TCP Dup Ack或Retransmission现象,如果频繁重传,多半是MTU设置不一致,物理网卡和虚拟网卡的MTU需要保持一致,虚拟交换机默认MTU是1500,存储网络建议调到9000,这段不匹配会导致数据包分片和重组,性能锐减。
多块物理网卡之间需要流量负载均衡时,方案怎么选?
如果你已经完成了业务隔离,仍然有单块网卡流量过大的压力,可以在下游再加一层bonding,比如把eth2和eth3绑定成bond1给存储使用,这样存储流量本身又能获得带宽叠加和链路冗余,物理机上网络配置变成了“bonding+分流”的混合架构,这种组合在比较复杂的生产环境里更为实用,但配置复杂度也会相应上升,配置前要仔细查阅对应虚拟化平台的官方文档进行验证,比如KVM或VMware的官方网络配置指南。
整个多网口分流方案的落地逻辑可以用一句话概括:先分清楚流量类型,再为每类流量分配独立物理通道,最后用路由策略精确控制走向,这是给虚拟机网络做减法的过程,也是让多网口硬件价值最大化的方式。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/773221.html