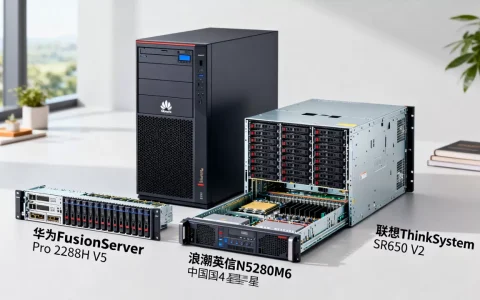
AI服务器硬件不是只有GPU,它是一套围绕加速卡重新配平的整机系统:加速卡、CPU、内存、存储、网络、供电散热和管理部件缺一不可。 只盯单卡型号,后面往往会在供配电、网络和运维上补课。
AI服务器硬件有哪些?先分清整机与部件
AI服务器硬件可以按“整机形态+核心部件”两层看,整机常见有机架式GPU服务器、高密度多节点服务器、液冷整机柜,部件则围绕加速卡展开,任何一个短板都会拖慢集群。
加速卡:GPU、NPU/ASIC、FPGA怎么分工
- GPU:通用性最强,训练和推理都常用,关注显存容量、HBM带宽、卡间互连和单卡功耗。
- NPU/ASIC:面向特定推理或训练负载,能效和成本有优势,软件栈适配要提前验证。
- FPGA:适合低延迟、特定算子加速,开发和移植成本要算进项目周期。
- 选型时别只看峰值算力,要看显存是否装得下模型、卡间带宽是否跟得上、框架和算子库是否支持。
CPU与主板:别把CPU当配角
CPU负责数据预处理、调度和喂卡,PCIe通道数不够,加速卡和网卡就抢通道,实操上看这几项:
- 单路还是双路CPU,PCIe 5.0通道是否满足加速卡和网卡同时满配。
- NUMA拓扑是否均衡,避免跨节点访问拖慢数据供给。
- BIOS里确认Above 4G Decoding、Resizable BAR、电源策略和性能模式。
- 验收命令:
lscpu、lspci -vv、dmidecode -t processor。
内存与存储:容量和带宽要匹配
内存不只是“够用”,训练任务要缓存数据、跑数据加载器,内存不足会频繁换页,存储则分本地NVMe、并行文件系统和对象存储。
- 内存关注DDR5 RDIMM容量、通道数、是否满通道,加速卡自带HBM,不能替代系统内存。
- 本地盘优先NVMe U.2/E3.S,系统盘和缓存盘分开,RAID卡或直通模式按业务选。
- 验收命令:
dmidecode -t memory、nvme list、lsblk、fio做顺序和随机压测。 - 行业共识认为,存储带宽和网络带宽要跟加速卡数量同步规划,否则多卡容易等数据。
网络与互连:训练集群的隐形主件
单机看NVLink/PCIe,多机看网卡和交换机,常见选择是InfiniBand和RoCE。
- IB:低延迟、生态成熟,成本和运维门槛要评估。
- RoCE:以太网生态通用,需要配置PFC、ECN和QoS,调不好会丢包。
- 网卡常见100G、200G、400G,按集群规模配,DPU可卸载网络和存储任务,但要确认操作系统和虚拟化支持。
- 验收命令:
ip -br link、ethtool <网卡名>、ibstat、ibping,RoCE环境还要看tc -s qdisc。
供电、散热与管理:容易被低估
高功耗加速卡会把整机功耗拉高,电源要冗余,PDU和机房配电要匹配,风冷适合多数通用场景,液冷适合高密度整柜。
- 电源看钛金/铂金效率、冗余方式、PDU接口。
- 散热看风道、风扇策略和进风温度,液冷要确认冷板、快接头、漏液检测和运维流程。
- 管理口用BMC/IPMI,验收命令:
ipmitool sensor、ipmitool sel list,检查传感器和日志。 - 固件基线要统一:BIOS、BMC、网卡固件、GPU驱动和CUDA版本记录在案。
| 部件 | 作用 | 选型关注点 | 可验证动作 |
|---|---|---|---|
| 加速卡 | 训练/推理主力 | 显存、互连、功耗、软件栈 | nvidia-smi、lspci \| grep -i nvidia |
| CPU/主板 | 调度与喂卡 | PCIe通道、NUMA、BIOS设置 | lscpu、lspci -vv |
| 内存 | 数据缓存 | 容量、通道、RDIMM | dmidecode -t memory |
| 存储 | 数据集与缓存 | NVMe带宽、RAID/直通 | nvme list、fio |
| 网络 | 多机通信 | IB/RoCE、带宽、QoS | ibstat、ethtool |
| 供电散热 | 稳定运行 | 冗余、风道、液冷 | ipmitool sensor |
AI服务器和普通服务器区别在哪?
区别不在机箱大小,而在系统配比,普通服务器强调通用计算和存储密度,AI服务器强调加速卡密度、数据供给和散热余量,业内专家指出,训练集群的瓶颈经常不在单卡算力,而在网络和存储的持续供给能力。
- 加速卡数量与供电:AI服务器常配多张高功耗卡,电源、PDU和机房配电要单独核算。
- PCIe与互连:GPU间互连、网卡通道、NVMe通道会争抢PCIe资源,普通服务器很少这样配。
- 散热设计:AI服务器风道更激进,高密度场景转向液冷。
- 网络:多机训练依赖低延迟网络,普通业务服务器常以万兆或双万兆为主。
- 管理与固件:GPU驱动、CUDA、BMC、网卡固件要版本对齐,验收更细。
- 故障域:一张卡或一个网口异常可能拖慢整个训练任务,监控要覆盖到卡和链路。
深度学习训练服务器配置怎么选?从模型规模倒推
别先写配置单,先算约束,可照着下面步骤走:
- 明确模型参数量、精度、并发和训练/推理场景。
- 估算显存需求,决定单卡显存和卡数,显存放不下,先考虑并行策略,不是硬堆卡。
- 按卡数配CPU和内存,确认PCIe通道和NUMA拓扑。
- 算数据吞吐,配NVMe缓存和并行文件系统客户端带宽。
- 多机训练选IB或调优RoCE,交换机端口和线缆同步下单。
- 核算整机功耗、机房配电和散热余量,预留扩容空间。
- 到货后做单机压测、多机通信压测和长时间稳定性测试,记录固件基线。
AI服务器价格一般多少钱?先看隐性成本
AI服务器价格一般多少钱,不能只看整机报价,价格由加速卡型号和数量、CPU平台、内存容量、NVMe盘位、网卡和交换机、电源散热、软件授权和维保共同决定,常见区间从数万元到数十万元,高密度多卡和液冷配置会更高。
- 显性成本:整机、加速卡、内存、存储、网卡、交换机、线缆。
- 隐性成本:机房配电改造、液冷管路、电费、备件、驱动适配、运维人力。
- 采购方式:直采、集成商打包、租赁、云上按需,短期项目可先租后买,长期稳定负载再算持有成本。
- 合同要点:交付周期、固件版本、备件响应、上门服务、扩容同批次、验收标准写清楚。
北京AI服务器硬件采购渠道怎么找?按交付方式筛选
北京AI服务器硬件采购渠道怎么找,先按交付方式筛,而不是只看报价单,可对比厂商直采、区域集成商、总代/分销、租赁服务和二手设备。
- 厂商直采适合规模明确、需要原厂维保的项目。
- 集成商适合整柜交付、网络存储一起打包的场景,重点看本地备件和上门能力。
- 租赁适合短期训练和验证期,合同里写清卡型、带宽、是否独占。
- 二手设备要查序列号、保修转移、加速卡使用时长和固件历史。
- 询价清单至少列:加速卡型号数量、CPU、内存、NVMe、网卡、电源、散热方式、机柜尺寸、维保年限、交付地点和验收命令。
- 北京本地交付还要确认机房进楼、配电、承重和液冷改造条件,别等设备到楼下才发现进不去。
把加速卡、CPU、内存、存储、网络、供电散热和管理部件按业务负载配平,才是AI服务器硬件选型的主线,只盯单卡型号,后面往往要在机房、网络和运维上补课。
AI服务器硬件Q&A:选型和验收常见问题
问:AI服务器硬件一定要上液冷吗?
不一定,风冷能覆盖多数常规密度场景,液冷更适合高密度整柜和持续高功耗负载,先看机房配电、承重和运维能力,再决定是否上液冷。
问:AI服务器硬件到货后先验什么?
先验序列号、固件版本、加速卡识别和链路状态,再做单机压测与多机通信测试,可用nvidia-smi、lspci、ibstat、ipmitool sensor逐项记录,验收记录、序列号、固件版本和压测结果留档,后续保修和扩容都依赖这些信息。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/776411.html