算力服务器是承载AI训练、推理和高性能计算的专用硬件,核心分类包括GPU服务器、NPU服务器、CPU服务器和FPGA加速服务器,其中GPU服务器目前占据AI算力市场的主流地位。
算力服务器有哪些类型?按加速芯片分类最直观
要搞清楚算力服务器都有哪些,最直接的维度是看它装了什么“心脏”加速芯片,行业内常说的AI服务器、GPU服务器、HPC服务器,本质上都是围绕芯片类型来划分的。
GPU服务器:AI训练和推理的绝对主力
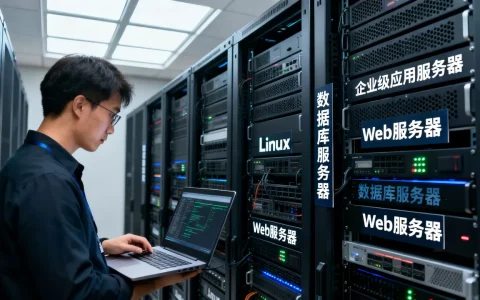
GPU服务器是目前最常见的算力服务器形态。英伟达的A100、H100、H200以及国产的昇腾910B都是其中的典型代表,这类服务器通常采用8卡或4卡配置,比如8卡H800服务器,单机就能提供强大的浮点运算能力。
- 适用场景:大模型训练、深度学习推理、科学计算
- 典型配置:2路CPU + 8张GPU卡 + 高速NVLink互联
- 优势:生态成熟,CUDA框架支持广泛,几乎所有AI框架都优先适配
业内专家指出,当前互联网大厂和智算中心采购的算力服务器中,GPU服务器占比超过七成,这直接推动了整个供应链的繁荣。
NPU服务器:AI专用芯片的挑战者
NPU是神经网络处理单元的缩写,专门为AI运算设计。华为昇腾、寒武纪思元、地平线征程都属于这一阵营,与GPU相比,NPU在特定AI算子上的能效比更高,功耗控制更好。
NPU服务器的部署形态往往是整机柜交付,比如昇腾的Atlas 900集群,适合超大规模算力中心建设,国产化替代趋势下,NPU服务器的关注度近年来持续上升,部分政务云项目已明确要求优先采用NPU方案。
CPU服务器:通用算力的基石
不能忽视的是,传统CPU服务器依然是算力体系的基础层,Intel的至强系列、AMD的EPYC系列是高密度计算节点的主力,在没有GPU加速的场景下,CPU服务器承担着数据预处理、分布式存储、调度管理等任务。
在实际数据中心里,CPU服务器和GPU服务器通常混布在同一机房,前者负责“打杂”,后者专注“重活”,比如一台8卡GPU服务器,一般需要配3-5台CPU服务器来提供数据喂给和结果回收。
FPGA服务器:低延迟场景的灵活选项
FPGA服务器通过硬件编程实现特定算法加速,适合金融高频交易、基因测序、视频转码等延迟敏感型业务,相比GPU,FPGA的灵活性高但开发门槛也高,需要硬件描述语言编程,因此市场占比相对较小。
算力服务器按应用场景划分:训练、推理、通用计算
除了看芯片,从用途上分类更能帮助选型,同一个物理形态的服务器,因为配置侧重不同,价格和性能差异非常大。
AI训练服务器
训练服务器是算力服务器中配置最高、价格最贵的一类,它需要处理海量数据并不断迭代模型参数,因此要求:
- 极致算力:满载8张最新旗舰GPU卡
- 超大内存:系统内存通常达到1TB以上
- 高速互联:GPU与GPU之间通过NVLink或IB网络通信,带宽达到数百GB/s
训练服务器的单台价格从几十万元到数百万元人民币不等(据行业采购信息),主要受GPU卡数量和型号影响,比如配8张A800的整机,市场价普遍在130万元左右波动,配置H800则可能突破200万元。
AI推理服务器
推理服务器承担模型训练完成后的实际应用计算,比如图像识别、语音交互、内容推荐,推理对延迟和吞吐量更敏感,而不像训练那样追求极致精度。
推理服务器的配置相对灵活:
- 可用中端GPU(如L40S、RTX 4090)
- 也可用NPU加速卡(如昇腾310)
- 甚至可以只用高主频CPU解码轻量模型
业界有个共识:推理算力需求正在超过训练算力,随着大模型应用落地,推理服务器的增量空间会更大。
通用高性能计算服务器
这类算力服务器服务于气象预报、石油勘探、材料模拟等传统HPC场景,它们对双精度浮点性能要求高,常用CPU+GPU异构架构,但不像AI训练那样依赖单卡显存,而是更注重整体并行效率。
算力服务器部署形态有什么讲究?
物理形态上,算力服务器主要分为机架式、刀片式、高密度整机柜、边缘算力盒四种。
机架式服务器
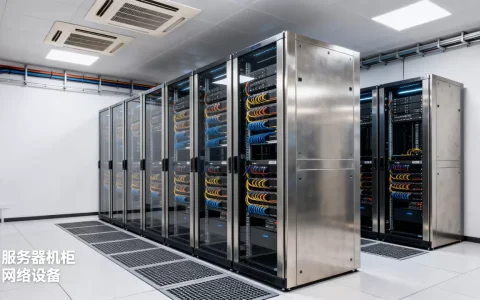
最常见的4U/8U机架式GPU服务器,比如浪潮NF5688、超微SYS-821GE,独立供电、独立散热,维护方便,适合中小规模智算节点。
刀片式服务器
刀片式将多个计算节点压缩到同一个机箱中,空间利用率高、功耗集中管理,适合大型数据中心成批量部署,但散热压力大,对机房制冷有更高要求。
高密度整机柜
类似“算力集装箱”,将计算、存储、网络、制冷打包在一个机柜内,华为Atlas 900、浪潮AIStation都属于这类形态,交付速度快,适合智算中心的规模化建设,但单柜功率极大,需要配套液冷方案。
边缘算力盒
近几年边缘计算场景增多,出现了小型化、低功耗的算力边缘设备,这类设备能直接部署在工厂产线、无人车、监控杆上,实现毫秒级响应,虽然单机算力不强,但胜在灵活。
2026年选算力服务器,这些参数比品牌更重要
不管名字怎么叫,挑选算力服务器时核心就看以下几个硬指标:
- 总算力(FP16/FP32/INT8精度下的TFLOPS)
- 显存容量和带宽(大模型推理很大程度上依赖显存大小)
- 卡间互联方式(NVLink、PCIe、HCCS直连)
- 网络接口(400G RoCE或IB网络上行)
- 散热方案(风冷还是液冷)
- 扩展性(能否平滑升级到下一代GPU)
采购算力服务器时,来源也有讲究,目前市场上既有整机原厂(浪潮、新华三、超聚变)、也有白牌组装机,原厂产品稳定性和售后服务有保障,价格较高;白牌机性价比突出,但更适合有较强硬件运维能力的团队,据行业内采购经验,同配置下白牌机通常比原厂便宜15%到20%。
算力服务器价格需要多少钱?这份预算思路可以参考
算力服务器价格跨度极大,从几万元的边缘盒子到上千万元的集群一体机都存在,做预算时建议分三步走:
- 先定算力规模:根据模型参数量与并发需求估算总算力,比如千亿参数大模型微调需要至少512张(百模训练标配)H系列GPU。
- 再选服务器形态:108亿参数模型推理推荐部署2台8卡L40S服务器,同样规模的训练则需4台以上。
- 最后留出配套预算:网络交换机、UPS电源、机房改造通常占硬件总成本的20%到30%,千万别只算服务器本身。
对预算有限的中小团队,也可以考虑“租用”而非自购,目前国内主流云厂商都提供按小时的GPU实例租赁服务,A100单卡每小时租金大约在20元至30元区间(据国内云厂商公开定价),适合短期验证阶段。
常见问题解答
算力服务器和普通服务器有什么区别?
算力服务器本质上是加了专用加速芯片(GPU/NPU)的服务器,它拥有更多的PCIe插槽、更强的供电模组和更高效的散热设计,同时也需要特殊的驱动和调度软件,普通服务器主要用于网站、数据库等传统业务,算力服务器则针对高并行计算场景做了深度优化。
AI训练服务器和推理服务器能互相替代吗?
不能,训练服务器对算力峰值和数据精度要求更高,配置了最新旗舰GPU和超大显存;推理服务器则追求低延迟、高吞吐和功耗控制,甚至可以用量化模型降低精度要求,简单说,训练是“造模型”,推理是“用模型”,两者侧重点完全不同,混用会导致性能和成本都不理想。
国产算力服务器可用吗?
可用性已经大幅提升,以昇腾为代表的国产算力服务器在政务、金融、运营商等行业部署量快速增长,PyTorch等主流框架已支持昇腾后端,主流模型也完成了适配,但在部分小众底层算子兼容性上,生态完善度仍不及CUDA体系,如果项目不涉及敏感数据,选择面会更宽;如果受合规约束要求信创环境,国产算力服务器已经是稳妥的选择。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/776416.html