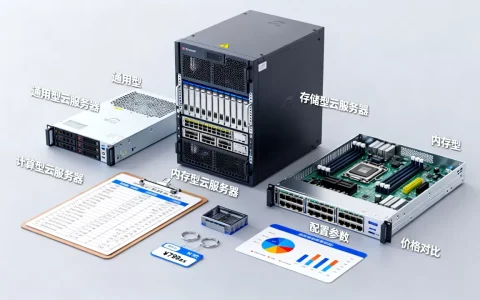
大型集群服务器不是某一款具体机型,而是由计算节点、存储节点、高速互联网络和统一调度系统组合起来的一整套算力集群,市面上常见的主流形态有机架式集群、刀片集群、整机柜交付、GPU异构集群和高密度存储集群这五类,搞清楚它们各自适合什么活儿,比单纯比参数重要得多。
大型集群服务器有哪些:五类主流形态逐个看
机架式集群是最常见的一类,几十到上千台2U或4U服务器装进标准机柜,通过万兆以太网或InfiniBand互联,再挂一套Slurm、Kubernetes做调度,它扩展灵活、单节点故障影响面小,中小规模HPC和通用业务集群大多走这条路。
刀片集群把计算刀片、交换模块、管理模块塞进一个刀箱,走背板互联,优势是布线少、密度高、统一管理,代价是机箱绑定厂商,后期扩容要跟着原厂节奏走,金融、电信的私有云里见得多。
整机柜交付这两年挺火,厂商在工厂里就把机柜、服务器、交换机、供电和液冷管路预装好、预测试完,到场通电就能跑,千卡以上GPU集群基本都用这种方式,现场施工周期能压缩不少。
GPU异构集群是当前增量最大的一类,节点里配8卡GPU,节点间用高速无损网络互联,配合RDMA和GPUDirect技术减少数据搬运,训练大模型、做科学计算、跑推理服务,都属于它的主场。
高密度存储集群则偏向容量和吞吐,单机柜塞几十块大容量硬盘,配分布式文件系统,面向视频归档、基因测序、遥感影像这类海量数据场景。
简单对比一下:
| 形态 | 典型规模 | 优势 | 主要限制 |
|---|---|---|---|
| 机架式集群 | 几十至上千节点 | 灵活、成本可控 | 布线和占地压力大 |
| 刀片集群 | 单箱十几至几十刀片 | 密度高、管理统一 | 厂商绑定、单箱功耗高 |
| 整机柜交付 | 整柜起订 | 交付快、一致性高 | 前期投入大、需匹配机房 |
| GPU异构集群 | 数十至数千卡 | 并行算力强 | 网络和散热门槛高 |
| 高密度存储集群 | PB级起步 | 单位容量成本低 | 随机读写性能一般 |
按部署位置还能再分一层
自建机房集群、托管集群、公有云上的虚拟集群,本质都是这套架构,区别在于谁承担机房和运维。北京、上海、深圳这类一线城市的大型集群服务器机房受能耗指标限制,新建项目往张北、乌兰察布、中卫这些地方走的趋势很明显,选址时要把网络时延和电价一起算进去。
大型集群服务器和普通服务器有什么区别
差别不在单机性能,而在“连起来之后还能不能稳”,普通服务器宕机,影响的是一台机器;集群里某个环节没设计好,可能拖垮整批任务。
网络是命门
普通业务用万兆以太网够用,大型集群普遍上InfiniBand或RoCE,业内专家指出,GPU集群里网络投入占比往往被低估,实际施工中交换机和光模块的成本能占到相当一部分预算,验证链路是否健康,可以直接跑:
ibstat看端口状态和速率iblinkinfo查链路误码nvidia-smi topo -m确认GPU与网卡的拓扑距离
供电和散热要提前算账
单机柜功率从传统的6至8kW,涨到GPU集群的30kW甚至更高,风冷压不住就得考虑冷板式液冷,上架前建议核对:
ipmitool sdr读整机功耗和进风温度- 机房冷通道是否封闭、地板承重是否达标
- 双路市电加UPS的切换时间是否满足业务连续性要求
管理方式完全不同
普通服务器一台台登上去配就行,集群必须靠自动化,常见做法是pdsh -w node[01-64] uptime批量执行命令,配置管理用Ansible,作业调度用Slurm的sinfo看分区状态、squeue看排队情况,容器化场景则用kubectl get nodes核对节点就绪状态。
大型集群服务器价格大概多少钱
价格这事儿没法给一个数,但可以拆开看。一套集群的预算大致由计算节点、存储、网络、机房配套和运维五块构成,其中网络和机房配套最容易被漏算。
- 计算节点:通用CPU节点单台几万元级别,8卡GPU节点单台进入数十万元级别,整柜方案整体到百万级。
- 网络:InfiniBand交换机和光模块按端口计费,规模越大单价越低,但总投入不小。
- 存储:分布式存储按可用容量报价,全闪和混闪差一截。
- 机房:机柜租金、电费、制冷改造,一线城市和西部枢纽差价明显。
- 运维:要么养团队,要么买原厂服务,按年计。
中小团队如果只是想先跑通业务,租用比自建划算;当算力需求稳定、连续跑满一年以上,自建的边际成本才会显现,行业内普遍的做法是先用云上验证,再把长期稳定的负载迁回自建集群。
大型集群服务器适合哪些应用场景
判断标准很直接:任务能不能拆成很多份并行跑,且对节点间通信有要求。
- 科学计算与仿真:气象预报、流体力学、材料模拟,典型的重互联场景。
- AI训练与推理:大模型训练吃GPU和高速网络,推理侧更看重显存和并发。
- 大数据分析:离线批处理、实时数仓,节点多、单节点配置中等。
- 影视渲染与仿真:渲染农场本质就是集群,拼的是调度效率和存储带宽。
- 私有云与虚拟化底座:把内部业务统一收拢到集群里,提升资源利用率。
日均请求量不大的小型网站、单机就能跑完的数据库,上集群属于过度设计,运维复杂度反而成为负担。
大型集群服务器怎么选:一份可落地的核对清单
选型不是比参数表,而是把需求翻译成约束条件,下面这几步按顺序走,能避开大部分坑。
第一步:算清算力与互联需求
先明确跑什么负载、峰值并发多少、单任务能切多细,GPU集群还要确认是否需要RDMA、是否需要GPUDirect,这直接决定网络选型。
第二步:核对机房硬条件
- 单机柜可用功率够不够
- 制冷方式能否匹配
- 承重、层高、走线空间是否满足
- 现有网络出口带宽和时延是否达标
第三步:评估交付与运维能力
有没有自动化装机、批量配置、监控告警的现成工具链;原厂能否提供备件和现场支持;扩容时是否需要停机。
第四步:做小规模验证
别一次性铺开,先上一个小分区,跑真实业务压测,观察作业排队时间、网络误码、散热表现,再决定是否放量,这一步花的钱,通常比返工便宜得多。
大型集群服务器常见问题解答
大型集群服务器一般多少节点起步才算“集群”?
行业里没有硬性门槛,但从运维角度看,节点数到十几台以上、需要统一调度和批量管理时,分布式部署方式的价值才真正体现,少于这个量级,用几台独立服务器加监控往往更省心。
大型集群服务器和超融合架构该怎么选?
超融合把计算、存储、网络整合在少数几类节点上,部署简单、横向扩展方便,适合虚拟化和中小规模私有云;传统集群则是计算与存储分离,扩展时各扩各的,更适合计算密集或存储密集这类负载不均衡的场景,两者不是替代关系,很多数据中心是并存的。
大型集群服务器采购时最容易忽略什么?
最容易忽略的是网络和机房配套的预算占比,以及后期运维的人力和备件成本,实际项目里,计算节点往往是最先敲定的一块,而真正决定集群能不能稳定跑起来的,是互联质量、散热余量和调度策略这三件事。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/776417.html