云服务器、本地物理服务器、边缘节点和SaaS托管服务,多数直播、语音社交和在线客服场景优先选云服务器;对延迟、数据可控要求高的团队,再考虑本地部署或混合架构。 下面按类型、选型、配置、价格和部署场景拆开讲,尽量给可落地的判断依据。
变声系统服务器有哪些类型?按部署形态拆开看
变声系统服务器不是单一产品,它更像一套音频处理链路的承载环境,核心任务是接收音频流、完成变声推理或DSP处理,再把处理后的音频推回客户端,按部署形态分,常见有下面几类。
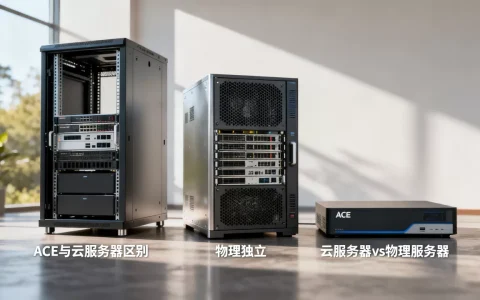
云服务器:按需开通,适合多数直播和社交场景
公有云上的云服务器是当前最常见的选择,它把CPU、内存、GPU、带宽和公网IP打包成可开通的实例,适合业务量有波峰波谷的团队。
- 适用场景:语音社交App、直播连麦变声、在线客服变声、短期活动。
- 优势:开通快,按量或包月计费,安全组和监控体系现成。
- 注意点:实时音频对网络抖动敏感,地域节点要靠近用户;GPU实例成本较高,要先压测再扩容。
实操上,开通云服务器后通常要做三件事:在控制台选择靠近目标用户的地域节点;在安全组开放音频服务需要的TCP/UDP端口;用ss -lntup确认服务监听状态,路径不复杂,难的是把并发和延迟压到可接受范围。
本地物理服务器:低延迟与数据可控的折中方案
本地物理服务器可以是自建机房,也可以是IDC托管,它适合并发相对固定、长期运行、对音频数据不出内网有要求的团队。
- 适用场景:大型语音平台的核心变声集群、企业内网培训系统、对数据合规要求高的场景。
- 优势:网络路径可控,硬件独享,长期成本可能低于持续扩容的云GPU实例。
- 注意点:要自己处理UPS、显卡散热、网络出口和故障替换,音频服务对实时性要求高,单点故障会直接影响连麦体验。
边缘节点与SaaS托管:轻量接入的两种路径
边缘节点把处理能力放到离用户更近的位置,适合跨地域低延迟场景,SaaS托管则把变声能力封装成API或SDK,团队按路数或时长付费,不需要自己维护服务器。
| 类型 | 适用场景 | 延迟表现 | 成本结构 | 运维负担 |
|---|---|---|---|---|
| 云服务器 | 直播、社交、活动 | 中等,取决于地域 | 按量或包月 | 中等 |
| 本地物理服务器 | 固定并发、数据可控 | 较低 | 硬件一次性投入加托管费 | 较高 |
| 边缘节点 | 跨地域实时音频 | 较低 | 按节点和流量计费 | 中等 |
| SaaS托管 | 快速上线、小团队 | 取决于服务商 | 按路数或时长 | 较低 |
变声系统服务器怎么选?先看并发路数与延迟指标
选服务器不要先看价格,也不要先看显卡型号,先把并发路数和延迟目标定下来,配置才有参考系。
并发路数决定CPU与内存基线
变声系统的并发路数,指同一时间正在处理多少路音频,传统DSP变声对CPU压力相对可控,AI变声模型推理更吃GPU显存和算力。
- 先统计峰值并发,不要只看平均并发。
- 每路音频的采样率、位深、编码格式都会影响资源占用。
- 用压测工具模拟真实音频流,观察CPU、内存、GPU显存和音频断续情况。
一个三人小团队做语音社交App,白天并发低、晚上高峰明显,这种业务用包月云主机加弹性伸缩,通常比一次性买物理服务器更稳,反过来,一个固定服务几百路的企业内网系统,本地物理服务器可能更划算。
端到端延迟要拆成三段算
端到端延迟可以拆成采集编码、网络传输、推理输出三段,行业共识认为,实时语音互动把端到端延迟控制在两百毫秒以内,体验会比较自然,超过这个范围,连麦时容易出现“抢话”感。
- 采集编码段:关注客户端缓冲区设置。
- 网络传输段:关注地域节点、公网带宽和抖动。
- 推理输出段:关注模型大小、GPU利用率和音频队列。
排查时可以用ping和mtr看网络路径,用服务端日志看每段耗时,不要只盯着服务器配置,网络抖动经常是延迟波动的来源。
音频编解码与GPU加速的取舍
CPU软编适合低并发和成本敏感场景,AI变声模型通常需要GPU加速,尤其是实时率要求高的场景,业内专家指出,实时音频系统的瓶颈往往不在单次推理,而在并发调度和音频缓冲管理。
- 检查GPU是否可用:
nvidia-smi。 - 看显存占用是否接近上限,避免批量推理时排队。
- 非实时模型训练可以放到抢占式实例,实时推理用稳定实例。
直播变声系统服务器配置要求:从推流链路倒推
直播变声的链路一般是:主播端采集音频,推流到变声服务器,服务器处理后再推给直播平台或连麦房间,配置要从这条链路倒推。
常见配置档位与适用场景
- 入门档:4核8G左右的CPU云主机,适合低并发、传统DSP变声或测试验证。
- 进阶档:带GPU的云实例,适合AI变声、实时率要求较高的直播场景。
- 集群档:多台GPU实例加负载均衡,适合中大型语音平台。
配置不是越高越好,先跑通单路,再逐步加压,单路都出现爆音或断续,加机器也解决不了链路问题。
带宽与端口规划实操
音频流带宽不算大,但并发上来后,公网带宽和端口规划不能省。
- 按“并发路数×单路码率”估算上行和下行带宽,再留出余量。
- 安全组只开放必要端口,音频服务常用UDP,控制信令常用TCP。
- 用
ss -lntup | grep 端口号确认监听状态。 - 用
ulimit -n检查文件描述符上限,并发高时避免连接被拒。
部署命令与验证路径
通用部署路径可以按下面几步走,具体镜像和端口以服务文档为准。
- 安装GPU驱动和容器运行时,执行
nvidia-smi确认显卡可见。 - 拉取变声服务镜像,用
docker run --gpus all -p 8080:8080 镜像名启动服务。 - 生成测试音频:
ffmpeg -f lavfi -i sine=frequency=440:duration=5 -f wav test.wav。 - 按服务协议把测试音频推到服务端口,观察返回音频是否连续。
- 用监控看CPU、GPU、内存和音频队列,记录不同并发下的延迟。
验证时不要只看“服务是否启动”,要听返回音频有没有断续、爆音、变调异常,实时音频的问题,耳朵比日志更快发现。
变声系统服务器价格多少?成本构成与省钱思路
价格没有统一答案,因为云服务器、GPU实例、带宽和托管方式差异很大,可以按成本构成拆开看。
云服务器按量计费与包月包年的差异
按量计费适合活动、测试和波峰明显的业务,包月包年适合稳定在线服务,据工信部公开的云计算服务相关规范,按需计费模式适合业务量波动明显的应用,实际选型时,把高峰时段和低谷时段的账单拉出来对比,比只看单价更可靠。
GPU实例与CPU实例的价格分水岭
GPU实例通常比CPU实例贵不少,差距来自显卡型号、显存和算力,AI变声如果实时率要求不高,可以用CPU跑小模型;实时率要求高,再上GPU,混合部署是常见思路:前端接入用CPU实例,推理层用GPU实例,按队列长度扩缩容。
带宽和存储容易被忽略的隐性成本
- 公网带宽按流量或带宽计费,并发高时账单会明显上升。
- 模型文件和日志需要存储,长期运行要关注对象存储费用。
- 监控、备份和跨地域传输也会产生费用。
- 省钱思路:非实时训练放抢占式实例,实时推理用包月实例;音频日志按周期清理;地域节点按用户分布选,不要盲目多开。
变声系统服务器本地部署还是云服务器好?场景对比
这个问题没有绝对答案,要看团队规模、并发特征和数据要求。
小型团队与个人主播的轻量方案
小型团队和个人主播通常没有运维人力,一台云服务器加虚拟音频路由,就能跑通直播变声链路,优点是开通快、按需付费、出问题有云厂商基础监控,缺点是高并发时GPU成本上升,网络抖动需要自己调。
中大型语音平台的混合部署思路
中大型平台可以把接入层和推理层分开,接入层放在离用户近的云地域,推理层用GPU集群,按队列扩缩容,对数据敏感的模块放本地机房,非敏感模块放云上,这样既控制延迟,也控制成本。
国内变声系统服务器地域节点怎么选
国内选地域节点,重点看用户分布、备案要求和延迟测试结果。
- 用户集中在华东,优先选华东地域;华南用户多,再看华南节点。
- 用
ping和mtr从目标城市测试到候选节点,比较平均延迟和抖动。 - 涉及公网服务要处理备案和合规要求,别等上线后再补。
- 多地域部署会增加调度复杂度,先用单地域跑通,再按数据决定是否扩展。
变声系统服务器Q&A:部署前常被问到的三个问题
变声系统服务器需要独立显卡吗?
传统DSP变声和轻量音频处理不一定需要独立显卡,AI变声模型,尤其是实时率要求高的场景,通常需要GPU,判断方法是先看模型文档的硬件要求,再用单路音频压测;如果CPU推理延迟明显超标,再考虑GPU实例。
变声系统服务器能支持多少人同时变声?
同时变声人数取决于模型大小、音频格式、GPU显存、网络带宽和调度策略,不能只看显卡型号,建议用真实音频做阶梯压测,从低并发逐步加路数,记录延迟和失败率,找出稳定并发上限。
变声系统服务器有哪些开源方案可以自建?
常见的开源变声项目包括RVC、so-vits-svc等,它们通常提供推理脚本和模型训练流程,自建实时服务时,需要自己封装音频流接入、并发调度和端口管理,这些项目一般面向离线或半实时推理,直接用于生产级实时变声还要补上队列、监控和容错。
把类型、并发、延迟和成本四件事对齐,变声系统服务器就不难选。 多数团队先用云服务器跑通链路,再根据压测结果决定是否混合部署。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/776871.html