在服务器上跑Smart3D(现ContextCapture)的核心答案是:将建模计算任务从个人电脑转移到高配置服务器,通过远程桌面或命令行方式调用引擎节点完成空三解算和三维重建,本质上是让服务器替代工作站执行密集计算。
很多团队第一次接触Smart3D服务器部署时,会误以为只是装个软件那么简单,实际跑通一套流程,涉及主程序安装、引擎节点分发、数据存储规划、显卡驱动配置等环节,下面我按实际操作顺序,把整个部署过程拆开讲清楚。
smart3d服务器配置要求:先搞清硬件底线
CPU核心数决定空三速度
Smart3D的空三(空中三角测量)计算几乎是纯CPU密集任务,行业共识认为,每个引擎节点至少分配8个物理核心,否则大数据量项目会出现明显的排队等待,服务器端建议双路至强银牌及以上级别,比如常见的Intel Xeon Silver 4314或AMD EPYC 7543,具体看预算,内存方面,每8核配32GB内存是基准线,若处理带POS数据的倾斜影像,16GB内存会频繁触发虚拟内存交换。
- 操作系统建议Windows Server 2019/2026,Linux版本在部分模块上有坑,不建议新手尝试
- 系统盘用SSD,容量不低于500GB,缓存盘建议NVMe SSD
- 网络至少千兆内网,万兆更好
显卡是三维重建的隐形瓶颈
很多运维人员容易忽略显卡,Smart3D的纹理映射和生产三维网格阶段会调用CUDA加速,NVIDIA独立显卡是硬性要求,RTX 3060以上级别显卡,显存不低于12GB,没有独立显卡的服务器,跑纹理映射时CPU会长时间满载,产出速度成倍下降。
smart3d部署教程:从干净系统到能出模型
第一阶段:Windows Server环境准备
全新服务器拿到手,先做系统更新,安装完系统后,务必关闭IE增强安全配置(服务器管理器-本地服务器-IE增强的安全配置-关闭),否则浏览器下载软件包时一堆弹窗,接着开启远程桌面,方便后续操作,还要装好Visual C++运行库合集(2015-2026版本都勾上),这步忘了装,后面启动主程序会报缺少DLL。
第二阶段:主程序和引擎节点安装逻辑
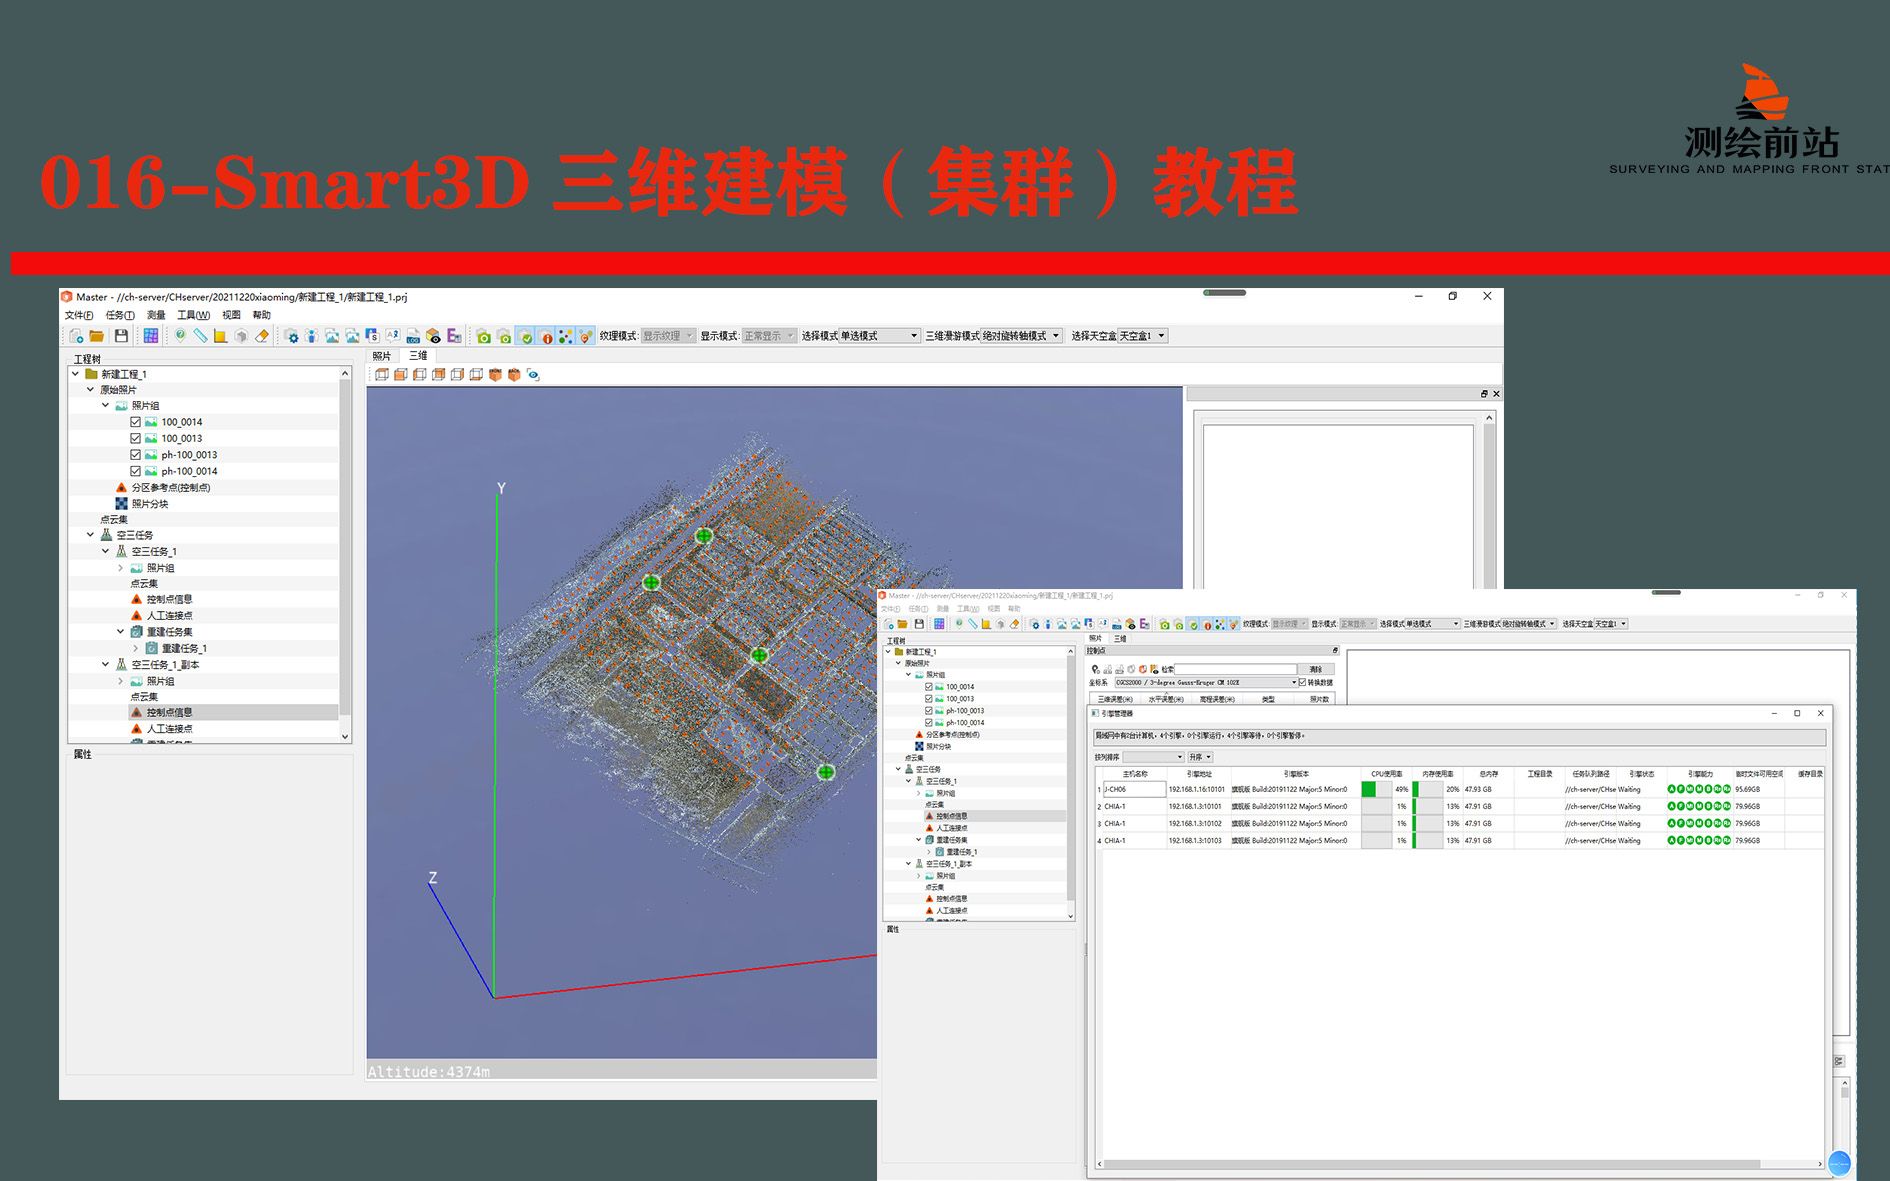
Smart3D的部署架构分两块:Master主程序和引擎节点(Engine),主程序负责创建任务、提交任务、预览成果;引擎节点是真正干活的进程。
- 在主服务器上安装ContextCapture Center Master
- 在计算节点上安装ContextCapture Center Engine
- 所有节点安装时,关闭Windows防火墙或设置入站规则放行TCP端口,默认端口是8080和8081
- 主程序和引擎节点需要同一个版本号,否则提交任务时报版本不匹配
第三阶段:许可证服务器配置
License服务器可以单独部署,也可以装在主程序所在机器。关键操作是将License文件放到指定目录并重启服务,在服务列表中找到Sentinel LDK License Manager服务,重启后确认状态为Running,若提示License不可用,检查网卡MAC地址是否和申请时一致。
数据存储路径规划:不然后期会崩溃
项目文件存放策略
Smart3D处理的项目文件结构复杂,一个中等规模倾斜摄影项目(比如2平方公里,分辨率为3cm)会产生约200-400GB的中间数据,这些中间文件包括:
- 空三加密点云文件
- 分块瓦片模型
- 纹理映射临时贴图
- 日志文件
建议直接在服务器硬盘上建立固定工作目录,比如D:\Smart3DProjects,不要放在桌面或C盘用户目录,否则清理临时文件时容易误删项目文件,引擎节点的输出路径需要和主程序共享访问权限,用Windows共享文件夹或NAS挂载都可以。
存储性能差异对跑图的影响
机械硬盘组RAID5和NVMe固态,在跑引擎节点时效率差距明显,行业共识认为,IO瓶颈会拖慢引擎计算速度,特别是纹理映射阶段,需频繁读写海量小文件,有条件直接上全闪存储,退一步就用SATA SSD组RAID10。
引擎节点分布策略:该开几个引擎?
按机器核心数合理配置
每台服务器可以启动多个引擎实例,但要遵循规矩,假设你有一台32核服务器,建议启动4个引擎,每个引擎分配8核,这样单个引擎崩溃时,其他引擎还能继续跑,在引擎节点设置界面可以调整工作进程数量和内存上限。
| 服务器核心数 | 建议引擎数 | 每个引擎分配核心 | 内存需求 |
|---|---|---|---|
| 16核 | 2 | 8 | 64GB |
| 32核 | 4 | 8 | 128GB |
| 64核 | 8 | 8 | 256GB |
多台服务器协同计算
多台服务器组成计算集群时,注意引擎节点名称不能重复,在引擎设置里修改计算机标识,然后主程序提交任务时,会看到所有可用的引擎节点。负载均衡由主程序自动调度,无需手动分配任务。
显卡在服务器架构中的角色再解构
显存占用大户是谁
纹理映射阶段会把影像贴图加载到显存,显存不足会直接报错CUDA out of memory,RTX 3090 24GB显存可以处理大部分项目,但如果航拍影像导入时没有压缩,4K原图会让20GB显存都吃紧,这时候需要在处理设置里开启纹理压缩,或降低每个引擎的并行任务数。
双显卡服务器怎么配置
部分服务器主板支持多张显卡,可以一张卡负责显示输出,另一张专用于CUDA计算,在NVIDIA控制面板中指定GPU用途,计算卡不要接显示器,如果不做这个设置,渲染进程可能自动使用主显示卡,导致两个卡负载不均。
smart3d处理倾斜摄影数据的性能调优
提交任务前的三个关键参数
提交生产任务定义时,不要直接点提交,依次检查以下参数:
- 分块大小:重建模型时,分块尺寸默认是100米乘100米,大范围测区建议调大到200米,减少拼接接缝次数;机器内存小则改小到50米,避免OOM
- LOD等级:如果只是预览,选低LOD能大幅缩减处理时间
- 输出坐标系:确认和原始POS数据的坐标系一致,不然后期模型位置偏移,返工成本极高
日志排查思路
跑图卡住的第一步是看日志,Smart3D日志存在C:\ProgramData\ContextCaptureCenter\Logs目录下,按日期生成,常见错误如:
Tile failed通常意味着该块显存耗尽或数据损坏License checkout failed说明许可证通道被占用Network path not found表示共享路径权限掉了
根据日志行号定位到具体哪块区域出错,可以单独重跑该分块,无需全工程重建。
Q&A:smart3d服务器部署常见疑问解答
smart3d服务器配置要求中,显卡必须用专业卡吗?
不必需,游戏卡(GeForce系列)和计算卡(Tesla系列)都能运行CUDA加速模块,游戏卡性价比更高,RTX 3080/3090即可满足绝大多数倾斜摄影建模需求,专业卡的优势在于大显存和长时间稳定性,适合7×24小时连续跑任务的场景。
服务器上跑smart3d时,引擎节点可以跨网段运行吗?
可以,但需要在主程序和引擎节点之间配置路由,引擎节点连接主程序时,手动填写主程序IP地址。跨公网跑引擎节点不推荐,数据上行带宽和延迟会严重影响空三计算效率,局域网内协同部署效果最佳。
引擎节点在服务器上跑任务时崩了,怎么恢复?
引擎节点崩溃时,主程序会标记该任务块为失败状态,不自动重试,这时在任务监控界面找到失败块,右键选择重跑该块,如果频繁崩溃,检查系统事件查看器中是否有内存访问冲突错误,通常指向硬件不稳定或驱动缺陷,数据中心环境下,建议先更新NVIDIA驱动到最新稳定版,再检查内存条的ECC校验功能是否开启,按此顺序排查能解决绝大多数引擎崩溃问题。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/776876.html