开篇直接给答案
一台服务器做主从,核心就一句话:不需要两台物理机,用虚拟化或容器技术把一台服务器拆成两个独立环境,分别部署主库和从库,再开启MySQL或Redis的原生复制功能即可。这样既省了硬件成本,又能拿到读写分离和故障切换的能力,下面这套方案,是2026年中小企业最常用的单机主从落地方案,照着做就能跑通。
为什么要在一台服务器上做主从?先看场景再动手
很多人第一次听到“单机主从”会觉得矛盾:同一台机器上搞主从,万一机器宕机不照样全挂?这个质疑没错,但单机主从解决的不是“物理容灾”,而是逻辑层面的故障隔离和读写压力拆分。
单机主从的三个典型适用场景
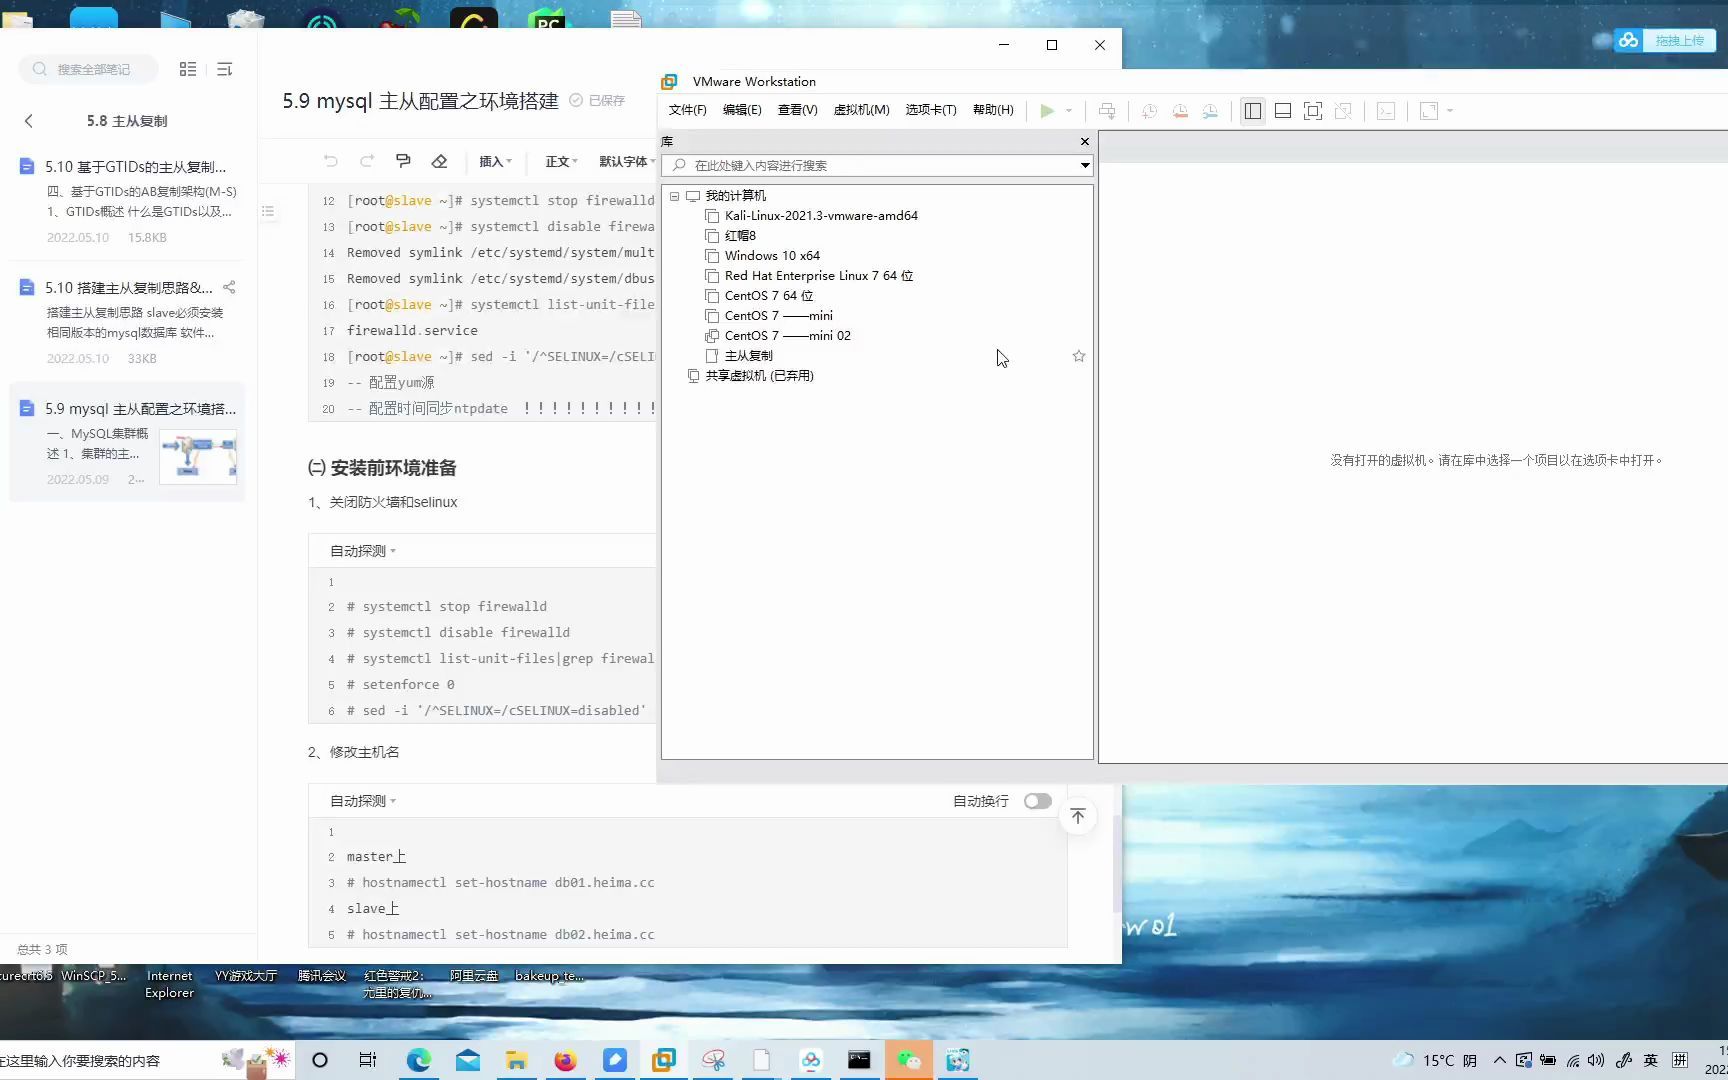
- 开发测试环境:产品要上线,测试库需要模拟生产的主从架构,但公司没预算批两台服务器,用一台8核16G的云主机,通过Docker跑两个MySQL实例,就能完整验证主从复制、半同步、GTID切换这些逻辑。
- 中小型业务读写分离:日活不过万,数据库QPS压在2000以内,单机主从把读流量分流到从库,主库专心处理写事务,能明显降低锁等待,行业共识认为,这种规模下单机主从能撑住绝大多数创业期业务。
- 低成本高可用演练:用Keepalived或ProxySQL在单机两个实例间做自动切换,先练熟故障转移流程,后续扩容到多机时直接复用这套配置。
单机主从的硬性限制,看完再决定
- 共享计算资源:主从共用CPU和内存,从库做复杂分析查询时可能拖慢主库写入。
- 磁盘IO竞争:主库写binlog、从库写relay log和自身binlog,都落在同一块盘上,机械硬盘建议直接放弃,至少用SSD。
- 不解决物理宕机:宿主机断电、硬件损坏时,主从一起消失,它只防“实例崩溃”和“误操作”,不防“服务器没了”。
如果业务QPS超过5000,或者数据量单表超过5000万行,别犹豫,直接上两台物理机,单机主从只在预算敏感或环境验证阶段才值得用。
单机主从的两种主流实现方式:Docker容器 vs 多实例部署
选哪种方案,取决于你用不用容器化,下面把两条路都讲透。
方案A:Docker Compose拉起MySQL主从(推荐,最省事)
这是目前网上讨论最多、也是实操成功率最高的方式,Docker让两个MySQL实例跑在独立的容器里,端口、数据目录、配置全部隔离。
具体步骤如下:
- 准备docker-compose.yml文件,定义两个服务,主库映射3307端口,从库映射3308端口,都挂载独立的数据卷到宿主机目录。
- 主库配置:启用
log-bin=mysql-bin,设置server-id=1,开启gtid_mode=ON和enforce_gtid_consistency=ON,GTID模式比传统binlog位点复制更省心,切换时不用手动定位日志位置。 - 从库配置:设置
server-id=2,其他参数保持默认,注意从库不要配置read_only=0,否则测试时容易误写入数据。 - 启动容器后,在主库执行
CREATE USER 'repl'@'%' IDENTIFIED BY '密码';并授权REPLICATION SLAVE。 - 主库查询状态:执行
SHOW MASTER STATUS\G;拿到当前GTID集合。 - 进入从库容器,执行
CHANGE MASTER TO指定主库的IP地址和端口,关键点:主库地址不能写0.0.1,要写Docker网络的网关IP,或者直接用容器服务名(如mysql-master:3306)。 - 启动复制:
START SLAVE;然后SHOW SLAVE STATUS\G看Slave_IO_Running和Slave_SQL_Running是否都是Yes。
这套方案最容易被坑的点是两个容器挂载到同一目录导致数据覆盖,务必分开指定./data/master和./data/slave两个目录。
方案B:CentOS上原生多实例部署(适合生产环境裸机)
不想用Docker的团队,可以在一个Linux系统里直接跑多个mysqld进程,虽然步骤繁琐,但性能损耗最小,适合配置较高的物理机。
关键步骤:
- 使用
mysqld --initialize-insecure分别初始化两个数据目录,例如/data/mysql-master和/data/mysql-slave。 - 准备两份my.cnf,用
--defaults-file参数区分启动,每份配置里必须写不同的server-id、端口、socket文件和pid文件。 - 主库开启日志,从库设置只读。
- 从库复制时,通过主库的3307端口连接,因为同一台机器走TCP回环,速度比跨机更快。
深度实战:配置从库时最容易翻车的三个细节
很多人照着教程做,死活复制不上,90%的坑都出在下面三处。
防火墙和端口映射
Docker启动容器时,-p 3307:3306只映射了宿主机端口,但容器内部主从通信走的是容器间的自定义网络,如果你用了network_mode: host,那就要确保宿主机的3306和3307端口都没被防火墙拦,常见报错是Can't connect to MySQL server on 'x.x.x.x' (10060),多半是防火墙没放行。
从库的server-id冲突
同一套复制架构里,每个实例的server-id必须全局唯一,如果默认值都是1,从库启动复制时会报错Fatal error: The slave I/O thread stops because master and slave have equal MySQL server UUIDs,特别是用克隆镜像或复制数据目录的方式部署实例时,连UUID都会一样,需要手动删除auto.cnf文件重启实例。
主库binlog格式的选择
行业共识推荐使用binlog_format=ROW,相比Statement格式,ROW模式记录每一行数据的变化,从库执行时更安全,不会因为函数、触发器导致主从数据不一致,但代价是binlog文件体积更大,一台单机上做复制,磁盘占用增加30%左右,用GTID模式配合ROW格式,是2026年最稳妥的组合。
高可用进阶:一台服务器上的主从自动切换
主从复制搭好后,还有最后一环:主库崩了,怎么让从库自动顶上?单机场景下不需要上MHA这种重量级方案,用Keepalived加简单脚本就够。
架构和切换逻辑
- 两个MySQL实例各自分配一个虚拟VIP地址,正常情况下VIP绑定在主库。
- Keepalived每两秒做一次健康检查,通过
mysqladmin ping检测主库存活。 - 当连续三次检查失败,虚拟IP漂移到从库,同时从库执行
STOP SLAVE; RESET SLAVE ALL; SET GLOBAL read_only=OFF;把自己提升为主库。 - 业务侧连接的是VIP,完全感知不到后端切换。
使用表格对比两种切换工具
| 对比项 | Keepalived + 脚本 | ProxySQL |
|---|---|---|
| 实现复杂度 | 较低,纯系统层面配置 | 较高,需部署额外的代理服务 |
| 读写分离支持 | 需要应用层二次改造 | 原生支持,自动路由读写流量 |
| 故障切换时间 | 3-10秒 | 毫秒级 |
| 是否适合单机双实例 | 非常适合 | 功能过剩,单机场景用不上 |
单机场景下,Keepalived方案的性价比最高。
Q&A:单机主从最常被问到的三个问题
一台服务器做MySQL主从,到底能提升多少性能?
单机主从的读写分离能降低主库的锁竞争,读操作被从库分担后,主库的写入吞吐大约可以提升30%-50%,但查询性能不会翻倍,因为CPU和内存是共享的,遇到慢查询照样拖垮两个实例,如果测试时发现性能提升不明显,优先排查慢查询日志,看看是否有大查询把CPU打满。
一台服务器做主从,和用云数据库的只读实例有什么区别?
云数据库只读实例本质上也是主从复制,但底层物理机分离,具备独立的计算和IO资源,单机主从的优势是零额外硬件成本,操作完全自主可控,云只读实例的优势是运维托管、故障自动恢复、监控更完善,但价格通常占主实例费用的50%左右,预算敏感阶段用单机方案练手,业务稳定后再迁移到云只读实例,是不少团队的成长路径。
主从数据延迟太大,单机上怎么排查?
在从库执行SHOW SLAVE STATUS,重点关注Seconds_Behind_Master字段,单机延迟多数情况下是CPU争抢或磁盘IO占满导致的,优化建议:从库关闭sync_binlog和innodb_flush_log_at_trx_commit,将值设为0或2;同时把从库的innodb_buffer_pool_size调小,给主库留足内存,如果延迟持续超过30秒,检查是否有人在从库执行了全表扫描。
单机主从是一套花小钱办大事的过渡方案,用Docker两条命令就能拉起主从,配合GTID和Keepalived,能在不增加一分钱硬件成本的前提下,让开发环境贴近生产架构、让小业务获得读写分离能力,当单机达到性能天花板时,这套主从配置逻辑可以无缝平移到多台服务器,动手搭一遍,比看十篇文章都管用。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/778620.html