性能测试服务器没有“万能款”,压测工具跑得动、网络不拖后腿、成本压得住,就是合适的机器。业内常见的做法是先按压测类型选服务器形态,再按并发量倒推配置,最后用云厂商的按量计费做成本兜底。
性能测试服务器到底分哪几类
性能测试服务器不是单一产品,它是一组按使用方式划分的资源,选型前先把这几类搞清楚,后面谈配置和价格才不会跑偏。

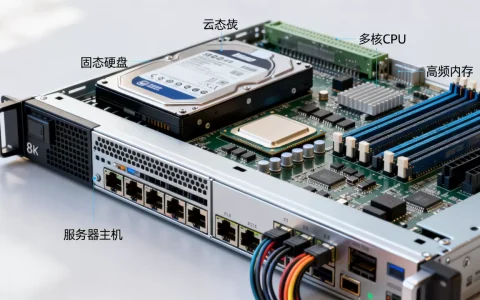
物理机:压测界的“老黄牛”
物理机是自建机房或 IDC 托管的那类机器,CPU 独享、内存独享、网卡独享,压测时不会因为邻居抢资源导致数据抖动。
- 适合场景:上万并发的稳定性压测、长时间浸泡测试、需要固定公网 IP 做白名单的场景
- 典型配置:双路至强银牌以上、64GB 到 128GB 内存、万兆网卡
- 操作路径:装好 JMeter 或 Locust 后,用
nmon或sar -n DEV 1盯网络吞吐,用pidstat -u 1看压测进程的 CPU 占用 - 短板:采购周期长,短期压测用完就闲置,成本摊不平
云服务器:灵活性换来的性价比
云服务器按小时或按月计费,压测前开机器、压测后释放,是国内多数团队的默认选择,业内专家指出,压测类负载有明显的“脉冲特征”,用包年包月去买高配机器并不划算。
- 适合场景:版本迭代中的回归压测、临时扩容的峰值验证
- 关键指标:内网带宽、ECS 实例的 CPU 积分机制(突发性能实例在持续压测下会掉频)
- 操作路径:压测机和被测机放在同一可用区,走内网通信,避免公网带宽成为瓶颈
容器化压测节点:弹性最好但坑也不少
用 Kubernetes 起一批压测 Pod,按需扩缩容,优点是调度快,缺点是对网络和 CPU 的限制需要额外配置。
- 注意点:
resources.limits里的 CPU 上限会把压测进程掐住,压测 Pod 的requests要和limits设成一致 - 网络:容器网络走 overlay 会有额外开销,压测高并发 HTTP 时建议用 hostNetwork 模式
压测 SaaS 平台:省事但可控性弱
云端压测服务开箱即用,适合快速验证接口性能,但脚本定制能力有限,遇到复杂登录态、加密参数往往要绕路。
性能测试服务器怎么选性价比高
这个问题在百度上的搜索量一直不低,本质是“花多少钱办多少事”,先把三件事摸清楚,再谈配置。
第一步:算清楚压测目标并发
不要上来就问“多少核够用”,先明确压测要打出的目标 TPS 或并发用户数,再倒推压测机数量。
- 经验值:一台 4 核 8GB 的压测机,用 JMeter 打 HTTP 短连接,稳定输出大概在几百到一千 TPS 量级,具体取决于脚本复杂度和断言数量
- 如果目标是上万 TPS,单机扛不住,要用多台压测机做分布式,JMeter 的 master-slave 模式或 Locust 的
--master/--worker参数都能实现
第二步:压测机配置别踩这几个坑
配置不是越高越好,错配比低配更浪费钱。
- CPU:压测工具本身吃 CPU,尤其是带加密、正则提取、JSON 解析的脚本,2 核跑简单接口够用,复杂脚本建议 4 核起步
- 内存:JMeter 默认堆内存偏小,改
jmeter脚本里的HEAP参数,一般设到物理内存的一半左右 - 网络:压测机网卡带宽要大于目标吞吐量,千兆网卡理论峰值约 125MB/s,打大响应体的接口很容易先撞网卡上限
- 磁盘:压测结果文件(jtl、csv)写多了会占空间,
jmeter -n -t test.jmx -l result.jtl跑几小时能写出几个 GB,别把盘塞满
第三步:按量计费 + 快照复用
短期压测最省钱的路子是:买按量计费的云服务器,压测前用自定义镜像或快照恢复环境,压完直接释放。
- 操作路径:控制台创建自定义镜像 → 压测当天用镜像开实例 → 压测结束导出报告 → 释放实例
- 这样既不用长期养机器,也不用每次重装压测环境
本地部署和云服务器做性能测试哪个好
这是选型时绕不开的对比,一句话结论:内网压测优先本地或同可用区云机器,跨地域压测用云服务器更省心。
| 对比维度 | 本地物理机 | 云服务器 |
|---|---|---|
| 网络可控性 | 强,可完全掌控交换机与防火墙 | 受安全组和公网带宽限制 |
| 弹性 | 差,扩容要采购 | 强,分钟级开通 |
| 成本结构 | 一次性投入高,长期摊薄 | 按量付费,短期便宜 |
| 数据抖动 | 小,资源独享 | 有,共享宿主机存在邻居干扰 |
| 适用周期 | 长期、反复压测 | 短期、临时验证 |
行业共识认为,压测结果的可靠性首先取决于压测环境和生产环境的网络拓扑是否接近,如果生产跑在云上,压测机也放云上同一地域,测出来的网络延迟才更有参考价值。
电商大促压测服务器配置要求有哪些硬指标
电商场景的压测特点是:瞬时并发高、链路长、依赖多,这类压测对服务器的要求集中在三块。
并发连接数比 CPU 更先到瓶颈
大促压测经常要模拟几万个并发连接,Linux 默认的文件描述符上限是 1024,压测机必须先调。
- 临时调整:
ulimit -n 65535 - 永久生效:改
/etc/security/limits.conf,加soft nofile 65535和hard nofile 65535 - 内核参数:
net.ipv4.ip_local_port_range调大本地端口范围,net.ipv4.tcp_tw_reuse开启 TIME_WAIT 复用
压测机要分散在不同可用区
单可用区的压测机同时打目标服务,容易把目标服务的入口带宽打满,测出来的是带宽瓶颈而不是应用瓶颈,多可用区部署压测节点,能更真实地模拟用户分布。
监控要跟上,别只看压测报告
压测机自己也要被监控,CPU 打满、网卡跑满、GC 频繁,都会让压测数据失真。
- 压测期间用
top -Hp <pid>看压测进程的线程级 CPU 占用 - 用
ss -s看连接状态统计,确认没有大量连接卡在 SYN_RECV
北京性能测试服务器租赁价格大致什么水平
地域词背后是真实的价格差异,北京地区的 IDC 资源和云厂商节点密集,租赁价格在国内属于中等偏上水平,主要贵在机位和带宽。
- 物理机托管:北京周边 IDC 的单机柜租赁,按机位和带宽计费,万兆带宽的单价明显高于二三线城市机房
- 云服务器按量计费:北京地域的通用型实例,4 核 8GB 规格按小时计费,短期压测几天下来成本可控
- 包月价格:同规格包月会比按量计费便宜不少,但压测属于脉冲负载,包月容易浪费
实际询价时注意问清楚三件事:带宽是独享还是共享、是否含公网 IP、超出流量怎么计费,这几年云厂商的价格战让按量计费的门槛降了不少,短期压测完全可以用按量实例加自定义镜像的方式控制预算。
性能测试服务器的选型逻辑其实很朴素:压测工具跑得动、网络路径接近生产、成本跟压测周期匹配,把这三条对齐,配置表上的数字才有意义,先明确目标并发和压测时长,再决定用物理机、云服务器还是容器节点,比直接抄别人的配置单靠谱得多。
关于性能测试服务器的常见问题
性能测试服务器和普通应用服务器有什么区别?
压测机是“施压方”,它的负载特征是 CPU 密集加网络密集,且瞬时波动大;应用服务器是“承压方”,关注的是请求处理能力和稳定性,两者选型指标不同,压测机更看重单核性能和网卡吞吐,不需要大容量存储和高可用架构。
压测机需要和被测服务器同配置吗?
不需要,也不应该,压测机的配置目标是稳定打出目标压力,配置过高或过低都会让压测数据失真,正确做法是先做压测机自身的容量验证,确认单台压测机在目标脚本下的极限 TPS,再决定用几台压测机。
云服务器做性能测试,公网带宽怎么选?
压测机和被测服务在同一地域时走内网,公网带宽只影响你自己远程登录和拉取报告,选最低档即可,只有跨地域压测或压测公网入口时,公网带宽才需要按目标吞吐量估算,并且要预留余量,因为云厂商的公网带宽是峰值计费。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/783513.html