限流并不是“挡住请求”,而是把系统能力用在刀刃上
高并发场景下服务端限流的做法,核心是“分层设卡、按维度计量、算法选型匹配业务形态”:接入层用 Nginx 做粗粒度防护,网关层做统一配额,应用层用令牌桶或滑动窗口保核心接口,数据层再兜一层连接数保护。先把限流点布对,再谈算法和阈值,否则再精巧的实现也只是在错误的位置止损。
限流解决的问题很具体:流量超过系统处理能力时,与其让所有请求一起变慢最后集体超时,不如主动放弃一部分请求,保住大多数人的正常体验,要让它真正生效,先要回答两个前置问题。
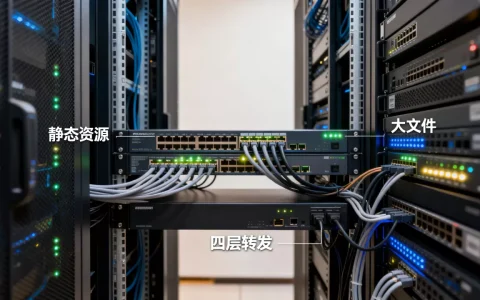
- 限在哪一层:接入层(Nginx、负载均衡)、网关层(API Gateway)、应用层(业务接口)、数据层(数据库连接池、Redis 连接数),四层各有分工。
- 按什么维度限:QPS、并发线程数、连接数、请求体大小、用户维度、IP 维度、租户维度,维度选错,会误伤正常用户或漏放热点请求。
主流限流算法有哪些,令牌桶与漏桶限流算法怎么选
限流算法是底层工具,选错了要么浪费机器,要么突发流量一来就雪崩。
计数器与滑动窗口
固定窗口计数器实现最简单:按秒计数,超过阈值就拒绝,问题在于窗口边界会放过双倍流量,1 秒末和下 1 秒初各来一波峰值,滑动窗口把统计区间切成多个小格滚动累加,缓解了边界突刺,实现复杂度中等,适合大多数业务接口的 QPS 控制,Redis 里常用 ZSET 记录请求时间戳,或者用分片计数减少单 key 压力。
漏桶:恒定出水,流量整形
漏桶的模型是水以固定速率流出,桶满了就溢出,它天然把请求整形成匀速流量,适合对接下游处理能力固定且不能突发的场景,比如第三方支付回调、老系统接口,代价是突发流量会被排队或丢弃,尾延迟变大。
令牌桶:允许突发,最常用
令牌桶按固定速率往桶里放令牌,桶有容量上限,请求拿到令牌才能通过,它允许一定程度的突发,桶容量就是突发额度,绝大多数业务接口、开放平台 API 都更适合令牌桶,单机场景 Google Guava 的 RateLimiter 就够用,集群场景要靠 Redis + Lua 保证原子性。
算法对比
| 算法 | 突发流量支持 | 实现复杂度 | 流量平滑度 | 典型适用场景 |
|---|---|---|---|---|
| 固定窗口计数 | 差 | 低 | 差 | 内部低频接口、粗粒度保护 |
| 滑动窗口 | 中等 | 中 | 较好 | 业务接口 QPS 控制 |
| 漏桶 | 不支持 | 中 | 最好 | 下游能力固定的整形场景 |
| 令牌桶 | 支持 | 中 | 较好 | 开放 API、电商下单、秒杀入口 |
行业共识认为,没有哪一种算法能通吃所有场景,选型要看业务能不能接受突发、下游是否需要匀速,业内专家指出,很多线上事故的根因在于把限流阈值配得过高,或者只做了单机限流没有做全局配额,导致机器扩容后总放行量线性放大。
单机限流落地:配置和代码怎么写
单机限流是最后一道防线,也是实现成本最低的一层。
Nginx 接入层限流配置
Nginx 自带 limit_req 和 limit_conn 两个模块,适合放在流量入口做第一道粗筛。
http {
    limit_req_zone $binary_remote_addr zone=api:10m rate=100r/s;
    limit_conn_zone $binary_remote_addr zone=conn:10m;
    limit_req_status 429;
    limit_conn_status 429;
    server {
        location /api/ {
            limit_req zone=api burst=200 nodelay;
            limit_conn conn 50;
            proxy_pass http://backend;
        }
    }
}
rate=100r/s 是平均速率,burst=200 是允许的突发队列长度,nodelay 表示突发部分立即放行而不是排队,注意 limit_req_zone 的 key 用 $binary_remote_addr 比 $remote_addr 省内存,在 NAT 出口多的场景要换成 $http_x_forwarded_for 或用户 ID,否则一批用户会共用同一个桶。
应用层限流代码
Guava 方式适合单机快速接入:
RateLimiter limiter = RateLimiter.create(200); // 每秒 200 个令牌
if (limiter.tryAcquire(50, TimeUnit.MILLISECONDS)) {
    return doBusiness();
}
throw new RuntimeException("当前请求过多,请稍后重试");
阿里开源的 Sentinel 更适合需要动态规则、控制台可视化、熔断降级一起用的团队,一条 QPS 流控规则大概是这样:
FlowRule rule = new FlowRule();
rule.setResource("orderCreate");
rule.setGrade(RuleConstant.FLOW_GRADE_QPS);
rule.setCount(200);
rule.setControlBehavior(RuleConstant.CONTROL_BEHAVIOR_DEFAULT);
FlowRuleManager.loadRules(Collections.singletonList(rule));
Sentinel 的 WARM_UP 模式适合冷启动预热,RATE_LIMITER 模式对应匀速排队,能直接复用漏桶思路。
微服务网关限流配置怎么做
网关限流的价值在于“统一收口”,配额规则集中管理,不用每个服务各写一遍,以 Spring Cloud Gateway 为例,配合 Redis 做分布式令牌桶:
spring:
  cloud:
    gateway:
      routes:
        - id: order-service
          uri: lb://order-service
          filters:
            - name: RequestRateLimiter
              args:
                redis-rate-limiter.replenishRate: 100
                redis-rate-limiter.burstCapacity: 200
                redis-rate-limiter.requestedTokens: 1
                key-resolver: "#{@userKeyResolver}"
replenishRate 对应令牌生成速率,burstCapacity 对应桶容量。userKeyResolver 决定限流维度,按用户、按 IP、按租户都行,网关层适合做“全局配额 + 用户级配额”两层,全局兜住总入口,用户级防止单账号刷接口。
分布式限流怎么保证不超发
单机令牌桶在多实例部署时,总放行量等于实例数乘以单机阈值,扩容就会放大流量,常见做法有三种。
- Redis + Lua 集中计数:所有实例向同一个 key 申请令牌,Lua 脚本保证取令牌和写回是原子操作,优点是准确,缺点是每次请求多一次 Redis 往返,要控制在核心接口使用。
- 本地配额预分配:中心节点按实例数把每秒配额切分下发,各实例本地消耗,定时续借,减少网络开销,代价是实例负载不均时会有浪费。
- 两级限流:本地令牌桶先挡一道,热点 key 汇总上报,中心侧超过阈值后再下发收紧指令,适合流量大、对精度要求不极端苛刻的场景。
北京不少电商团队在大促压测中发现,单纯依赖单机限流时,扩容到几十个实例后总放行量远超数据库承载上限,后来改成网关集中配额加应用本地下沉的组合才稳定下来。
云厂商限流方案价格差异大吗
这是预算敏感团队最关心的问题,限流能力在云上通常不单独售卖,而是打包在 API 网关、流量防护、微服务治理这类产品里,计费方式大致分三种:按 QPS 阶梯计费、按实例规格包年包月、按调用次数计费,价格差异主要来自附加能力,比如是否包含全链路压测、日志存储时长、多可用区高可用和 SLA 承诺,基础限流逻辑用开源组件自建,成本主要是人力和 Redis 资源;购买托管能力省的是运维和排障时间,小团队用 Sentinel 加 Nginx 组合起步,往往比直接上商业流量防护产品更划算,等业务量级和合规要求上来再考虑替换。
阈值怎么定,被限流的请求怎么处理
阈值不是拍脑袋定的,要靠压测数据倒推。
- 用 JMeter 或 wrk 对单实例做阶梯加压,记录 QPS 与 P99 延迟的拐点。
- 取拐点数值的七到八成作为单机安全阈值,留出余量给 GC 和慢查询。
- 核心接口按链路最短板设定,比如下单链路受数据库连接池限制,阈值就不能只看应用层。
- 规则上线后观察 429 比例,持续偏高说明阈值偏紧或存在异常流量。
被限流之后的处理同样重要,金融类接口适合快速失败返回明确错误码,让客户端重试;查询类接口可以短暂排队;非核心接口直接降级返回兜底数据,拒绝时返回 429 并带上 Retry-After 头,客户端才有依据做退避。
近年来服务端限流的一个明显变化是,大家不再只盯着 QPS,而是把 CPU 使用率、线程池排队数、慢调用比例一起纳入判断,自适应限流会根据系统负载动态调整放行量,Sentinel 的系统规则、阿里开源的 adaptive 思路都属于这一类。
高并发场景下服务端限流常见问答
单机限流和分布式限流一定要同时上吗
不一定,但多数中大型系统会同时使用,单机限流成本低、无网络依赖,能防住单实例被突发流量打垮;分布式限流保证集群总放行量可控,只做单机限流,扩容后总流量会线性放大;只做分布式限流,Redis 抖动时缺少本地兜底。
令牌桶的桶容量应该设多大
桶容量决定突发额度,设成平均速率的 1 到 3 倍是常见区间,具体要看下游能承受多长时间的突发,秒杀入口可以放宽到数秒的量,数据库直连的接口要收紧,容量过大等于没有限流,容量过小则正常突发也会被拒。
限流规则应该多久调整一次
没有固定周期,大促前、版本发布后、业务量级跳变时都需要重新评估,日常可以通过监控告警驱动调整,当 429 比例或系统负载持续突破预设水位时触发复核,规则调整要走灰度,先在小流量实例生效观察,再全量下发。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/784747.html