PPC服务器不可用,大多数时候不是硬件报废,而是网络链路中断、资源耗尽、配置变更或服务进程异常这几类软性问题在捣乱。 排查时按从外到内的顺序来:先看网络,再看端口和服务进程,最后查配置和资源压力。
ppc服务器无法连接怎么办五步排查顺序
当PPC系统突然访问不了,不要急着重启服务器,先按顺序走完这五步,大多数连接问题都能定位到具体环节。
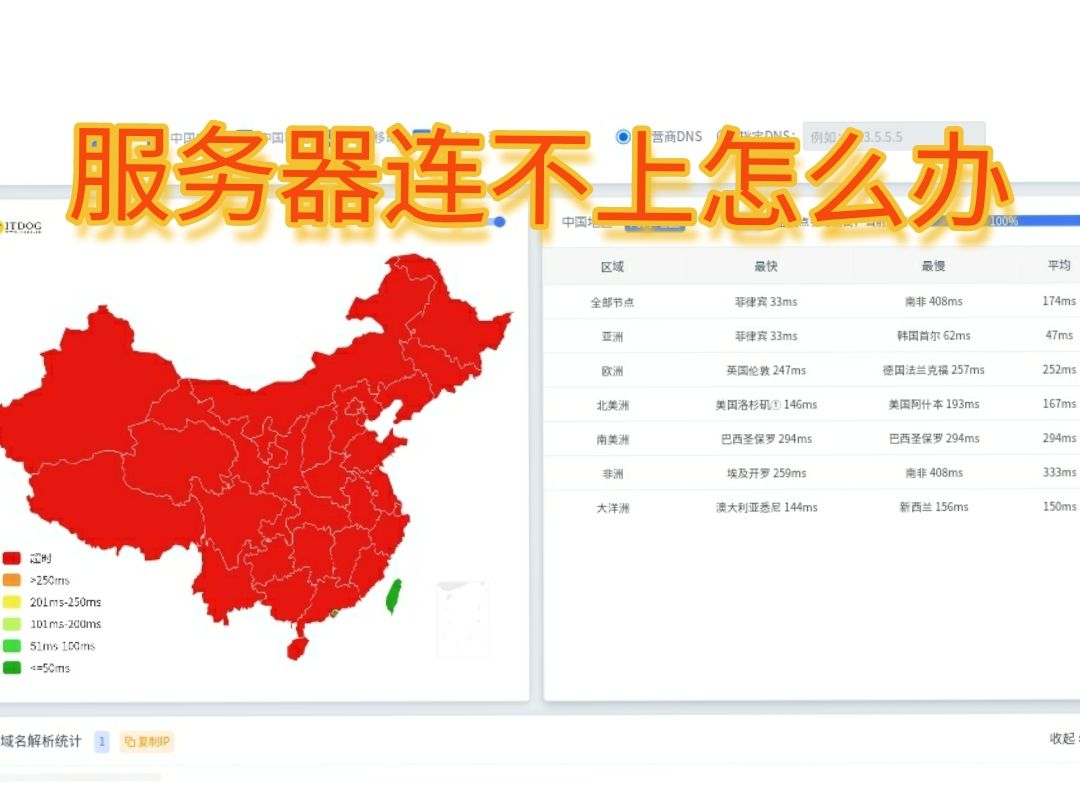
第一步:确认网络层通不通
ping一下服务器IP,观察丢包和延迟情况,如果延迟超过100ms或者有丢包现象,说明网络链路已经有明显问题。
ping能通,不代表服务正常,ping走的是ICMP协议,而PPC服务通常走TCP端口,两者互相独立,完全可能ICMP正常但TCP握手失败,这是排查时需要记住的关键差异。
第二步:验证端口有没有监听
用 telnet 命令测试服务器IP和端口号,看能否建立连接,连接被拒绝,说明服务进程可能没起来,连接超时,多半是防火墙拦截。
实际操作中,输入 telnet 服务器IP 端口号 后,看到Connected to的字样就代表端口正常开放,如果卡在Trying阶段不动,说明路由或防火墙层面有拦截。
第三步:检查服务进程状态
登录服务器,执行 systemctl status 服务名 查看进程运行状态,进程不在,直接重启服务,然后立即查看日志,确认启动过程中有没有报错。
日志文件通常放在 /var/log/ 目录下,用 tail -f 盯着最新日志输出,能快速看到服务启动到哪一步出了岔子。
第四步:扫一遍防火墙和安全组
Linux下用 iptables -L 查看规则是否放行了所需端口,云服务器还要额外检查控制台里的安全组配置,安全组规则和系统防火墙是两层逻辑,任何一层拦了都进不去。
不少用户踩过这个坑:系统防火墙放行了端口,但云控制台里的安全组没配,业务就一直是拒绝连接状态,两头都要看,缺一不可。
第五步:确认域名解析结果
如果PPC系统是通过域名访问,用 nslookup 域名 检查解析结果是否指向正确IP,DNS记录被误改或缓存过期,会让客户端访问一个根本不存在的地址,表现就很像服务器不可用。
这五步走完,绝大多数连接层的问题都能水落石出,如果五步都正常但业务还是报错,那就要往应用层深挖,比如数据库连接池耗尽、中间件内存溢出这类更隐蔽的问题。
ppc服务器延迟高什么原因性能瓶颈从这三个地方找
连接能建立,但操作卡顿、响应缓慢,这类现象比彻底连不上更常见,延迟高的原因集中在带宽、硬件资源和物理距离三个方面。
带宽跑满:最常见也最隐蔽
PPC广告投放模型的流量峰值往往出现在整点时段,多个任务同时抢带宽,上行带宽一旦被打满,客户端收到的每个响应包都要排队。
用 iftop 或 nload 实时查看流量占用情况,若上行带宽接近上限,先限流再扩容,常见做法是给任务队列加限速参数,把峰值流量削掉一部分,待带宽扩容完成后再放开限制。
CPU和内存接近满载
服务器打工人也会有累垮的时候,CPU长期跑在80%以上,内存使用率超过90%,系统只能靠swap硬撑,性能断崖式下跌。
top 命令按CPU占用排序,找出占用最高的进程,确认是业务主进程还是异常进程,如果是被入侵挖矿的异常进程,处理方式先断网再清杀,别手软。
除了CPU和内存,还要看磁盘IO,机械硬盘在大量随机读写时性能急速下降,换成SSD后延迟能减少一个量级,用 iostat 查看磁盘等待时间,io等待比例过高就说明磁盘在拖后腿。
连接数限制:另一种形式的卡顿
系统文件句柄数和端口范围有限制,输入 ulimit -n 查看文件句柄上限,用 sysctl net.ipv4.ip_local_port_range 查看端口范围,高并发场景下,连接数打满后服务器会直接拒绝新请求,客户端表现就是卡死、无响应。
调大这两个参数可以缓解问题,但根本解法还是做连接复用或水平扩容,把压力分摊到多台机器上。
跨地域访问的物理延迟
服务器在华东机房,用户在西北地区,数据往返一次就有几十毫秒的物理延迟,这部分是地理位置决定的,不属于故障,但可以靠CDN加速或就近接入节点来改善。
业内专家指出,PPC系统在多点调度场景下,控制端和中转节点相距过远时,时延会明显劣化操控体验,同城或同区域部署是更稳妥的选择。
配置和运维:把“不可用”的概率压下去
与其等故障发生再救火,不如提前规划配置和日常维护节奏。
ppc服务器配置要求高吗
这取决于同时跑多少任务,常规思路是8核16GB起步,若接入的终端数量较大,直接上16核32GB以上,硬盘优先选SSD,IO等待时间比机械盘少好几个档次,带宽方面,单机至少预留5Mbps上行,设备规模每增加一批,建议再叠加5Mbps。
预算有限的情况下,可以先用4核8GB做单机试点,租用价格上,4核8GB配置的云服务器月成本通常只有高性能配置的一半左右,但前提是系统盘和数据盘必须做分区隔离,避免日志写满系统盘导致整个服务挂掉。
日常维护的三件套
- 每周看一次系统日志 /var/log/messages,排查硬件报错和内核异常。
- 每月做一次资源趋势记录,对比CPU、内存、带宽使用率是涨是跌。
- 遇到内核或驱动更新,先在测试机验证再批量操作,不要直接在生产环境执行。
提前设置告警,别等问题暴露
在服务器上用 cron 每五分钟跑一个脚本,curl 检测本地服务端口返回码,连续两次异常就推送告警到企业微信或钉钉群,这样一来,故障发生时还处于内部消化阶段,用户基本无感知。
多地双活的朴素做法
条件允许时,在另一机房开一台配置略低的备用机,用Keepalived做VIP漂移,主服务器不可用时,备用机自动接管服务,故障恢复时间从小时级降到分钟级,行业共识认为,这种双机热备方案是中小规模PPC系统性价比最高的容灾手段。
一套完整排查耗时多久列个时间线
有经验的操作员按上述流程走一遍,常规故障约需10到15分钟定位。
- 0到2分钟:ping和telnet,判断网络层与端口层状态。
- 2到5分钟:登录服务器检查进程、负载和最近日志。
- 5到10分钟:核查防火墙、安全组和DNS解析,修正明显配置错误。
- 10到15分钟:仍未定位就抓包分析,或查看应用日志更深层报错。
超过15分钟还没找到原因,故障多半藏得很深,需要把应用日志完整导出,结合数据库慢查询SQL逐一验证。
ppc服务器不可用三个高频问题解答
Q1:ppc服务器重启后数据还在吗
只要没有手动清空磁盘,数据都会保留,重启不会丢失数据盘内容,真正需要关注的是异常断电可能造成的文件系统损坏,重启后用 fsck 检查文件系统完整性即可。
Q2:ppc服务器无法连接但能ping通是怎么回事
多半是端口被防火墙拦截或服务进程未启动,按上述五步排查法中的第二、第四步验证即可,也有一部分情况是服务器台设置了访问来源IP白名单,非白名单请求一律拒绝。
Q3:如何降低ppc服务器不可用的频率
维护层面做两条:一是每日定时巡检资源水位,二是每次变更配置前先备份原文件,运行层面做一条:避免让PPC服务与其他高负载业务混用同一台服务器,混用的后果往往是别人先耗尽CPU,你家服务被拖垮。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/785841.html